
MiDaS v3.1
midas-v3Intel MiDaS v3.1 relative depth-estimation model. Robust zero-shot single-image depth across diverse domains and resolutions.
- السعر
- ≈ 0.00030 US$/تشغيل
- Input → output
- نص + صورة → نص
- مطور
- Community
- تم التحديث
- 23 سبتمبر 2026
Playground
جرّب MiDaS v3.1
لا توجد نموذج إدخال
لا توجد نموذج إدخال لهذا النموذج حتى الآن
لم يتم توثيق مدخلاته بعد. حتى لا يفشل أي تشغيل على إدخال خاطئ، لا نقدم نموذجاً هنا. اختر نموذجاً مماثلاً بدلاً من ذلك.
Examples
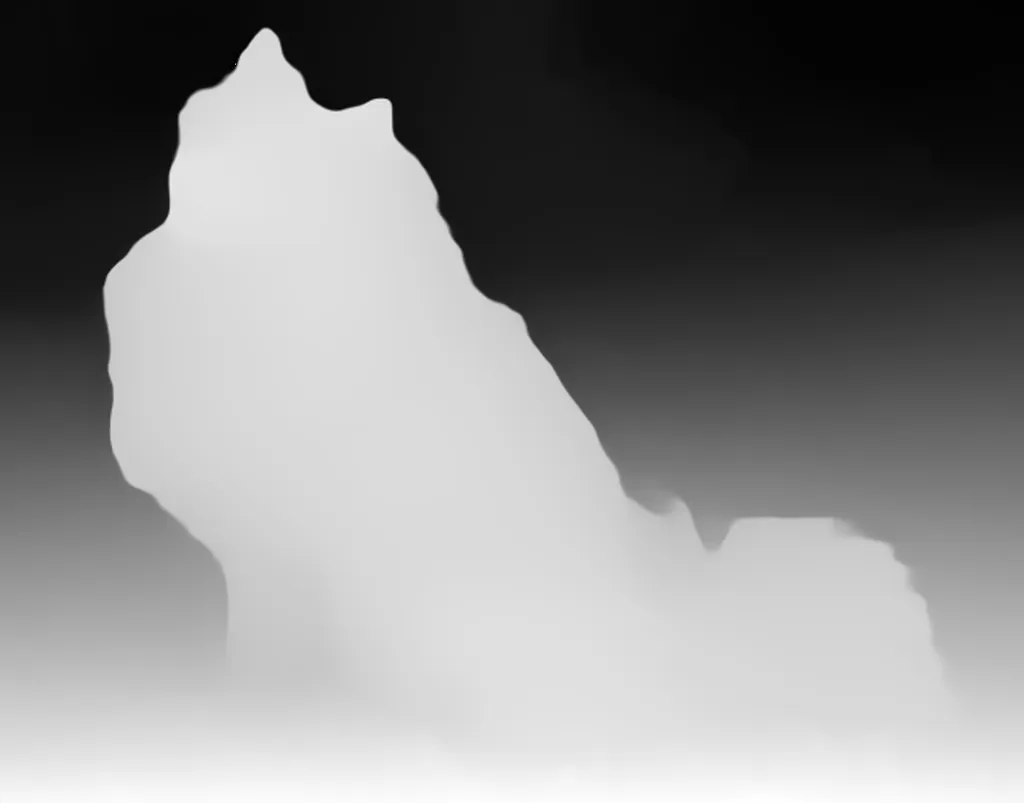 Open full size
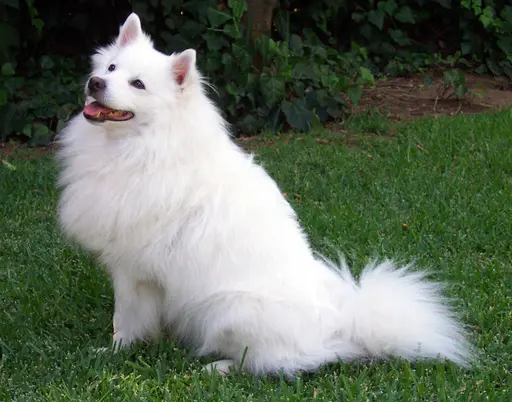 Input
No text prompt: the model only takes the input shown.
حول MiDaS v3.1
MiDaS v3.1 هو نموذج من Community في فئة متعدد الأنماط. على Railwail، يكلف MiDaS v3.1 ≈ 0.00030 US$ لكل تشغيل.
التسعير
| التشغيل النموذجي (≈ 1 ث على T4) | 0.00030 US$ لكل تشغيل |
|---|---|
| وقت GPU (T4) | 0.00027 US$ لكل ثانية GPU |
- يتم الفرز بناءً على وقت GPU الذي يستغرقه التشغيل فعلياً. عند بدء التشغيل، يتم حجز 3× السعر النموذجي من رصيدك ويتم تسويته لاحقاً.
- 1 رصيد = 0.01 US$
حاسبة التكلفة
حاسبة الأسعار
نموذجي وفقاً للمزود: حوالي 1 ث
الإجمالي
0.03 US$
3 رصيد
لكل تشغيل
0.0003 US$ · 0.03 رصيد
يتم الفرض بناءً على وقت GPU الفعلي؛ هذا تقدير.
API
لا يوجد مثال API موثق
API العام يمرر صيغة إدخال مختلفة عما يحتاجه هذا النموذج. استخدم ساحة الاختبار أعلاه.
المواصفات
- معرّف النموذج
midas-v3- مطور
- Community
- الفئة
- متعدد الأنماط
- الإدخال
- نص, صورة
- الإخراج
- نص
- الفواتير
- حسب الاستخدام (الرموز أو وقت GPU)
- تم تحديث إدخال الكتالوج
- 23 سبتمبر 2026
الوسوم
- replicate
- depth
- vision-understanding
- intel
- open-source
الأسئلة الشائعة
ما هو MiDaS v3.1؟
MiDaS v3.1 هو نموذج من Community في فئة متعدد الأنماط.
كم تكلفة MiDaS v3.1 على Railwail؟
على Railwail، يكلف MiDaS v3.1 ≈ 0.00030 US$ لكل تشغيل. يتم فرض رسوم عليك مقابل ما تستخدمه كل طلب فعلياً. الاستخدام يُدفع من أرصدة مدفوعة مقدماً؛ 1 رصيد يساوي 0.01 US$.
ما سرعة MiDaS v3.1؟
لا توجد عمليات تشغيل مقاسة كافية لـ MiDaS v3.1 على Railwail حتى الآن لتحديد وقت التشغيل. يعتمد على الإدخال والإعدادات والحمل لدى المزود.
هل MiDaS v3.1 أفضل من BLIP؟
هذا يعتمد على المهمة. MiDaS v3.1 (Community) و BLIP (Salesforce) كلاهما نموذج في فئة متعدد الأنماط. تعرض صفحة المقارنة أسعارهما والمواصفات جنباً إلى جنب.
قارن MiDaS v3.1 و BLIPهل يمكن لـ MiDaS v3.1 معالجة الصور؟
نعم. MiDaS v3.1 يقبل الصور كإدخال بالإضافة إلى النص.
نماذج قابلة للمقارنة
الكل في هذه الفئة- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
جميع النماذج عبر API واحدة
مفتاح API واحد لكل نموذج على Railwail. يتم احتساب الاستخدام من الأرصدة المدفوعة مقدماً، 1 رصيد = 0.01 US$.