
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Preis
- ca. $ 0,0012/Lauf
- Eingabe → Ausgabe
- Text + Bild → Text
- Entwickler
- Community
- Aktualisiert
- 23. September 2026
Playground
Florence-2 Large ausprobieren
Eingabe & Ergebnis
Dieser Lauf
ca. $ 0,0012 · 0,12 Credits
Beim Start werden $ 0,0036 (0,36 Credits) vorgemerkt, abgerechnet wird die tatsächliche GPU-Zeit.
Neu hier?
10 Gratis-Credits ($ 0,10) bei Anmeldung mit Google
Nutzbar 24 Stunden nach der Anmeldung, bis zu 5 Läufe pro Tag und höchstens 2 Credits je Lauf. Andere Anmeldearten starten ohne Guthaben. Reicht für 27 Läufe dieses Modells.
Beispiele
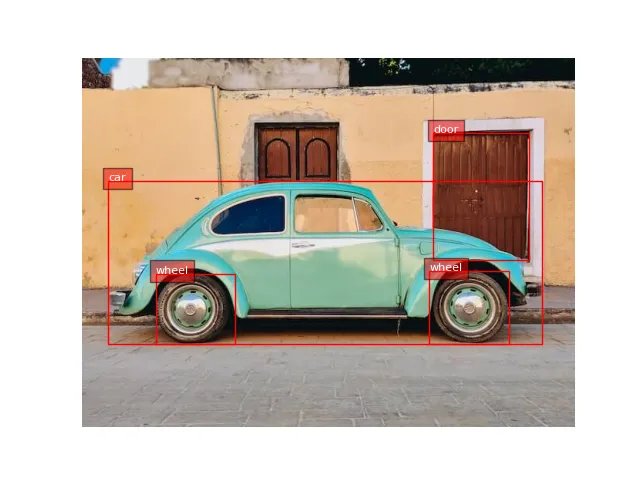 In voller Größe öffnen
 Eingabe
Kein Text-Prompt: Das Modell nimmt nur die gezeigte Eingabe.
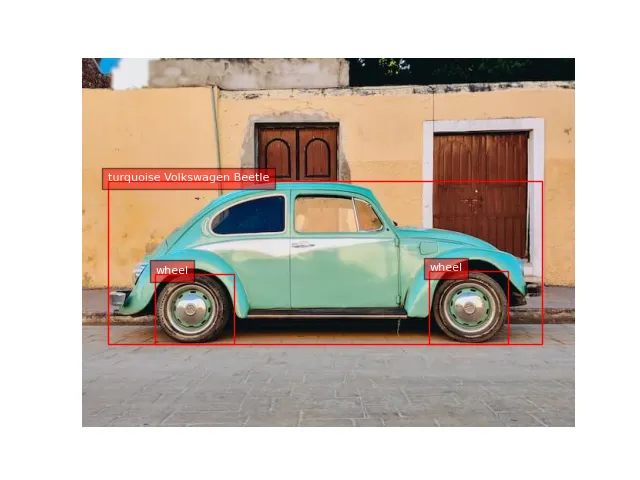 In voller Größe öffnen
 Eingabe
Kein Text-Prompt: Das Modell nimmt nur die gezeigte Eingabe.
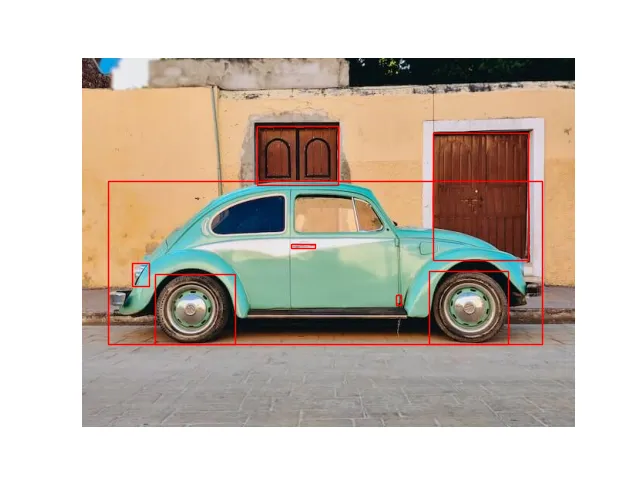 In voller Größe öffnen
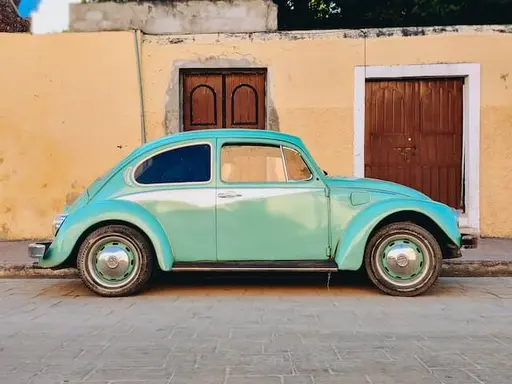 Eingabe
Kein Text-Prompt: Das Modell nimmt nur die gezeigte Eingabe.
Über Florence-2 Large
Florence-2 Large ist ein Modell von Community aus der Kategorie Multimodal. Über Railwail kostet Florence-2 Large ca. $ 0,0012 pro Lauf.
Preise
| Typischer Lauf (ca. 1 s auf L40S) | $ 0,0012 pro Lauf |
|---|---|
| GPU-Zeit (L40S) | $ 0,00117 pro GPU-Sekunde |
- Abgerechnet wird die GPU-Zeit, die der Lauf tatsächlich braucht. Beim Start wird das 3-Fache des typischen Preises vom Guthaben vorgemerkt und danach verrechnet.
- 1 Credit = $ 0,01
Kostenrechner
Preisrechner
Typisch laut Anbieter: ca. 1 s
Gesamt
$ 0,12
12 Credits
Je Lauf
$ 0,0012 · 0,12 Credits
Abgerechnet wird die tatsächliche GPU-Zeit; der Wert ist eine Schätzung.
API
Kein geprüftes API-Beispiel
Die öffentliche API übergibt ein anderes Eingabeformat, als dieses Modell braucht. Nutze den Playground oben.
Spezifikationen
- Modell-ID
florence-2-large- Entwickler
- Community
- Kategorie
- Multimodal
- Eingabe
- Text, Bild
- Ausgabe
- Text
- Abrechnung
- Nach Verbrauch (Token bzw. GPU-Zeit)
- Katalogeintrag aktualisiert
- 23. September 2026
Eingabeparameter
Eingaben und Einstellungen laut Eingabeschema des Modells. Welche davon die API annimmt, zeigt das Beispiel im Abschnitt API.
promptPflichtUser message or task instruction
Typ: TextStandard: –Erlaubte Werte: bis 4 000 ZeichentaskTyp: AuswahlStandard:captionErlaubte Werte: caption, detailed_caption, ocr, object_detection oder segmentationimage_urlImage URL to analyze
Typ: TextStandard: –Erlaubte Werte: –max_tokensTyp: GanzzahlStandard:1024Erlaubte Werte: 1 bis 4 096temperatureTyp: ZahlStandard:0.7Erlaubte Werte: 0 bis 2
Schlagwörter
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Häufige Fragen
Was ist Florence-2 Large?
Florence-2 Large ist ein Modell von Community aus der Kategorie Multimodal.
Was kostet Florence-2 Large bei Railwail?
Über Railwail kostet Florence-2 Large ca. $ 0,0012 pro Lauf. Abgerechnet wird, was jede Anfrage tatsächlich verbraucht. Bezahlt wird mit vorab gekauften Credits; 1 Credit entspricht $ 0,01.
Welche Einstellungen unterstützt Florence-2 Large?
Laut Eingabeschema kennt Florence-2 Large diese Parameter: prompt (bis 4 000 Zeichen), task (caption, detailed_caption, ocr, object_detection oder segmentation), image_url, max_tokens (1 bis 4 096) und temperature (0 bis 2).
Wie schnell ist Florence-2 Large?
Für Florence-2 Large gibt es bei Railwail noch zu wenige gemessene Läufe, um eine Laufzeit anzugeben. Sie hängt von der Eingabe, den Einstellungen und der Auslastung beim Anbieter ab.
Ist Florence-2 Large besser als BLIP?
Das hängt von der Aufgabe ab. Florence-2 Large (Community) und BLIP (Salesforce) sind beide Modelle aus der Kategorie Multimodal. Die Vergleichsseite zeigt Preise und Spezifikationen nebeneinander.
Florence-2 Large und BLIP vergleichenKann Florence-2 Large Bilder verarbeiten?
Ja. Florence-2 Large nimmt neben Text auch Bilder als Eingabe an.
Vergleichbare Modelle
Alle dieser Kategorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle Modelle über eine API
Ein API-Schlüssel für alle Modelle auf Railwail. Abgerechnet wird über vorab gekaufte Credits, 1 Credit = $ 0,01.