
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Цена
- ≈ 0,0114 щ.д./стартиране
- Контекст
- 8192 токена
- Макс. изход
- 2048 токена
- Вход → Изход
- Текст + Изображение → Текст
- Разработчик
- Community
- Актуализирано
- 23 септември 2026 г.
Playground
Опитай CogVLM2 19B
Няма входна форма
Все още няма входна форма за този модел
Неговите входове все още не са документирани. За да не се провали задача с неправилен вход, не предлагаме форма тук. Вместо това избери сравним модел.
Examples
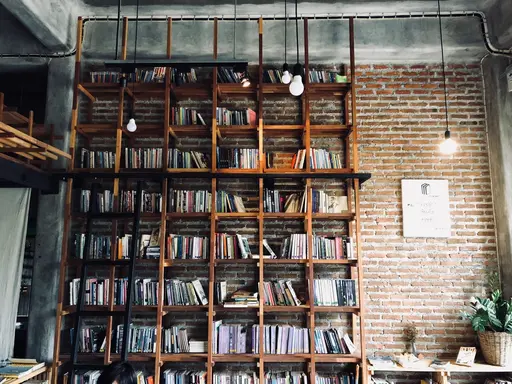 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
За CogVLM2 19B
CogVLM2 19B е модел на Community от категория Мултимодален. На Railwail CogVLM2 19B струва ≈ 0,0114 щ.д. за стартиране. Контекстното окно съдържа 8192 токена, а един отговор може да бъде до 2048 токена дълъг.
Цени
| Типично стартиране (≈ 10 s на L40S) | 0,0114 щ.д. за стартиране |
|---|---|
| GPU време (L40S) | 0,00117 щ.д. за GPU секунда |
- Таксува се по GPU времето, което стартирането действително отнема. При начало на стартирането 3× типичната цена се резервира от баланса ти и се уреждат впоследствие.
- 1 кредит = 0,01 щ.д.
Калкулатор на разходите
Калкулатор за цени
Типично според доставчика: около 9,7 s
Общо
1,14 щ.д.
114 кредита
На изпълнение
0,0114 щ.д. · 1,14 кредита
Начислява се действителното GPU време; това е оценка.
API
Няма проверен API пример
Публичният API предава различен входен формат, отколкото този модел нуждае. Използвайте playground по-горе.
Спецификации
- ID на модела
cogvlm2-19b- Разработчик
- Community
- Категория
- Мултимодален
- Вход
- Текст, Изображение
- Изход
- Текст
- Контекстен прозорец
- 8192 токена
- Макс. изход
- 2048 токена
- Таксуване
- По потребление (токени или GPU време)
- Каталогът е актуализиран
- 23 септември 2026 г.
Етикети
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Често задавани въпроси
Какво е CogVLM2 19B?
CogVLM2 19B е модел от Community в категория Мултимодален.
Колко струва CogVLM2 19B на Railwail?
На Railwail CogVLM2 19B струва ≈ 0,0114 щ.д. за стартиране. Таксуват се само ресурсите, които всяка заявка действително използва. Използването се плаща с предварително закупени кредити; 1 кредит е равен на 0,01 щ.д..
Какво е контекстното окно на CogVLM2 19B?
Контекстното окно на CogVLM2 19B съдържа 8192 токена. Един отговор може да бъде до 2048 токена дълъг.
Колко бърз е CogVLM2 19B?
Все още няма достатъчно измерени задачи на CogVLM2 19B на Railwail, за да се посочи време на изпълнение. Зависи от входа, настройките и натоварването на доставчика.
Е ли CogVLM2 19B по-добър от BLIP?
Зависи от задачата. CogVLM2 19B (Community) и BLIP (Salesforce) са и двата модела в категория Мултимодален. Страницата за сравнение показва техните цени и спецификации един до друг.
Сравни CogVLM2 19B и BLIPМоже ли CogVLM2 19B да обработва изображения?
Да. CogVLM2 19B приема изображения като вход в допълнение към текста.
Сравними модели
Всички в тази категория- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Всички модели чрез един API
Един API ключ за всеки модел на Railwail. Използването се начислява от предплатени кредити, 1 кредит = 0,01 щ.д..