
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Цена
- ≈ 0,0086 щ.д./стартиране
- Контекст
- 4096 токена
- Макс. изход
- 2048 токена
- Вход → Изход
- Текст + Изображение → Текст
- Разработчик
- DeepSeek
- Актуализирано
- 23 септември 2026 г.
Playground
Опитай DeepSeek-VL 7B
Няма входна форма
Все още няма входна форма за този модел
Неговите входове все още не са документирани. За да не се провали задача с неправилен вход, не предлагаме форма тук. Вместо това избери сравним модел.
Examples
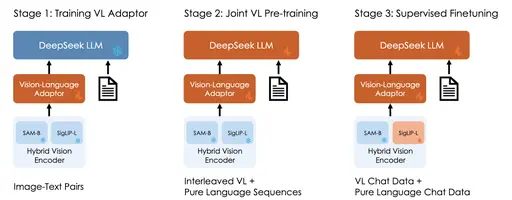 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
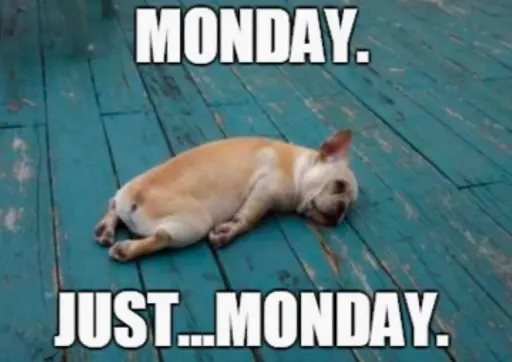 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
За DeepSeek-VL 7B
DeepSeek-VL 7B е модел на DeepSeek от категория Мултимодален. На Railwail DeepSeek-VL 7B струва ≈ 0,0086 щ.д. за стартиране. Контекстното окно съдържа 4096 токена, а един отговор може да бъде до 2048 токена дълъг.
Цени
| Типично стартиране (≈ 7 s на L40S) | 0,0086 щ.д. за стартиране |
|---|---|
| GPU време (L40S) | 0,00117 щ.д. за GPU секунда |
- Таксува се по GPU времето, което стартирането действително отнема. При начало на стартирането 3× типичната цена се резервира от баланса ти и се уреждат впоследствие.
- 1 кредит = 0,01 щ.д.
Калкулатор на разходите
Калкулатор за цени
Типично според доставчика: около 7,3 s
Общо
0,86 щ.д.
86 кредита
На изпълнение
0,0086 щ.д. · 0,86 кредита
Начислява се действителното GPU време; това е оценка.
API
Няма проверен API пример
Публичният API предава различен входен формат, отколкото този модел нуждае. Използвайте playground по-горе.
Спецификации
- ID на модела
deepseek-vl-7b- Разработчик
- DeepSeek
- Категория
- Мултимодален
- Вход
- Текст, Изображение
- Изход
- Текст
- Контекстен прозорец
- 4096 токена
- Макс. изход
- 2048 токена
- Таксуване
- По потребление (токени или GPU време)
- Каталогът е актуализиран
- 23 септември 2026 г.
Етикети
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Често задавани въпроси
Какво е DeepSeek-VL 7B?
DeepSeek-VL 7B е модел от DeepSeek в категория Мултимодален.
Колко струва DeepSeek-VL 7B на Railwail?
На Railwail DeepSeek-VL 7B струва ≈ 0,0086 щ.д. за стартиране. Таксуват се само ресурсите, които всяка заявка действително използва. Използването се плаща с предварително закупени кредити; 1 кредит е равен на 0,01 щ.д..
Какво е контекстното окно на DeepSeek-VL 7B?
Контекстното окно на DeepSeek-VL 7B съдържа 4096 токена. Един отговор може да бъде до 2048 токена дълъг.
Колко бърз е DeepSeek-VL 7B?
Все още няма достатъчно измерени задачи на DeepSeek-VL 7B на Railwail, за да се посочи време на изпълнение. Зависи от входа, настройките и натоварването на доставчика.
Е ли DeepSeek-VL 7B по-добър от BLIP?
Зависи от задачата. DeepSeek-VL 7B (DeepSeek) и BLIP (Salesforce) са и двата модела в категория Мултимодален. Страницата за сравнение показва техните цени и спецификации един до друг.
Сравни DeepSeek-VL 7B и BLIPМоже ли DeepSeek-VL 7B да обработва изображения?
Да. DeepSeek-VL 7B приема изображения като вход в допълнение към текста.
Сравними модели
Всички в тази категория- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Всички модели чрез един API
Един API ключ за всеки модел на Railwail. Използването се начислява от предплатени кредити, 1 кредит = 0,01 щ.д..