
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Preis
- ca. $ 0.0086/Lauf
- Kontext
- 4'096 Token
- Max. Ausgabe
- 2'048 Token
- Eingabe → Ausgabe
- Text + Bild → Text
- Entwickler
- DeepSeek
- Aktualisiert
- 23. September 2026
Playground
DeepSeek-VL 7B ausprobieren
Keine Eingabemaske
Für dieses Modell ist noch keine Eingabemaske hinterlegt
Seine Eingaben sind noch nicht erfasst. Damit kein Lauf an einer falschen Eingabe scheitert, bieten wir hier kein Formular an. Wähle stattdessen ein vergleichbares Modell.
Beispiele
 Eingabe
Prompt
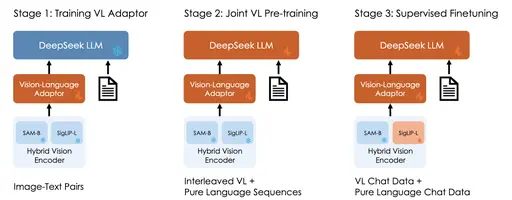
Describe each stage of this image
Antwort
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Eingabe
Prompt
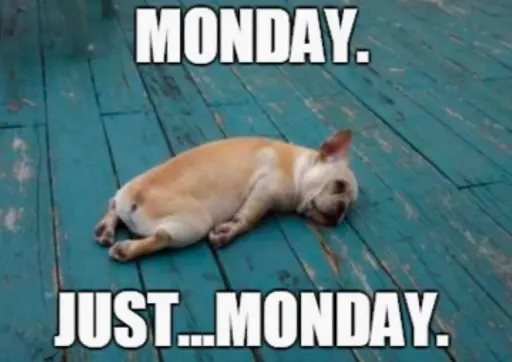
Describe this image
Antwort
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Über DeepSeek-VL 7B
DeepSeek-VL 7B ist ein Modell von DeepSeek aus der Kategorie Multimodal. Über Railwail kostet DeepSeek-VL 7B ca. $ 0.0086 pro Lauf. Das Kontextfenster umfasst 4'096 Token, eine Antwort bis zu 2'048 Token.
Preise
| Typischer Lauf (ca. 7 s auf L40S) | $ 0.0086 pro Lauf |
|---|---|
| GPU-Zeit (L40S) | $ 0.00117 pro GPU-Sekunde |
- Abgerechnet wird die GPU-Zeit, die der Lauf tatsächlich braucht. Beim Start wird das 3-Fache des typischen Preises vom Guthaben vorgemerkt und danach verrechnet.
- 1 Credit = $ 0.01
Kostenrechner
Preisrechner
Typisch laut Anbieter: ca. 7.3 s
Gesamt
$ 0.86
86 Credits
Je Lauf
$ 0.0086 · 0.86 Credits
Abgerechnet wird die tatsächliche GPU-Zeit; der Wert ist eine Schätzung.
API
Kein geprüftes API-Beispiel
Die öffentliche API übergibt ein anderes Eingabeformat, als dieses Modell braucht. Nutze den Playground oben.
Spezifikationen
- Modell-ID
deepseek-vl-7b- Entwickler
- DeepSeek
- Kategorie
- Multimodal
- Eingabe
- Text, Bild
- Ausgabe
- Text
- Kontextfenster
- 4'096 Token
- Max. Ausgabe
- 2'048 Token
- Abrechnung
- Nach Verbrauch (Token bzw. GPU-Zeit)
- Katalogeintrag aktualisiert
- 23. September 2026
Schlagwörter
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Häufige Fragen
Was ist DeepSeek-VL 7B?
DeepSeek-VL 7B ist ein Modell von DeepSeek aus der Kategorie Multimodal.
Was kostet DeepSeek-VL 7B bei Railwail?
Über Railwail kostet DeepSeek-VL 7B ca. $ 0.0086 pro Lauf. Abgerechnet wird, was jede Anfrage tatsächlich verbraucht. Bezahlt wird mit vorab gekauften Credits; 1 Credit entspricht $ 0.01.
Wie gross ist das Kontextfenster von DeepSeek-VL 7B?
Das Kontextfenster von DeepSeek-VL 7B umfasst 4'096 Token. Eine Antwort kann bis zu 2'048 Token lang sein.
Wie schnell ist DeepSeek-VL 7B?
Für DeepSeek-VL 7B gibt es bei Railwail noch zu wenige gemessene Läufe, um eine Laufzeit anzugeben. Sie hängt von der Eingabe, den Einstellungen und der Auslastung beim Anbieter ab.
Ist DeepSeek-VL 7B besser als BLIP?
Das hängt von der Aufgabe ab. DeepSeek-VL 7B (DeepSeek) und BLIP (Salesforce) sind beide Modelle aus der Kategorie Multimodal. Die Vergleichsseite zeigt Preise und Spezifikationen nebeneinander.
DeepSeek-VL 7B und BLIP vergleichenKann DeepSeek-VL 7B Bilder verarbeiten?
Ja. DeepSeek-VL 7B nimmt neben Text auch Bilder als Eingabe an.
Vergleichbare Modelle
Alle dieser Kategorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle Modelle über eine API
Ein API-Schlüssel für alle Modelle auf Railwail. Abgerechnet wird über vorab gekaufte Credits, 1 Credit = $ 0.01.