
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cena
- ≈ 0,0012 US$/spuštění
- Vstup → výstup
- Text + Obrázek → Text
- Vývojář
- Community
- Aktualizováno
- 23. září 2026
Playground
Vyzkoušet Florence-2 Large
Vstup a výstup
Tento běh
přibližně 0,0012 US$ · 0,12 credits
Na začátku se rezervuje 0,0036 US$ (0,36 credits), fakturuje se skutečný čas GPU.
Nový zde?
10 bezplatných credits (0,10 US$) při registraci přes Google
Použitelné 24 hodin po registraci, až 5 běhů za den a maximálně 2 credits za běh. Ostatní způsoby přihlášení začínají bez credits. Stačí na 27 spuštění tohoto modelu.
Examples
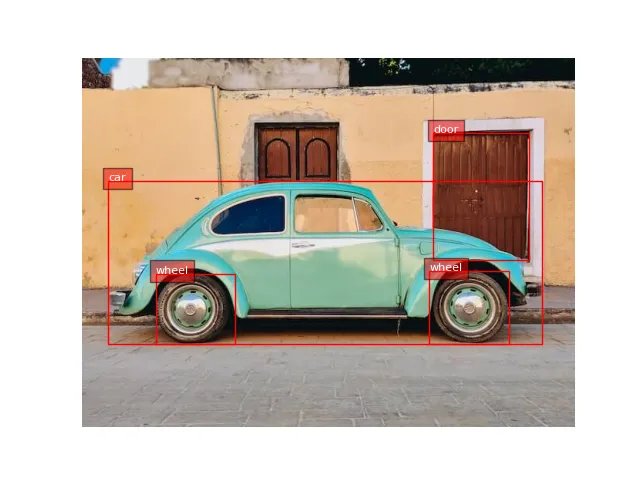 Open full size
 Input
No text prompt: the model only takes the input shown.
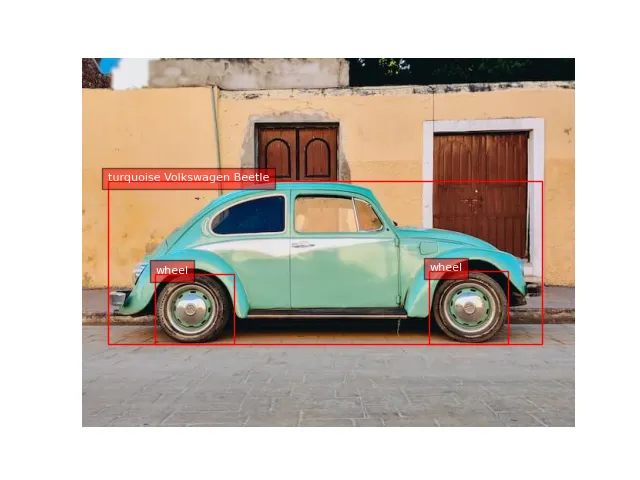 Open full size
 Input
No text prompt: the model only takes the input shown.
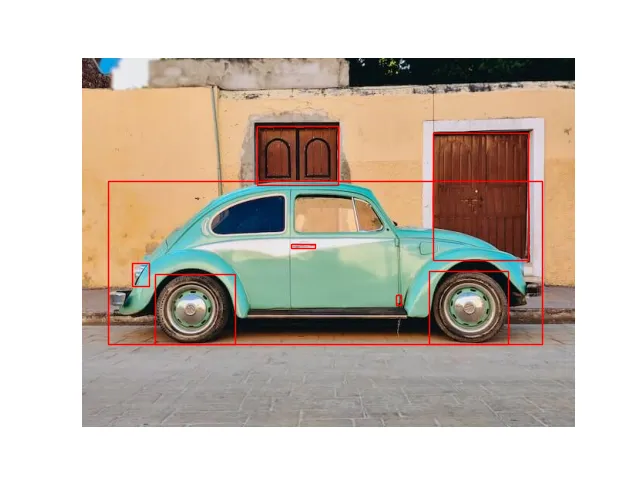 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Large
Florence-2 Large je model od Community v kategorii Multimodální. Na Railwail stojí Florence-2 Large ≈ 0,0012 US$ za spuštění.
Ceny
| Typické spuštění (≈ 1 s na L40S) | 0,0012 US$ za spuštění |
|---|---|
| GPU čas (L40S) | 0,00117 US$ za GPU sekundu |
- Účtuje se GPU čas, který spuštění skutečně trvá. Při spuštění je z vašeho zůstatku rezervováno 3× typická cena a později se vypořádá.
- 1 kredit = 0,01 US$
Kalkulátor nákladů
Kalkulátor cen
Typicky podle poskytovatele: přibližně 1 s
Celkem
0,12 US$
12 kreditů
Na spuštění
0,0012 US$ · 0,12 kreditů
Účtuje se skutečný čas GPU; jedná se o odhad.
API
Žádný ověřený příklad API
Veřejné API předává jiný formát vstupu, než tento model potřebuje. Použijte playground výše.
Specifikace
- ID modelu
florence-2-large- Vývojář
- Community
- Kategorie
- Multimodální
- Vstup
- Text, Obrázek
- Výstup
- Text
- Fakturace
- Podle použití (tokeny nebo GPU čas)
- Záznam v katalogu aktualizován
- 23. září 2026
Vstupní parametry
Vstupy a nastavení ze vstupního schématu modelu. Příklad v sekci API ukazuje, které z nich API přijímá.
promptpovinnéUser message or task instruction
Typ: TextVýchozí: –Povolené hodnoty: až 4 000 znakůtaskTyp: VolbaVýchozí:captionPovolené hodnoty: caption, detailed_caption, ocr, object_detection nebo segmentationimage_urlImage URL to analyze
Typ: TextVýchozí: –Povolené hodnoty: –max_tokensTyp: Celé čísloVýchozí:1024Povolené hodnoty: 1 až 4 096temperatureTyp: ČísloVýchozí:0.7Povolené hodnoty: 0 až 2
Štítky
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Často kladené otázky
Co je Florence-2 Large?
Florence-2 Large je model od Community v kategorii Multimodální.
Kolik stojí Florence-2 Large na Railwail?
Na Railwail stojí Florence-2 Large ≈ 0,0012 US$ za spuštění. Platíte za to, co každý požadavek skutečně spotřebuje. Použití se platí z předplacených kreditů; 1 kredit se rovná 0,01 US$.
Jaká nastavení Florence-2 Large podporuje?
Podle schématu vstupu Florence-2 Large zná tyto parametry: prompt (až 4 000 znaků), task (caption, detailed_caption, ocr, object_detection nebo segmentation), image_url, max_tokens (1 až 4 096) a temperature (0 až 2).
Jak rychlý je Florence-2 Large?
Pro Florence-2 Large je na Railwail zatím příliš málo naměřených spuštění na uvedení doby běhu. Závisí na vstupu, nastavení a zátěži u poskytovatele.
Je Florence-2 Large lepší než BLIP?
Záleží na úkolu. Florence-2 Large (Community) a BLIP (Salesforce) jsou oba modely v kategorii Multimodální. Stránka porovnání zobrazuje jejich ceny a specifikace vedle sebe.
Porovnat Florence-2 Large a BLIPMůže Florence-2 Large zpracovávat obrázky?
Ano. Florence-2 Large přijímá obrázky jako vstup kromě textu.
Srovnatelné modely
Všechny v této kategorii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Všechny modely přes jednu API
Jeden API klíč pro všechny modely na Railwail. Použití se účtuje z předplacených kreditů, 1 kredit = 0,01 US$.