
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Cena
- ≈ 0,0012 US$/spuštění
- Vstup → výstup
- Text + Obrázek → Text
- Vývojář
- Community
- Aktualizováno
- 23. září 2026
Playground
Vyzkoušet Florence-2 Segmentation
Žádný formulář vstupu
Pro tento model zatím není formulář vstupu
Jeho vstupy nejsou zatím zdokumentovány. Aby se žádné spuštění neprovádělo s chybným vstupem, zde nenabízíme formulář. Místo toho si vyberte srovnatelný model.
Examples
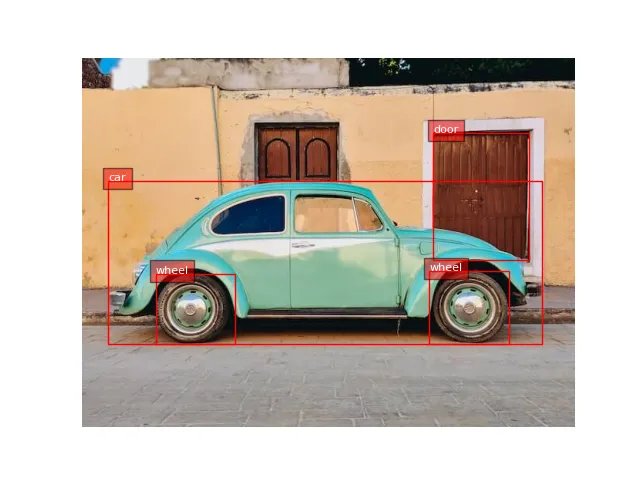 Open full size
 Input
No text prompt: the model only takes the input shown.
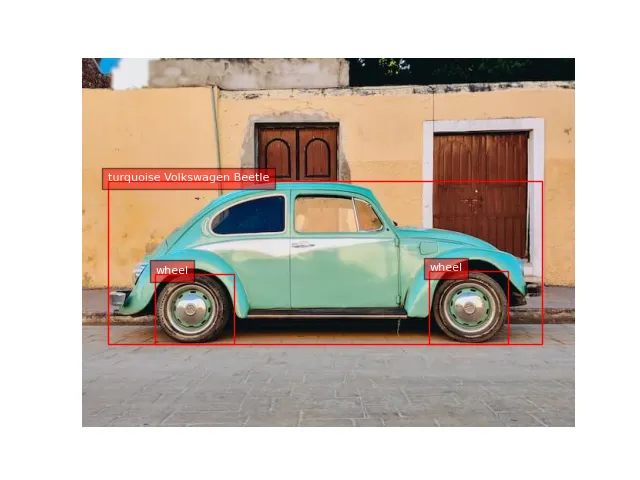 Open full size
 Input
No text prompt: the model only takes the input shown.
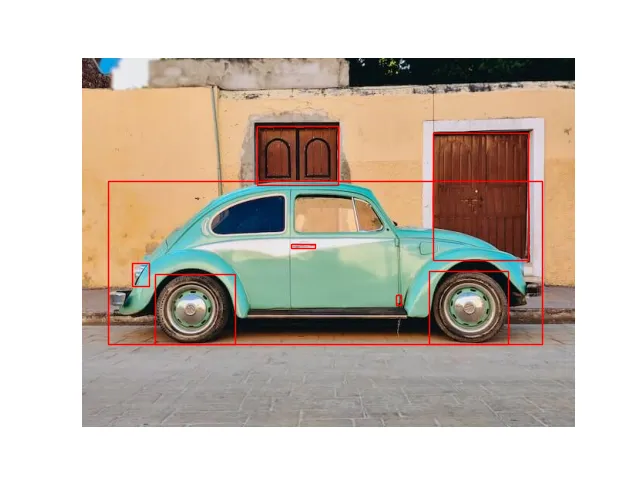 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Segmentation
Florence-2 Segmentation je model od Community v kategorii Multimodální. Na Railwail stojí Florence-2 Segmentation ≈ 0,0012 US$ za spuštění.
Ceny
| Typické spuštění (≈ 1 s na L40S) | 0,0012 US$ za spuštění |
|---|---|
| GPU čas (L40S) | 0,00117 US$ za GPU sekundu |
- Účtuje se GPU čas, který spuštění skutečně trvá. Při spuštění je z vašeho zůstatku rezervováno 3× typická cena a později se vypořádá.
- 1 kredit = 0,01 US$
Kalkulátor nákladů
Kalkulátor cen
Typicky podle poskytovatele: přibližně 1 s
Celkem
0,12 US$
12 kreditů
Na spuštění
0,0012 US$ · 0,12 kreditů
Účtuje se skutečný čas GPU; jedná se o odhad.
API
Žádný ověřený příklad API
Veřejné API předává jiný formát vstupu, než tento model potřebuje. Použijte playground výše.
Specifikace
- ID modelu
florence-2-segmentation- Vývojář
- Community
- Kategorie
- Multimodální
- Vstup
- Text, Obrázek
- Výstup
- Text
- Fakturace
- Podle použití (tokeny nebo GPU čas)
- Záznam v katalogu aktualizován
- 23. září 2026
Štítky
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Často kladené otázky
Co je Florence-2 Segmentation?
Florence-2 Segmentation je model od Community v kategorii Multimodální.
Kolik stojí Florence-2 Segmentation na Railwail?
Na Railwail stojí Florence-2 Segmentation ≈ 0,0012 US$ za spuštění. Platíte za to, co každý požadavek skutečně spotřebuje. Použití se platí z předplacených kreditů; 1 kredit se rovná 0,01 US$.
Jak rychlý je Florence-2 Segmentation?
Pro Florence-2 Segmentation je na Railwail zatím příliš málo naměřených spuštění na uvedení doby běhu. Závisí na vstupu, nastavení a zátěži u poskytovatele.
Je Florence-2 Segmentation lepší než BLIP?
Záleží na úkolu. Florence-2 Segmentation (Community) a BLIP (Salesforce) jsou oba modely v kategorii Multimodální. Stránka porovnání zobrazuje jejich ceny a specifikace vedle sebe.
Porovnat Florence-2 Segmentation a BLIPMůže Florence-2 Segmentation zpracovávat obrázky?
Ano. Florence-2 Segmentation přijímá obrázky jako vstup kromě textu.
Srovnatelné modely
Všechny v této kategorii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Všechny modely přes jednu API
Jeden API klíč pro všechny modely na Railwail. Použití se účtuje z předplacených kreditů, 1 kredit = 0,01 US$.