
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Pris
- ≈ 0,0086 US$/kørsel
- Kontekst
- 4.096 tokens
- Maks. output
- 2.048 tokens
- Input → output
- Tekst + Billede → Tekst
- Udvikler
- DeepSeek
- Opdateret
- 23. september 2026
Playground
Prøv DeepSeek-VL 7B
Ingen inputmaske
Ingen inputmaske til denne model endnu
Dens inputs er endnu ikke dokumenteret. For at ingen kørsel mislykkes på grund af forkert input tilbyder vi ikke en formular her. Vælg i stedet en sammenlignelig model.
Examples
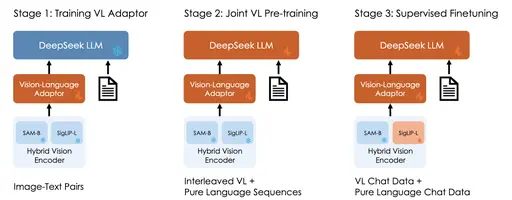 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
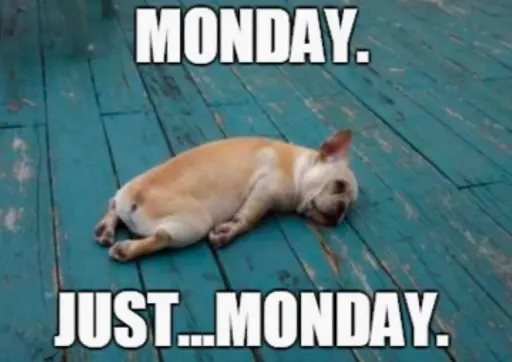 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Om DeepSeek-VL 7B
DeepSeek-VL 7B er en model af DeepSeek i kategorien Multimodal. På Railwail koster DeepSeek-VL 7B ≈ 0,0086 US$ pr. kørsel. Kontekstvinduet indeholder 4.096 tokens, og et svar kan være op til 2.048 tokens langt.
Priser
| Typisk kørsel (≈ 7 s på L40S) | 0,0086 US$ pr. kørsel |
|---|---|
| GPU-tid (L40S) | 0,00117 US$ pr. GPU-sekund |
- Faktureres efter den GPU-tid, som kørslen faktisk tager. Når kørslen starter, reserveres 3× den typiske pris fra din saldo og afregnes efterfølgende.
- 1 kredit = 0,01 US$
Omkostningsberegner
Prisberegner
Typisk ifølge udbyderen: ca. 7,3 s
I alt
0,86 US$
86 credits
Pr. kørsel
0,0086 US$ · 0,86 credits
Fakturering efter faktisk GPU-tid; dette er et estimat.
API
Intet bekræftet API-eksempel
Den offentlige API sender et andet inputformat end det, som denne model har brug for. Brug playground ovenfor.
Specifikationer
- Model-ID
deepseek-vl-7b- Udvikler
- DeepSeek
- Kategori
- Multimodal
- Input
- Tekst, Billede
- Output
- Tekst
- Kontekstvindue
- 4.096 tokens
- Maks. output
- 2.048 tokens
- Fakturering
- Efter forbrug (tokens eller GPU-tid)
- Katalogelement opdateret
- 23. september 2026
Tags
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Ofte stillede spørgsmål
Hvad er DeepSeek-VL 7B?
DeepSeek-VL 7B er en model fra DeepSeek i kategorien Multimodal.
Hvad koster DeepSeek-VL 7B på Railwail?
På Railwail koster DeepSeek-VL 7B ≈ 0,0086 US$ pr. kørsel. Du betaler for det, som hver anmodning faktisk bruger. Forbrug betales fra forudbetalte credits; 1 credit svarer til 0,01 US$.
Hvad er kontekstvinduet for DeepSeek-VL 7B?
Kontekstvinduet for DeepSeek-VL 7B indeholder 4.096 tokens. Et svar kan være op til 2.048 tokens langt.
Hvor hurtig er DeepSeek-VL 7B?
Der er endnu ikke nok målte kørsler af DeepSeek-VL 7B på Railwail til at angive en udførelsestid. Det afhænger af inputtet, indstillingerne og belastningen hos provideren.
Er DeepSeek-VL 7B bedre end BLIP?
Det afhænger af opgaven. DeepSeek-VL 7B (DeepSeek) og BLIP (Salesforce) er begge modeller i kategorien Multimodal. Sammenligningssiden viser deres priser og specifikationer side om side.
Sammenlign DeepSeek-VL 7B og BLIPKan DeepSeek-VL 7B behandle billeder?
Ja. DeepSeek-VL 7B accepterer billeder som input ud over tekst.
Sammenlignelige modeller
Alle i denne kategori- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modeller via én API
En API-nøgle til alle modeller på Railwail. Forbrug debiteres fra forudbetalte credits, 1 credit = 0,01 US$.