
Mask2Former
mask2formerMeta Mask2Former universal image-segmentation transformer. Single architecture for panoptic, instance and semantic segmentation tasks.
- Pris
- ≈ 0,0276 US$/kørsel
- Input → output
- Tekst + Billede → Tekst
- Udvikler
- Meta
- Opdateret
- 23. september 2026
Playground
Prøv Mask2Former
Ingen inputmaske
Ingen inputmaske til denne model endnu
Dens inputs er endnu ikke dokumenteret. For at ingen kørsel mislykkes på grund af forkert input tilbyder vi ikke en formular her. Vælg i stedet en sammenlignelig model.
Examples
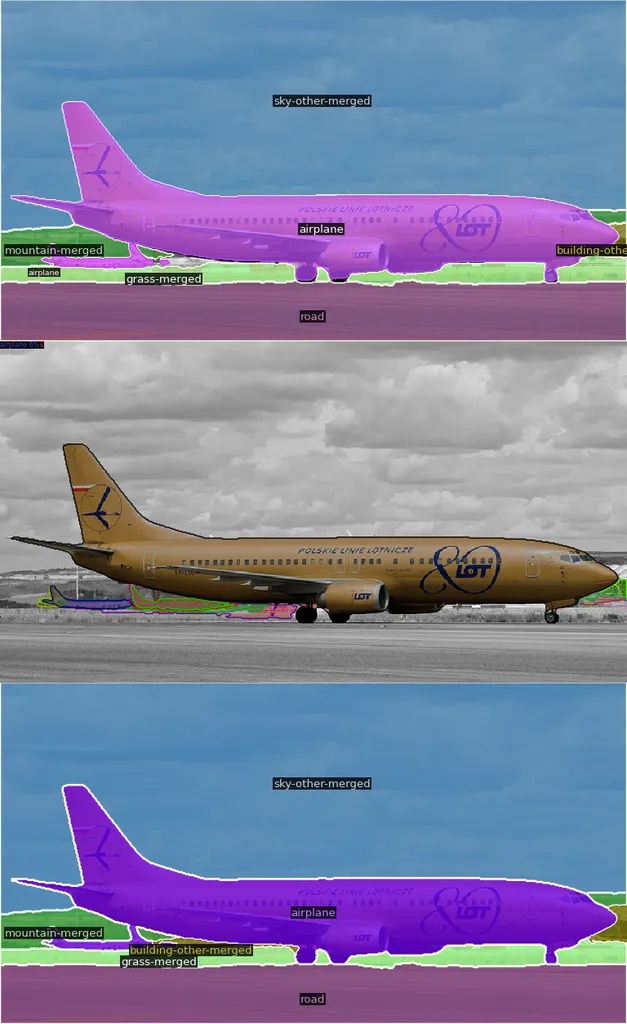 Open full size
 Input
No text prompt: the model only takes the input shown.
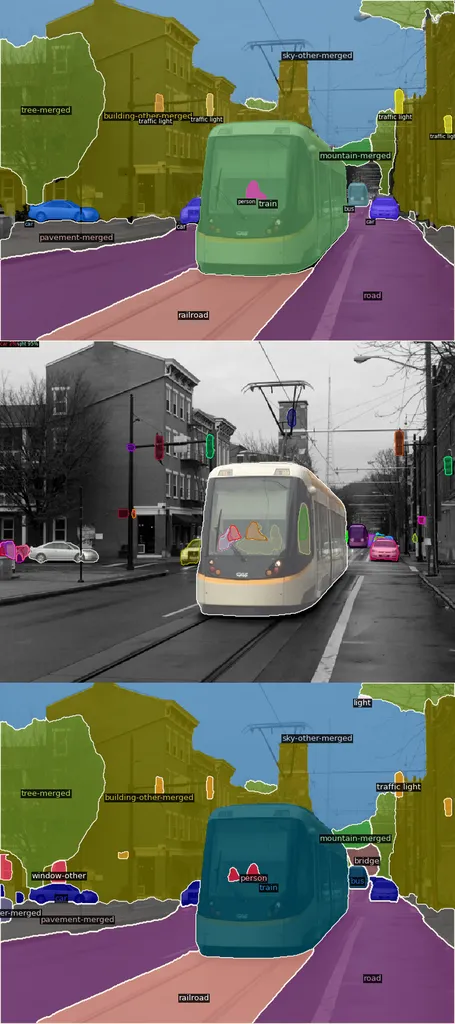 Open full size
 Input
No text prompt: the model only takes the input shown.
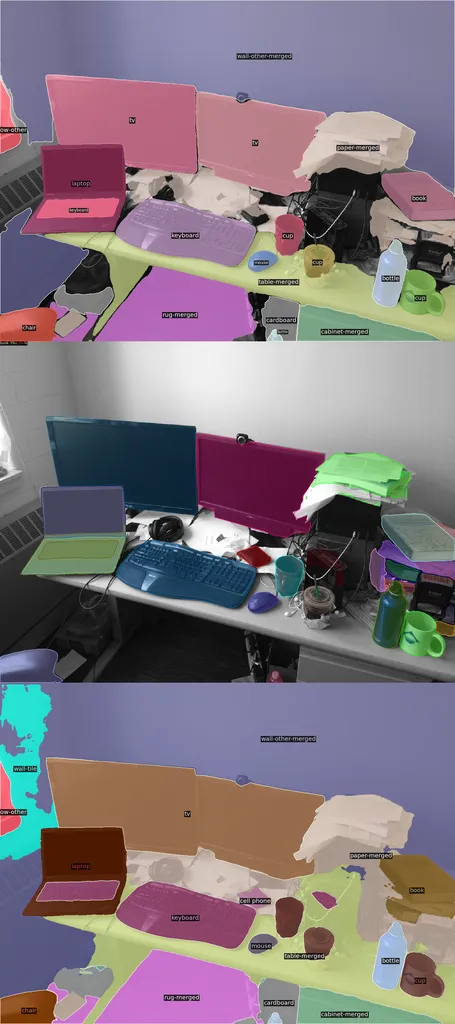 Open full size
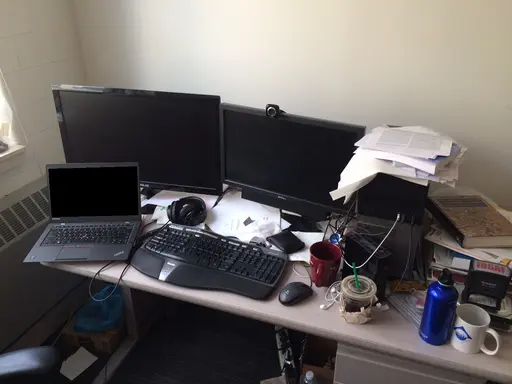 Input
No text prompt: the model only takes the input shown.
Om Mask2Former
Mask2Former er en model af Meta i kategorien Multimodal. På Railwail koster Mask2Former ≈ 0,0276 US$ pr. kørsel.
Priser
| Typisk kørsel (≈ 102 s på T4) | 0,0276 US$ pr. kørsel |
|---|---|
| GPU-tid (T4) | 0,00027 US$ pr. GPU-sekund |
- Faktureres efter den GPU-tid, som kørslen faktisk tager. Når kørslen starter, reserveres 3× den typiske pris fra din saldo og afregnes efterfølgende.
- 1 kredit = 0,01 US$
Omkostningsberegner
Prisberegner
Typisk ifølge udbyderen: ca. 102,2 s
I alt
2,76 US$
276 credits
Pr. kørsel
0,0276 US$ · 2,76 credits
Fakturering efter faktisk GPU-tid; dette er et estimat.
API
Intet bekræftet API-eksempel
Den offentlige API sender et andet inputformat end det, som denne model har brug for. Brug playground ovenfor.
Specifikationer
- Model-ID
mask2former- Udvikler
- Meta
- Kategori
- Multimodal
- Input
- Tekst, Billede
- Output
- Tekst
- Fakturering
- Efter forbrug (tokens eller GPU-tid)
- Katalogelement opdateret
- 23. september 2026
Tags
- replicate
- segmentation
- vision-understanding
- transformer
- meta
Ofte stillede spørgsmål
Hvad er Mask2Former?
Mask2Former er en model fra Meta i kategorien Multimodal.
Hvad koster Mask2Former på Railwail?
På Railwail koster Mask2Former ≈ 0,0276 US$ pr. kørsel. Du betaler for det, som hver anmodning faktisk bruger. Forbrug betales fra forudbetalte credits; 1 credit svarer til 0,01 US$.
Hvor hurtig er Mask2Former?
Der er endnu ikke nok målte kørsler af Mask2Former på Railwail til at angive en udførelsestid. Det afhænger af inputtet, indstillingerne og belastningen hos provideren.
Er Mask2Former bedre end BLIP?
Det afhænger af opgaven. Mask2Former (Meta) og BLIP (Salesforce) er begge modeller i kategorien Multimodal. Sammenligningssiden viser deres priser og specifikationer side om side.
Sammenlign Mask2Former og BLIPKan Mask2Former behandle billeder?
Ja. Mask2Former accepterer billeder som input ud over tekst.
Sammenlignelige modeller
Alle i denne kategori- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modeller via én API
En API-nøgle til alle modeller på Railwail. Forbrug debiteres fra forudbetalte credits, 1 credit = 0,01 US$.