
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Hind
- ≈ 0,0086 $/käivitus
- Kontekst
- 4096 tokenit
- Maks. väljund
- 2048 tokenit
- Sisend → väljund
- Tekst + Pilt → Tekst
- Arendaja
- DeepSeek
- Uuendatud
- 23. september 2026
Playground
Proovi DeepSeek-VL 7B
Sisendvorm puudub
Selle mudeli jaoks pole veel sisendvormi
Selle sisendid pole veel dokumenteeritud. Et käivitus ei ebaõnnestunuks vale sisendi tõttu, ei paku me siin vormi. Vali selle asemel sarnane mudel.
Examples
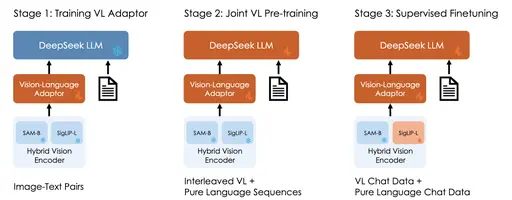 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
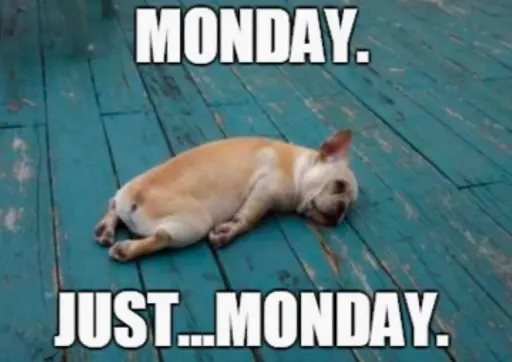 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Teave: DeepSeek-VL 7B
DeepSeek-VL 7B on mudel, mille on välja töötanud DeepSeek kategoorias Multimodaalne. Railwail'is maksab DeepSeek-VL 7B ≈ 0,0086 $ käivituse kohta. Konteksti aken sisaldab 4096 märksõna ja üks vastus võib olla kuni 2048 märksõna pikkune.
Hinnad
| Tüüpiline käivitus (≈ 7 s L40S peal) | 0,0086 $ käivituse kohta |
|---|---|
| GPU-aeg (L40S) | 0,00117 $ GPU-sekundi kohta |
- Arvestatakse GPU-aeg, mida käivitus tegelikult võtab. Käivituse alustamisel reserveeritakse sinu saldost 3× tüüpiline hind ja arvutatakse hiljem.
- 1 krediit = 0,01 $
Kulukalkulaator
Hinna kalkulaator
Pakkuja andmetel tüüpiline: umbes 7,3 s
Kokku
0,86 $
86 krediiti
Käivituse kohta
0,0086 $ · 0,86 krediiti
Arvestatakse tegelik GPU-aeg; see on hinnang.
API
Kontrollitud API-näide puudub
Avalik API edastab teistsuguse sisendvormingu, kui see mudel vajab. Kasuta ülalolevat mänguväljakut.
Spetsifikatsioonid
- Mudeli ID
deepseek-vl-7b- Arendaja
- DeepSeek
- Kategooria
- Multimodaalne
- Sisend
- Tekst, Pilt
- Väljund
- Tekst
- Konteksti aken
- 4096 tokenit
- Maks. väljund
- 2048 tokenit
- Arveldamine
- Kasutuse järgi (tokenid või GPU-aeg)
- Kataloogi kirje uuendatud
- 23. september 2026
Sildid
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Korduma kippuvad küsimused
Mis on DeepSeek-VL 7B?
DeepSeek-VL 7B on mudel, mille töötas välja DeepSeek kategoorias Multimodaalne.
Kui palju maksab DeepSeek-VL 7B Railwail'is?
Railwail'is maksab DeepSeek-VL 7B ≈ 0,0086 $ käivituse kohta. Sulle arvestatakse see, mida iga päring tegelikult kasutab. Kasutamine makstakse eelnevalt ostetud krediitidest; 1 krediit võrdub 0,01 $.
Kui suur on DeepSeek-VL 7B konteksti aken?
DeepSeek-VL 7B konteksti aken sisaldab 4096 märksõna. Üks vastus võib olla kuni 2048 märksõna pikkune.
Kui kiire on DeepSeek-VL 7B?
DeepSeek-VL 7B kohta ei ole Railwail'is veel piisavalt mõõdetud käivitusi, et käivitusaega väita. See sõltub sisendist, seadistustest ja pakkuja koormusest.
Kas DeepSeek-VL 7B on parem kui BLIP?
See sõltub ülesandest. DeepSeek-VL 7B (DeepSeek) ja BLIP (Salesforce) on mõlemad mudelid kategoorias Multimodaalne. Võrdlusleht näitab nende hindu ja spetsifikatsioone kõrvuti.
Võrdle DeepSeek-VL 7B ja BLIPKas DeepSeek-VL 7B saab töödelda pilte?
Jah. DeepSeek-VL 7B aktsepteerib sisendina teksti kõrval ka pilte.
Võrreldavad mudelid
Kõik selles kategoorias- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Kõik mudelid ühe API kaudu
Üks API võti kõigile Railwail mudelitele. Kasutamine arvestatakse eelmakstud krediitidest, 1 krediit = 0,01 $.