
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Hinta
- ≈ 0,0114 $/suoritus
- Konteksti
- 8 192 tokenia
- Enint. tuloste
- 2 048 tokenia
- Syöte → tulos
- Teksti + Kuva → Teksti
- Kehittäjä
- Community
- Päivitetty
- 23. syyskuuta 2026
Leikkikenttä
Kokeile CogVLM2 19B
Ei syötelomaketta
Tälle mallille ei ole vielä syötelomaketta
Sen syötteet eivät ole vielä dokumentoituja. Jotta mikään suoritus ei epäonnistuisi väärän syötteen vuoksi, emme tarjoa lomaketta täällä. Valitse sen sijaan vertailukelpoinen malli.
Examples
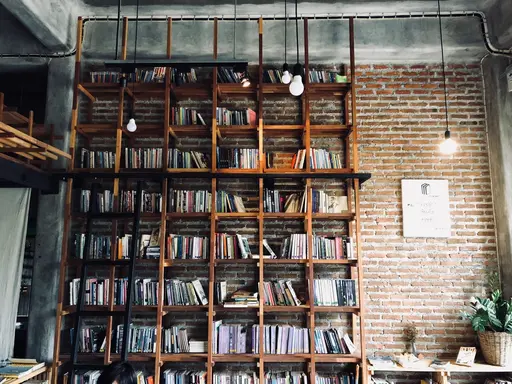 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
Tietoja: CogVLM2 19B
CogVLM2 19B on Community-kehittäjän malli kategoriasta Multimodaali. Railwailissa CogVLM2 19B maksaa ≈ 0,0114 $ per suoritus. Kontekstiikkuna sisältää 8 192 tokenia, ja vastaus voi olla enintään 2 048 tokenia pitkä.
Hinnat
| Tyypillinen suoritus (≈ 10 s L40S:lla) | 0,0114 $ per suoritus |
|---|---|
| GPU-aika (L40S) | 0,00117 $ per GPU-sekunti |
- Laskutus perustuu suorituksen todelliseen GPU-aikaan. Kun suoritus alkaa, 3-kertainen tyypillinen hinta varataan saldostasi ja selvitetään jälkikäteen.
- 1 krediitti = 0,01 $
Kustannuslaskin
Hintalaskin
Palveluntarjoajan mukaan tyypillinen: noin 9,7 s
Yhteensä
1,14 $
114 krediittiä
Suoritusta kohti
0,0114 $ · 1,14 krediittiä
Laskutus perustuu todelliseen GPU-aikaan; tämä on arvio.
API
Ei vahvistettua API-esimerkkiä
Julkinen API välittää eri syötemuotoa kuin tämä malli tarvitsee. Käytä yllä olevaa leikkikenttää.
Tekniset tiedot
- Mallin tunnus
cogvlm2-19b- Kehittäjä
- Community
- Kategoria
- Multimodaali
- Syöte
- Teksti, Kuva
- Tuloste
- Teksti
- Konteksti-ikkuna
- 8 192 tokenia
- Enimmäistuloste
- 2 048 tokenia
- Laskutus
- Käytön mukaan (tokeneja tai GPU-aikaa)
- Luettelokirjaus päivitetty
- 23. syyskuuta 2026
Tunnisteet
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Usein kysytyt kysymykset
Mikä on CogVLM2 19B?
CogVLM2 19B on Communityn kehittämä malli Multimodaali-kategoriassa.
Paljonko CogVLM2 19B maksaa Railwailissa?
Railwailissa CogVLM2 19B maksaa ≈ 0,0114 $ per suoritus. Sinua veloitetaan siitä, mitä kukin pyyntö todella käyttää. Käyttö maksetaan ennakkoon ostettujen krediittien avulla; 1 krediitti vastaa 0,01 $.
Mikä on CogVLM2 19Bn kontekstiikkuna?
CogVLM2 19Bn kontekstiikkuna sisältää 8 192 tokenia. Vastaus voi olla enintään 2 048 tokenia pitkä.
Kuinka nopea CogVLM2 19B on?
CogVLM2 19Blla ei ole vielä tarpeeksi mitattuja suorituksia Railwailissa suoritusajan ilmoittamiseksi. Se riippuu syötteestä, asetuksista ja palveluntarjoajan kuormituksesta.
Onko CogVLM2 19B parempi kuin BLIP?
Se riippuu tehtävästä. CogVLM2 19B (Community) ja BLIP (Salesforce) ovat molemmat malleja Multimodaali-kategoriassa. Vertailussa näkyvät niiden hinnat ja tekniset tiedot rinnakkain.
Vertaa CogVLM2 19B ja BLIPVoiko CogVLM2 19B käsitellä kuvia?
Kyllä. CogVLM2 19B hyväksyy kuvia syötteenä tekstin lisäksi.
Vertailukelpoiset mallit
Kaikki tässä kategoriassa- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Kaikki mallit yhden API:n kautta
Yksi API-avain kaikille Railwailin malleille. Käyttö laskutetaan prepaid-krediiteistä, 1 krediitti = 0,01 $.