
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Hinta
- ≈ 0,0086 $/suoritus
- Konteksti
- 4 096 tokenia
- Enint. tuloste
- 2 048 tokenia
- Syöte → tulos
- Teksti + Kuva → Teksti
- Kehittäjä
- DeepSeek
- Päivitetty
- 23. syyskuuta 2026
Leikkikenttä
Kokeile DeepSeek-VL 7B
Ei syötelomaketta
Tälle mallille ei ole vielä syötelomaketta
Sen syötteet eivät ole vielä dokumentoituja. Jotta mikään suoritus ei epäonnistuisi väärän syötteen vuoksi, emme tarjoa lomaketta täällä. Valitse sen sijaan vertailukelpoinen malli.
Examples
 Input
Prompt
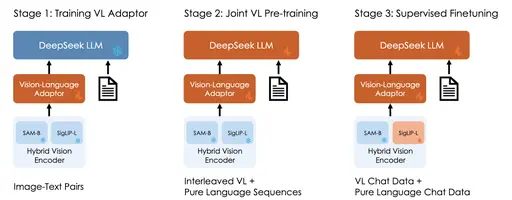
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
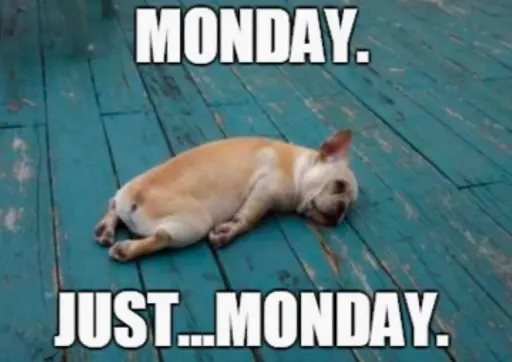
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Tietoja: DeepSeek-VL 7B
DeepSeek-VL 7B on DeepSeek-kehittäjän malli kategoriasta Multimodaali. Railwailissa DeepSeek-VL 7B maksaa ≈ 0,0086 $ per suoritus. Kontekstiikkuna sisältää 4 096 tokenia, ja vastaus voi olla enintään 2 048 tokenia pitkä.
Hinnat
| Tyypillinen suoritus (≈ 7 s L40S:lla) | 0,0086 $ per suoritus |
|---|---|
| GPU-aika (L40S) | 0,00117 $ per GPU-sekunti |
- Laskutus perustuu suorituksen todelliseen GPU-aikaan. Kun suoritus alkaa, 3-kertainen tyypillinen hinta varataan saldostasi ja selvitetään jälkikäteen.
- 1 krediitti = 0,01 $
Kustannuslaskin
Hintalaskin
Palveluntarjoajan mukaan tyypillinen: noin 7,3 s
Yhteensä
0,86 $
86 krediittiä
Suoritusta kohti
0,0086 $ · 0,86 krediittiä
Laskutus perustuu todelliseen GPU-aikaan; tämä on arvio.
API
Ei vahvistettua API-esimerkkiä
Julkinen API välittää eri syötemuotoa kuin tämä malli tarvitsee. Käytä yllä olevaa leikkikenttää.
Tekniset tiedot
- Mallin tunnus
deepseek-vl-7b- Kehittäjä
- DeepSeek
- Kategoria
- Multimodaali
- Syöte
- Teksti, Kuva
- Tuloste
- Teksti
- Konteksti-ikkuna
- 4 096 tokenia
- Enimmäistuloste
- 2 048 tokenia
- Laskutus
- Käytön mukaan (tokeneja tai GPU-aikaa)
- Luettelokirjaus päivitetty
- 23. syyskuuta 2026
Tunnisteet
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Usein kysytyt kysymykset
Mikä on DeepSeek-VL 7B?
DeepSeek-VL 7B on DeepSeekn kehittämä malli Multimodaali-kategoriassa.
Paljonko DeepSeek-VL 7B maksaa Railwailissa?
Railwailissa DeepSeek-VL 7B maksaa ≈ 0,0086 $ per suoritus. Sinua veloitetaan siitä, mitä kukin pyyntö todella käyttää. Käyttö maksetaan ennakkoon ostettujen krediittien avulla; 1 krediitti vastaa 0,01 $.
Mikä on DeepSeek-VL 7Bn kontekstiikkuna?
DeepSeek-VL 7Bn kontekstiikkuna sisältää 4 096 tokenia. Vastaus voi olla enintään 2 048 tokenia pitkä.
Kuinka nopea DeepSeek-VL 7B on?
DeepSeek-VL 7Blla ei ole vielä tarpeeksi mitattuja suorituksia Railwailissa suoritusajan ilmoittamiseksi. Se riippuu syötteestä, asetuksista ja palveluntarjoajan kuormituksesta.
Onko DeepSeek-VL 7B parempi kuin BLIP?
Se riippuu tehtävästä. DeepSeek-VL 7B (DeepSeek) ja BLIP (Salesforce) ovat molemmat malleja Multimodaali-kategoriassa. Vertailussa näkyvät niiden hinnat ja tekniset tiedot rinnakkain.
Vertaa DeepSeek-VL 7B ja BLIPVoiko DeepSeek-VL 7B käsitellä kuvia?
Kyllä. DeepSeek-VL 7B hyväksyy kuvia syötteenä tekstin lisäksi.
Vertailukelpoiset mallit
Kaikki tässä kategoriassa- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Kaikki mallit yhden API:n kautta
Yksi API-avain kaikille Railwailin malleille. Käyttö laskutetaan prepaid-krediiteistä, 1 krediitti = 0,01 $.