
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Hinta
- ≈ 0,0012 $/suoritus
- Syöte → tulos
- Teksti + Kuva → Teksti
- Kehittäjä
- Community
- Päivitetty
- 23. syyskuuta 2026
Leikkikenttä
Kokeile Florence-2 Large
Syöte ja tulos
Tämä suoritus
noin 0,0012 $ · 0,12 creditiä
Alussa varataan 0,0036 $ (0,36 creditiä); todellinen GPU-aika laskutetaan.
Uusi täällä?
10 ilmaista creditiä (0,10 $) kun rekisteröidyt Googlella
Käytettävissä 24 tuntia rekisteröinnin jälkeen, enintään 5 suoritusta päivässä ja enintään 2 creditiä suoritusta kohti. Muut kirjautumismenetelmät alkavat ilman creditejä. Riittää 27 suoritukseen tästä mallista.
Examples
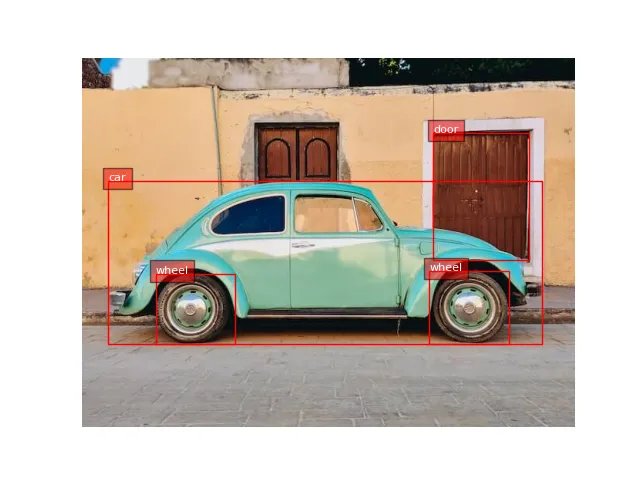 Open full size
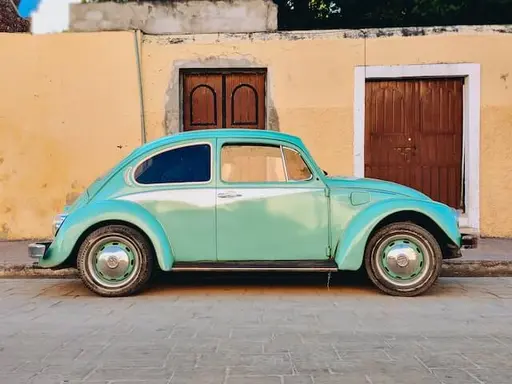 Input
No text prompt: the model only takes the input shown.
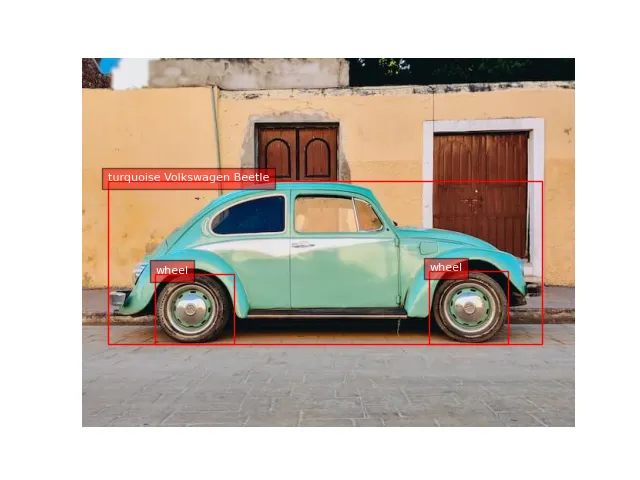 Open full size
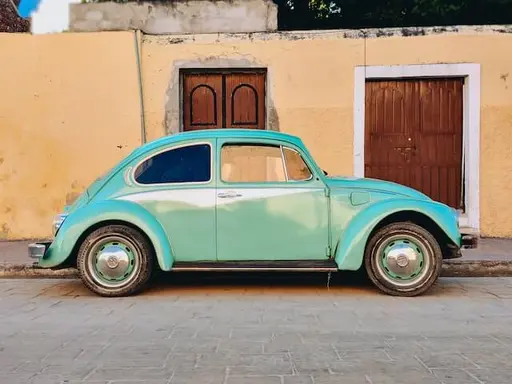 Input
No text prompt: the model only takes the input shown.
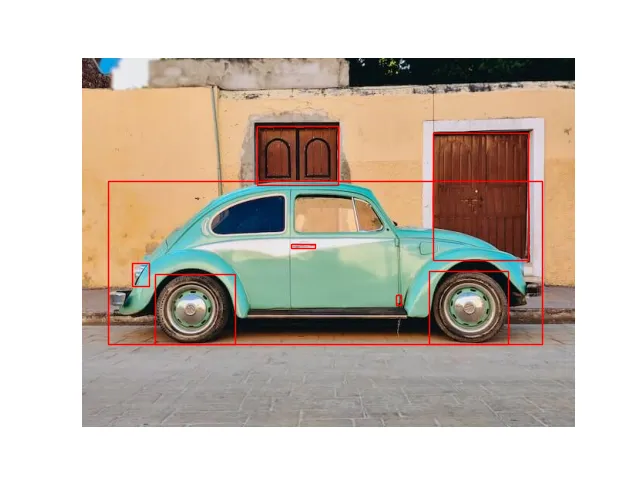 Open full size
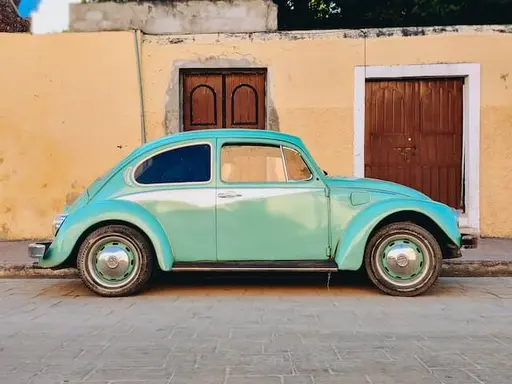 Input
No text prompt: the model only takes the input shown.
Tietoja: Florence-2 Large
Florence-2 Large on Community-kehittäjän malli kategoriasta Multimodaali. Railwailissa Florence-2 Large maksaa ≈ 0,0012 $ per suoritus.
Hinnat
| Tyypillinen suoritus (≈ 1 s L40S:lla) | 0,0012 $ per suoritus |
|---|---|
| GPU-aika (L40S) | 0,00117 $ per GPU-sekunti |
- Laskutus perustuu suorituksen todelliseen GPU-aikaan. Kun suoritus alkaa, 3-kertainen tyypillinen hinta varataan saldostasi ja selvitetään jälkikäteen.
- 1 krediitti = 0,01 $
Kustannuslaskin
Hintalaskin
Palveluntarjoajan mukaan tyypillinen: noin 1 s
Yhteensä
0,12 $
12 krediittiä
Suoritusta kohti
0,0012 $ · 0,12 krediittiä
Laskutus perustuu todelliseen GPU-aikaan; tämä on arvio.
API
Ei vahvistettua API-esimerkkiä
Julkinen API välittää eri syötemuotoa kuin tämä malli tarvitsee. Käytä yllä olevaa leikkikenttää.
Tekniset tiedot
- Mallin tunnus
florence-2-large- Kehittäjä
- Community
- Kategoria
- Multimodaali
- Syöte
- Teksti, Kuva
- Tuloste
- Teksti
- Laskutus
- Käytön mukaan (tokeneja tai GPU-aikaa)
- Luettelokirjaus päivitetty
- 23. syyskuuta 2026
Syöteparametrit
Mallin syötökaavion syötteet ja asetukset. API-osion esimerkki näyttää, mitkä niistä API hyväksyy.
promptpakollinenUser message or task instruction
Tyyppi: TekstiOletus: –Sallitut arvot: enintään 4 000 merkkiätaskTyyppi: ValintaOletus:captionSallitut arvot: caption, detailed_caption, ocr, object_detection tai segmentationimage_urlImage URL to analyze
Tyyppi: TekstiOletus: –Sallitut arvot: –max_tokensTyyppi: KokonaislukuOletus:1024Sallitut arvot: 1–4 096temperatureTyyppi: LukuOletus:0.7Sallitut arvot: 0–2
Tunnisteet
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Usein kysytyt kysymykset
Mikä on Florence-2 Large?
Florence-2 Large on Communityn kehittämä malli Multimodaali-kategoriassa.
Paljonko Florence-2 Large maksaa Railwailissa?
Railwailissa Florence-2 Large maksaa ≈ 0,0012 $ per suoritus. Sinua veloitetaan siitä, mitä kukin pyyntö todella käyttää. Käyttö maksetaan ennakkoon ostettujen krediittien avulla; 1 krediitti vastaa 0,01 $.
Mitä asetuksia Florence-2 Large tukee?
Syötteen rakenteen mukaan Florence-2 Large tuntee nämä parametrit: prompt (enintään 4 000 merkkiä), task (caption, detailed_caption, ocr, object_detection tai segmentation), image_url, max_tokens (1–4 096) ja temperature (0–2).
Kuinka nopea Florence-2 Large on?
Florence-2 Largella ei ole vielä tarpeeksi mitattuja suorituksia Railwailissa suoritusajan ilmoittamiseksi. Se riippuu syötteestä, asetuksista ja palveluntarjoajan kuormituksesta.
Onko Florence-2 Large parempi kuin BLIP?
Se riippuu tehtävästä. Florence-2 Large (Community) ja BLIP (Salesforce) ovat molemmat malleja Multimodaali-kategoriassa. Vertailussa näkyvät niiden hinnat ja tekniset tiedot rinnakkain.
Vertaa Florence-2 Large ja BLIPVoiko Florence-2 Large käsitellä kuvia?
Kyllä. Florence-2 Large hyväksyy kuvia syötteenä tekstin lisäksi.
Vertailukelpoiset mallit
Kaikki tässä kategoriassa- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Kaikki mallit yhden API:n kautta
Yksi API-avain kaikille Railwailin malleille. Käyttö laskutetaan prepaid-krediiteistä, 1 krediitti = 0,01 $.