
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Prix
- ≈ 0,0012 $US/exécution
- Entrée → Sortie
- Texte + Image → Texte
- Développeur
- Community
- Mis à jour
- 23 septembre 2026
Playground
Essayer Florence-2 Large
Entrée et résultat
Cette exécution
environ 0,0012 $US · 0,12 crédits
0,0036 $US (0,36 crédits) sont réservés au démarrage ; le temps GPU réel est facturé.
Nouveau par ici ?
10 crédits gratuits (0,10 $US) lors de l'inscription avec Google
Utilisable 24 heures après l'inscription, jusqu'à 5 exécutions par jour et au maximum 2 crédits par exécution. Les autres méthodes de connexion commencent sans crédits. Suffisant pour 27 exécutions de ce modèle.
Examples
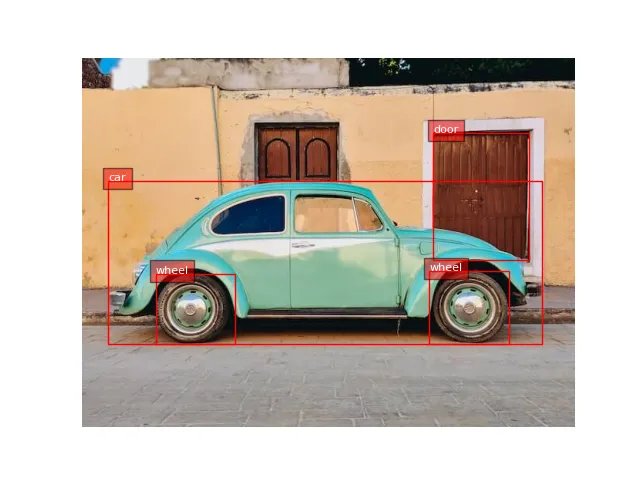 Open full size
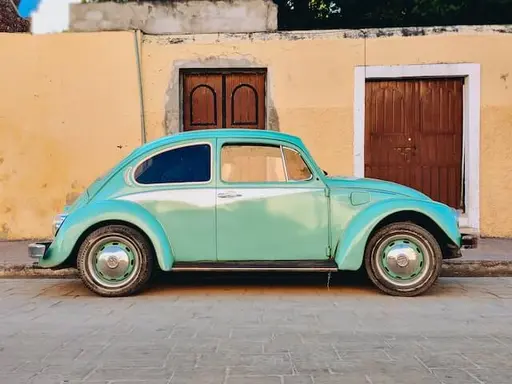 Input
No text prompt: the model only takes the input shown.
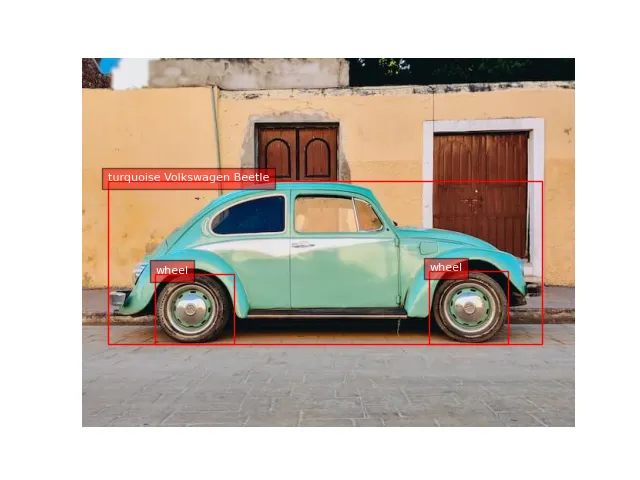 Open full size
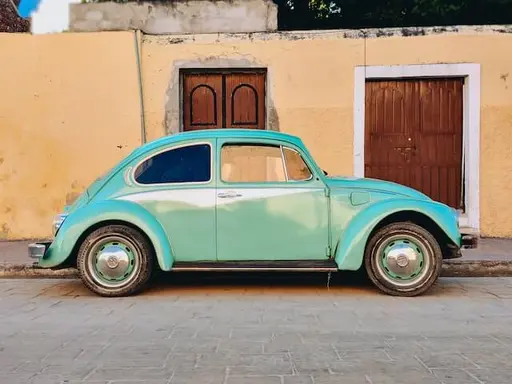 Input
No text prompt: the model only takes the input shown.
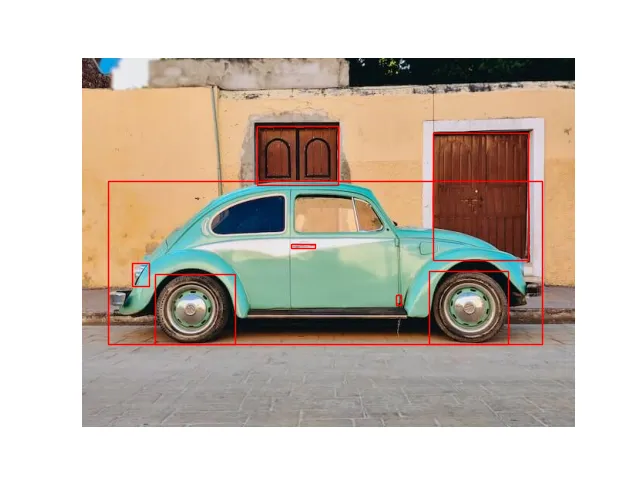 Open full size
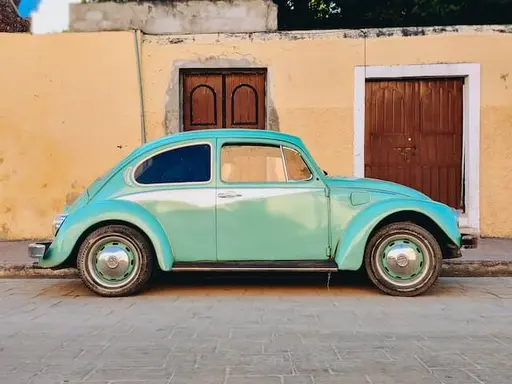 Input
No text prompt: the model only takes the input shown.
À propos de Florence-2 Large
Florence-2 Large est un modèle de Community dans la catégorie Multimodal. Sur Railwail, Florence-2 Large coûte ≈ 0,0012 $US par exécution.
Tarification
| Exécution typique (≈ 1 s sur L40S) | 0,0012 $US par exécution |
|---|---|
| Temps GPU (L40S) | 0,00117 $US par seconde GPU |
- Facturé selon le temps GPU réellement utilisé. Au démarrage, 3× le prix typique est réservé sur votre solde et régularisé ensuite.
- 1 crédit = 0,01 $US
Calculateur de coûts
Calculateur de prix
Typique selon le fournisseur : environ 1 s
Total
0,12 $US
12 crédits
Par exécution
0,0012 $US · 0,12 crédits
Facturé selon le temps GPU réel ; ceci est une estimation.
API
Aucun exemple API vérifié
L'API publique transmet un format d'entrée différent de celui dont ce modèle a besoin. Utilisez le playground ci-dessus.
Spécifications
- ID du modèle
florence-2-large- Développeur
- Community
- Catégorie
- Multimodal
- Entrée
- Texte, Image
- Sortie
- Texte
- Facturation
- À l'usage (tokens ou temps GPU)
- Entrée du catalogue mise à jour
- 23 septembre 2026
Paramètres d'entrée
Entrées et paramètres du schéma d'entrée du modèle. L'exemple dans la section API montre lesquels l'API accepte.
promptObligatoireUser message or task instruction
Type: TexteDéfaut: –Valeurs autorisées: Jusqu'à 4 000 caractèrestaskType: ChoixDéfaut:captionValeurs autorisées: caption, detailed_caption, ocr, object_detection ou segmentationimage_urlImage URL to analyze
Type: TexteDéfaut: –Valeurs autorisées: –max_tokensType: Nombre entierDéfaut:1024Valeurs autorisées: 1 à 4 096temperatureType: NombreDéfaut:0.7Valeurs autorisées: 0 à 2
Étiquettes
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Questions fréquemment posées
Qu'est-ce que Florence-2 Large ?
Florence-2 Large est un modèle de Community dans la catégorie Multimodal.
Combien coûte Florence-2 Large sur Railwail ?
Sur Railwail, Florence-2 Large coûte ≈ 0,0012 $US par exécution. Vous êtes facturé pour ce que chaque requête utilise réellement. L'utilisation est payée à partir de crédits prépayés ; 1 crédit équivaut à 0,01 $US.
Quels paramètres Florence-2 Large supporte-t-il ?
Selon son schéma d'entrée, Florence-2 Large connaît ces paramètres : prompt (Jusqu'à 4 000 caractères), task (caption, detailed_caption, ocr, object_detection ou segmentation), image_url, max_tokens (1 à 4 096) et temperature (0 à 2).
Quelle est la vitesse de Florence-2 Large ?
Il n'y a pas encore assez d'exécutions mesurées de Florence-2 Large sur Railwail pour indiquer un temps d'exécution. Cela dépend de l'entrée, des paramètres et de la charge chez le fournisseur.
Florence-2 Large est-il meilleur que BLIP ?
Cela dépend de la tâche. Florence-2 Large (Community) et BLIP (Salesforce) sont tous deux des modèles de la catégorie Multimodal. La page de comparaison affiche leurs prix et spécifications côte à côte.
Comparer Florence-2 Large et BLIPFlorence-2 Large peut-il traiter des images ?
Oui. Florence-2 Large accepte les images en entrée en plus du texte.
Modèles comparables
Tous dans cette catégorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Tous les modèles via une seule API
Une clé API pour tous les modèles sur Railwail. L'utilisation est facturée à partir de crédits prépayés, 1 crédit = 0,01 $US.