
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Prix
- ≈ 0,0012 $US/exécution
- Entrée → Sortie
- Texte + Image → Texte
- Développeur
- Community
- Mis à jour
- 23 septembre 2026
Playground
Essayer Florence-2 Segmentation
Pas de formulaire d'entrée
Aucun formulaire d'entrée pour ce modèle pour le moment
Ses entrées ne sont pas encore documentées. Pour éviter qu'une exécution échoue sur une entrée incorrecte, nous ne proposons pas de formulaire ici. Choisissez plutôt un modèle comparable.
Examples
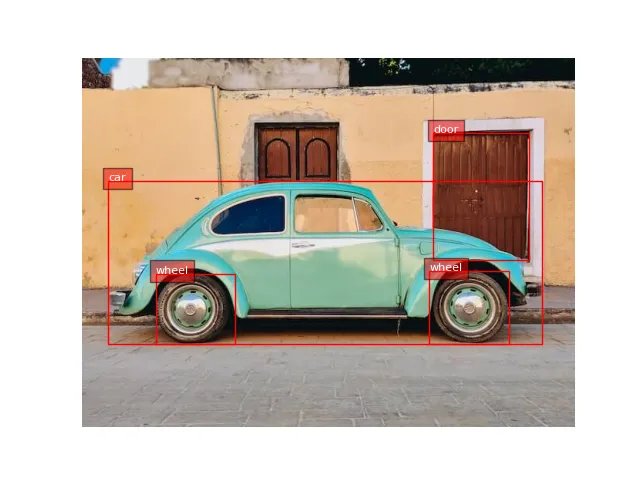 Open full size
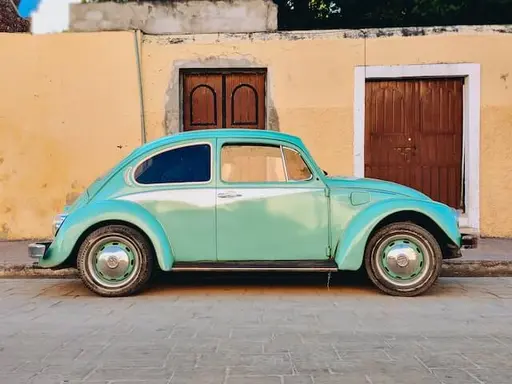 Input
No text prompt: the model only takes the input shown.
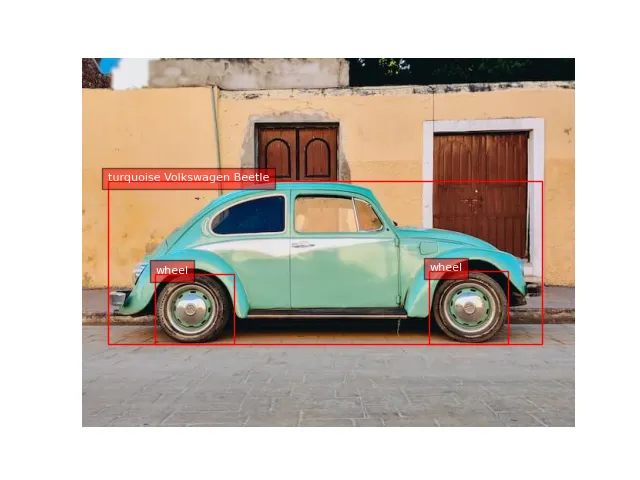 Open full size
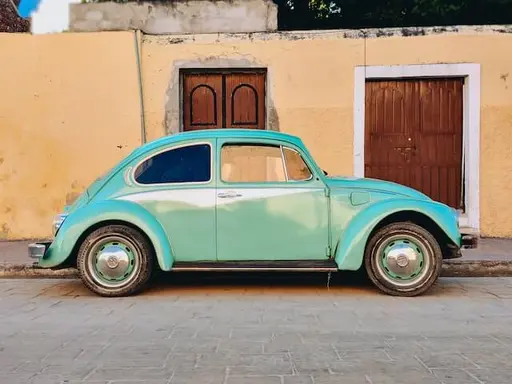 Input
No text prompt: the model only takes the input shown.
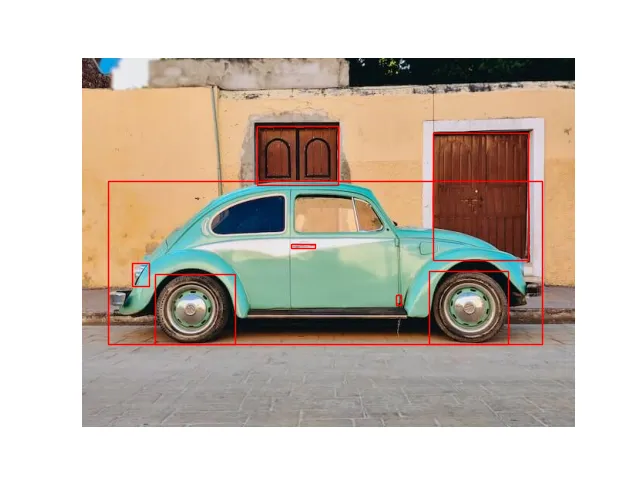 Open full size
 Input
No text prompt: the model only takes the input shown.
À propos de Florence-2 Segmentation
Florence-2 Segmentation est un modèle de Community dans la catégorie Multimodal. Sur Railwail, Florence-2 Segmentation coûte ≈ 0,0012 $US par exécution.
Tarification
| Exécution typique (≈ 1 s sur L40S) | 0,0012 $US par exécution |
|---|---|
| Temps GPU (L40S) | 0,00117 $US par seconde GPU |
- Facturé selon le temps GPU réellement utilisé. Au démarrage, 3× le prix typique est réservé sur votre solde et régularisé ensuite.
- 1 crédit = 0,01 $US
Calculateur de coûts
Calculateur de prix
Typique selon le fournisseur : environ 1 s
Total
0,12 $US
12 crédits
Par exécution
0,0012 $US · 0,12 crédits
Facturé selon le temps GPU réel ; ceci est une estimation.
API
Aucun exemple API vérifié
L'API publique transmet un format d'entrée différent de celui dont ce modèle a besoin. Utilisez le playground ci-dessus.
Spécifications
- ID du modèle
florence-2-segmentation- Développeur
- Community
- Catégorie
- Multimodal
- Entrée
- Texte, Image
- Sortie
- Texte
- Facturation
- À l'usage (tokens ou temps GPU)
- Entrée du catalogue mise à jour
- 23 septembre 2026
Étiquettes
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Questions fréquemment posées
Qu'est-ce que Florence-2 Segmentation ?
Florence-2 Segmentation est un modèle de Community dans la catégorie Multimodal.
Combien coûte Florence-2 Segmentation sur Railwail ?
Sur Railwail, Florence-2 Segmentation coûte ≈ 0,0012 $US par exécution. Vous êtes facturé pour ce que chaque requête utilise réellement. L'utilisation est payée à partir de crédits prépayés ; 1 crédit équivaut à 0,01 $US.
Quelle est la vitesse de Florence-2 Segmentation ?
Il n'y a pas encore assez d'exécutions mesurées de Florence-2 Segmentation sur Railwail pour indiquer un temps d'exécution. Cela dépend de l'entrée, des paramètres et de la charge chez le fournisseur.
Florence-2 Segmentation est-il meilleur que BLIP ?
Cela dépend de la tâche. Florence-2 Segmentation (Community) et BLIP (Salesforce) sont tous deux des modèles de la catégorie Multimodal. La page de comparaison affiche leurs prix et spécifications côte à côte.
Comparer Florence-2 Segmentation et BLIPFlorence-2 Segmentation peut-il traiter des images ?
Oui. Florence-2 Segmentation accepte les images en entrée en plus du texte.
Modèles comparables
Tous dans cette catégorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ 0,0457 $US/exécution
3 708 % plus cher par unité
Comparer Florence-2 Segmentation et CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ 0,0050 $US/exécution
317 % plus cher par unité
Comparer Florence-2 Segmentation et Depth Anything v2
Tous les modèles via une seule API
Une clé API pour tous les modèles sur Railwail. L'utilisation est facturée à partir de crédits prépayés, 1 crédit = 0,01 $US.