
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Τιμή
- ≈ 0,0114 $/εκτέλεση
- Περιεχόμενο
- 8.192 tokens
- Μέγ. έξοδος
- 2.048 tokens
- Είσοδος → Έξοδος
- Κείμενο + Εικόνα → Κείμενο
- Προγραμματιστής
- Community
- Ενημερώθηκε
- 23 Σεπτεμβρίου 2026
Playground
Δοκιμάστε CogVLM2 19B
Χωρίς φόρμα εισόδου
Δεν υπάρχει ακόμα φόρμα εισόδου για αυτό το μοντέλο
Οι είσοδοί του δεν έχουν τεκμηριωθεί ακόμα. Ώστε να μην αποτύχει κάποια εκτέλεση σε λάθος είσοδο, δεν προσφέρουμε φόρμα εδώ. Επιλέξτε ένα συγκρίσιμο μοντέλο.
Examples
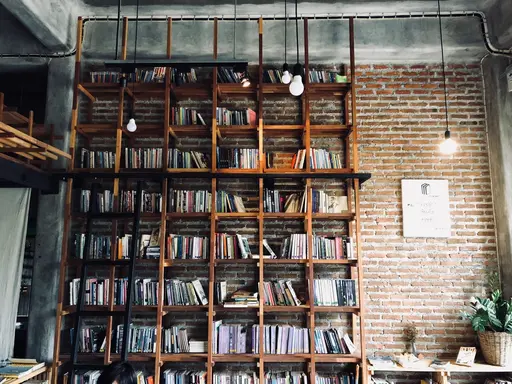 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
Σχετικά με το CogVLM2 19B
Το CogVLM2 19B είναι ένα μοντέλο του Community στην κατηγορία Multimodal. Στο Railwail, το CogVLM2 19B κοστίζει ≈ 0,0114 $ ανά εκτέλεση. Το παράθυρο περιεχομένου περιέχει 8.192 tokens, και μια απάντηση μπορεί να είναι έως 2.048 tokens.
Τιμολόγηση
| Συνήθης εκτέλεση (≈ 10 s σε L40S) | 0,0114 $ ανά εκτέλεση |
|---|---|
| Χρόνος GPU (L40S) | 0,00117 $ ανά δευτερόλεπτο GPU |
- Χρέωση με βάση τον χρόνο GPU που χρειάζεται πραγματικά η εκτέλεση. Κατά την έναρξη, το 3× της τυπικής τιμής δεσμεύεται από το υπόλοιπό σας και διακανονίζεται αργότερα.
- 1 πιστωτική μονάδα = 0,01 $
Αριθμομηχανή κόστους
Αριθμομηχανή τιμών
Τυπικά σύμφωνα με τον πάροχο: περίπου 9,7 s
Σύνολο
1,14 $
114 πιστωτικές μονάδες
Ανά εκτέλεση
0,0114 $ · 1,14 πιστωτικές μονάδες
Χρέωση με βάση τον πραγματικό χρόνο GPU· αυτή είναι μια εκτίμηση.
API
Κανένα επαληθευμένο παράδειγμα API
Το δημόσιο API περνά μια διαφορετική μορφή εισόδου από αυτή που χρειάζεται αυτό το μοντέλο. Χρησιμοποιήστε το playground παραπάνω.
Προδιαγραφές
- ID μοντέλου
cogvlm2-19b- Ανάπτυξη
- Community
- Κατηγορία
- Multimodal
- Είσοδος
- Κείμενο, Εικόνα
- Έξοδος
- Κείμενο
- Παράθυρο περιεχομένου
- 8.192 tokens
- Μέγ. έξοδος
- 2.048 tokens
- Χρέωση
- Κατά χρήση (tokens ή χρόνος GPU)
- Καταχώρηση καταλόγου ενημερώθηκε
- 23 Σεπτεμβρίου 2026
Ετικέτες
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Συχνές ερωτήσεις
Τι είναι CogVLM2 19B;
Το CogVLM2 19B είναι ένα μοντέλο του Community στην κατηγορία Multimodal.
Πόσο κοστίζει το CogVLM2 19B στο Railwail;
Στο Railwail, το CogVLM2 19B κοστίζει ≈ 0,0114 $ ανά εκτέλεση. Χρεώνεστε για αυτό που χρησιμοποιεί πραγματικά κάθε αίτημα. Η χρήση πληρώνεται από προπληρωμένες πιστωτικές μονάδες· 1 πιστωτική μονάδα ισούται με 0,01 $.
Ποιο είναι το παράθυρο περιεχομένου του CogVLM2 19B;
Το παράθυρο περιεχομένου του CogVLM2 19B περιέχει 8.192 tokens. Μια απάντηση μπορεί να είναι έως 2.048 tokens.
Πόσο γρήγορο είναι το CogVLM2 19B;
Δεν υπάρχουν αρκετές μετρημένες εκτελέσεις του CogVLM2 19B στο Railwail ακόμα για να δηλωθεί ένας χρόνος εκτέλεσης. Εξαρτάται από την είσοδο, τις ρυθμίσεις και το φορτίο στον πάροχο.
Είναι το CogVLM2 19B καλύτερο από το BLIP;
Αυτό εξαρτάται από την εργασία. Το CogVLM2 19B (Community) και το BLIP (Salesforce) είναι και τα δύο μοντέλα στην κατηγορία Multimodal. Η σελίδα σύγκρισης δείχνει τις τιμές και τις προδιαγραφές τους παράλληλα.
Σύγκριση CogVLM2 19B και BLIPΜπορεί το CogVLM2 19B να επεξεργαστεί εικόνες;
Ναι. Το CogVLM2 19B δέχεται εικόνες ως είσοδο εκτός από κείμενο.
Συγκρίσιμα μοντέλα
Όλα σε αυτήν την κατηγορία- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Όλα τα μοντέλα μέσω ενός API
Ένα κλειδί API για κάθε μοντέλο στο Railwail. Η χρήση χρεώνεται από προπληρωμένα πιστωτικά, 1 πιστωτικό = 0,01 $.