
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Ár
- ≈ 0,0086 USD/futás
- Kontextus
- 4096 token
- Max. kimenet
- 2048 token
- Bemenet → kimenet
- Szöveg + Kép → Szöveg
- Fejlesztő
- DeepSeek
- Frissítve
- 2026. szeptember 23.
Playground
Próbáld ki: DeepSeek-VL 7B
Nincs beviteli forma
Ehhez a modellhez még nincs beviteli forma
A bemenete még nincs dokumentálva. Hogy ne hiúsuljon meg egy futtatás rossz bemenet miatt, itt nem kínálunk formot. Válassz helyette egy hasonló modellt.
Examples
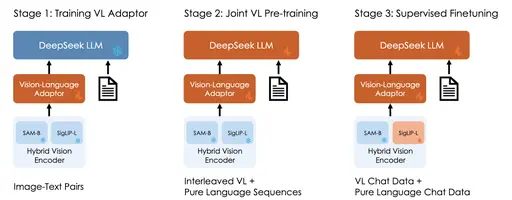 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
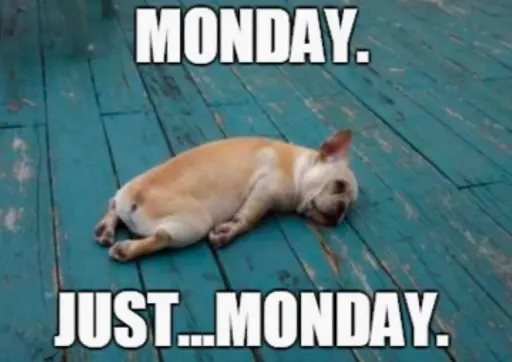 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
A DeepSeek-VL 7B névjegye
A DeepSeek-VL 7B a DeepSeek által fejlesztett modell a Multimodális kategóriában. A Railwail-en a DeepSeek-VL 7B ára ≈ 0,0086 USD futásonként. A kontextablak 4096 tokent tartalmaz, egy válasz pedig legfeljebb 2048 token hosszú lehet.
Árak
| Tipikus futás (≈ 7 s a(z) L40S eszközön) | 0,0086 USD futásonként |
|---|---|
| GPU-idő (L40S) | 0,00117 USD GPU-másodpercenként |
- A futás által ténylegesen igénybevett GPU-idő alapján történik a számlázás. A futás indításakor a tipikus ár 3-szerese kerül foglalásra az egyenlegéből, majd később elszámolásra.
- 1 kredit = 0,01 USD
Költségkalkulátor
Árkalkulátor
A szolgáltató szerint tipikus: kb. 7,3 mp
Összesen
0,86 USD
86 kredit
Futásonként
0,0086 USD · 0,86 kredit
A tényleges GPU-idő alapján számlázva; ez egy becslés.
API
Nincs ellenőrzött API-példa
A nyilvános API más bemeneti formátumot továbbít, mint amit ez a modell igényel. Használja a fenti Playground-ot.
Specifikációk
- Modell-azonosító
deepseek-vl-7b- Fejlesztő
- DeepSeek
- Kategória
- Multimodális
- Bemenet
- Szöveg, Kép
- Kimenet
- Szöveg
- Kontextusablak
- 4096 token
- Max. kimenet
- 2048 token
- Számlázás
- Használat alapján (tokenek vagy GPU-idő)
- Katalógus bejegyzés frissítve
- 2026. szeptember 23.
Címkék
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Gyakran ismételt kérdések
Mi az a DeepSeek-VL 7B?
A DeepSeek-VL 7B a DeepSeek által fejlesztett modell a Multimodális kategóriában.
Mennyibe kerül a DeepSeek-VL 7B a Railwail-on?
A Railwail-en a DeepSeek-VL 7B ára ≈ 0,0086 USD futásonként. Az egyes kérések tényleges felhasználásáért kell fizetni. A használatért előre vásárolt kreditek alapján kell fizetni; 1 kredit = 0,01 USD.
Mekkora a DeepSeek-VL 7B kontextablaka?
A DeepSeek-VL 7B kontextablaka 4096 tokent tartalmaz. Egy válasz legfeljebb 2048 token hosszú lehet.
Milyen gyors a DeepSeek-VL 7B?
A DeepSeek-VL 7B-nek még nincs elég mért futtatása a Railwail-on ahhoz, hogy futási időt adjunk meg. Ez a bemenettől, a beállításoktól és a szolgáltató terhelésétől függ.
A DeepSeek-VL 7B jobb, mint a BLIP?
Ez a feladattól függ. A DeepSeek-VL 7B (DeepSeek) és a BLIP (Salesforce) egyaránt modellek a Multimodális kategóriában. Az összehasonlítás oldal az árakat és specifikációkat egymás mellett mutatja.
DeepSeek-VL 7B és BLIP összehasonlításaA DeepSeek-VL 7B képes képeket feldolgozni?
Igen. A DeepSeek-VL 7B szöveg mellett képeket is fogad bemenetként.
Hasonló modellek
Ebben a kategóriában az összes- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Összes modell egy API-n keresztül
Egy API-kulcs a Railwail összes modelljéhez. A használat előre feltöltött kreditek alapján kerül felszámításra, 1 kredit = 0,01 USD.