
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- מחיר
- ≈ 0.0012 $/הרצה
- קלט → פלט
- טקסט + תמונה → טקסט
- מפתח
- Community
- עודכן
- 23 בספטמבר 2026
Playground
נסה את Florence-2 Large
קלט ותוצאה
הריצה הזו
בערך 0.0012 $ · 0.12 קרדיטים
0.0036 $ (0.36 קרדיטים) מסוכנים בתחילת הריצה; זמן ה-GPU בפועל יחויב.
חדש כאן?
10 קרדיטים חינם (0.10 $) כשאתה נרשם עם Google
ניתן להשתמש 24 שעות לאחר ההרשמה, עד 5 ריצות ביום ולכל היותר 2 קרדיטים לריצה. שיטות כניסה אחרות מתחילות ללא קרדיטים. מספיק ל-27 הרצות של מודל זה.
Examples
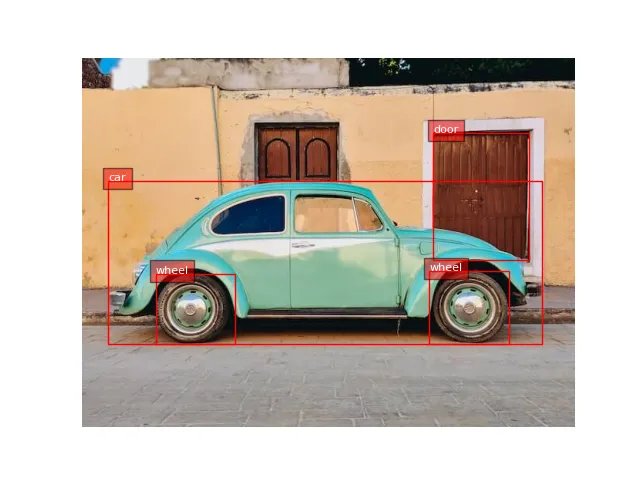 Open full size
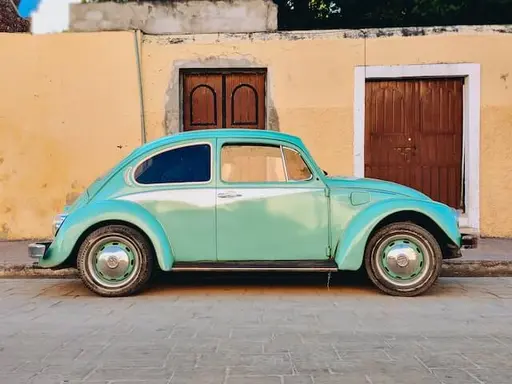 Input
No text prompt: the model only takes the input shown.
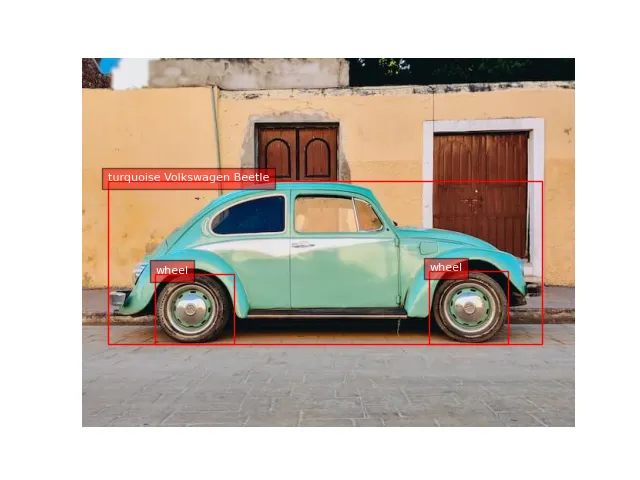 Open full size
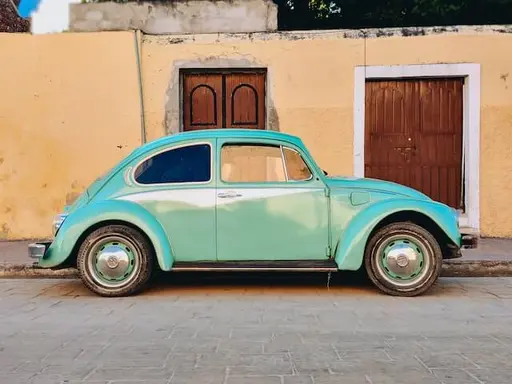 Input
No text prompt: the model only takes the input shown.
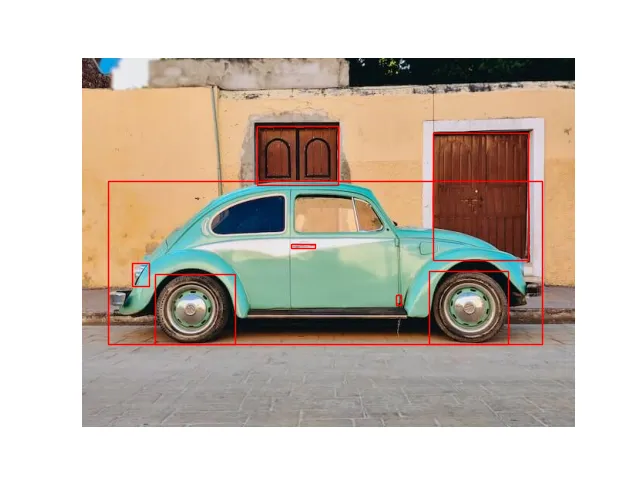 Open full size
 Input
No text prompt: the model only takes the input shown.
אודות Florence-2 Large
Florence-2 Large הוא מודל של Community בקטגוריית מולטימודאל. ב-Railwail, Florence-2 Large עולה ≈ 0.0012 $ להרצה.
תמחור
| הרצה טיפוסית (≈ 1 s ב-L40S) | 0.0012 $ להרצה |
|---|---|
| זמן GPU (L40S) | 0.00117 $ לשנייה של GPU |
- חיוב לפי זמן ה-GPU שההרצה בעצם לוקחת. כשההרצה מתחילה, 3× המחיר הטיפוסי מוזמן מהיתרה שלך ומסולק לאחר מכן.
- 1 קרדיט = 0.01 $
מחשבון עלויות
מחשבון מחירים
טיפוסי לפי הספק: כ-1 שנ׳
סה״כ
0.12 $
12 קרדיטים
לכל הרצה
0.0012 $ · 0.12 קרדיטים
חיוב לפי זמן ה-GPU בפועל; זו הערכה.
API
אין דוגמה API מאומתת
ה-API הציבורי מעביר פורמט קלט שונה מזה שהדגם הזה צריך. השתמש בגובה המשחק למעלה.
מפרטים
- ID מודל
florence-2-large- מפתח
- Community
- קטגוריה
- מולטימודאל
- קלט
- טקסט, תמונה
- פלט
- טקסט
- חיוב
- לפי שימוש (טוקנים או זמן GPU)
- רשומת הקטלוג עודכנה
- 23 בספטמבר 2026
פרמטרים קלט
קלטים והגדרות מסכימת הקלט של המודל. הדוגמה בסעיף API מציגה אילו מהם ה-API מקבל.
promptחובהUser message or task instruction
סוג: טקסטברירת מחדל: –ערכים מותרים: עד 4,000 תוויםtaskסוג: בחירהברירת מחדל:captionערכים מותרים: caption, detailed_caption, ocr, object_detection או segmentationimage_urlImage URL to analyze
סוג: טקסטברירת מחדל: –ערכים מותרים: –max_tokensסוג: מספר שלםברירת מחדל:1024ערכים מותרים: 1 עד 4,096temperatureסוג: מספרברירת מחדל:0.7ערכים מותרים: 0 עד 2
תגיות
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
שאלות נפוצות
מה זה Florence-2 Large?
Florence-2 Large הוא מודל של Community בקטגוריית מולטימודאל.
כמה עולה Florence-2 Large ב-Railwail?
ב-Railwail, Florence-2 Large עולה ≈ 0.0012 $ להרצה. אתה משלם על מה שכל בקשה בעצם משתמשת. השימוש משולם מקרדיטים שנרכשו מראש; 1 קרדיט שווה 0.01 $.
אילו הגדרות תומך Florence-2 Large?
לפי סכימת הקלט שלו, Florence-2 Large מכיר את הפרמטרים הבאים: prompt (עד 4,000 תווים), task (caption, detailed_caption, ocr, object_detection או segmentation), image_url, max_tokens (1 עד 4,096) ו-temperature (0 עד 2).
כמה מהיר Florence-2 Large?
עדיין אין מספיק הרצות שנמדדו של Florence-2 Large ב-Railwail כדי לציין זמן הרצה. זה תלוי בקלט, בהגדרות ובעומס אצל הספק.
האם Florence-2 Large טוב יותר מ-BLIP?
זה תלוי במשימה. Florence-2 Large (Community) ו-BLIP (Salesforce) הם שניהם מודלים בקטגוריית מולטימודאל. דף ההשוואה מציג את המחירים והמפרטים שלהם זה לצד זה.
השווה בין Florence-2 Large ל-BLIPהאם Florence-2 Large יכול לעבד תמונות?
כן. Florence-2 Large מקבל תמונות כקלט בנוסף לטקסט.
דגמים דומים
הכל בקטגוריה זו- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
כל המודלים דרך API אחד
מפתח API אחד לכל מודל ב-Railwail. השימוש מחויב מאשראי מראש, 1 אשראי = 0.01 $.