
GLPN Depth
glpn-depthGlobal-Local Path Networks depth-estimation model. Combines hierarchical transformer encoder with selective feature fusion for sharp boundaries.
- מחיר
- ≈ 0.0094 $/הרצה
- קלט → פלט
- טקסט + תמונה → טקסט
- מפתח
- Community
- עודכן
- 23 בספטמבר 2026
Playground
נסה את GLPN Depth
אין טופס קלט
עדיין אין טופס קלט למודל זה
הקלטים שלו עדיין לא תועדו. כדי שלא תיכשל הרצה בקלט שגוי, אנחנו לא מציעים טופס כאן. בחר במודל דומה במקום זאת.
Examples
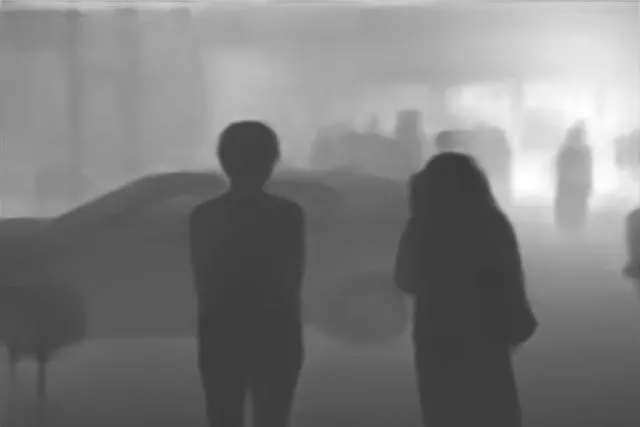 Open full size
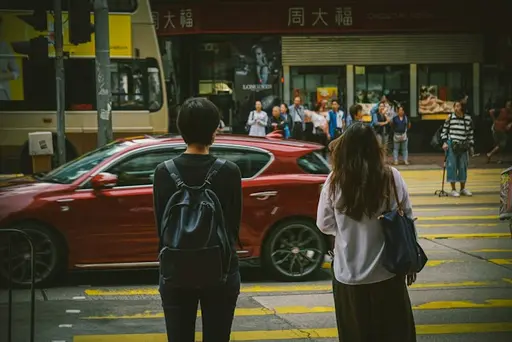 Input
No text prompt: the model only takes the input shown.
אודות GLPN Depth
GLPN Depth הוא מודל של Community בקטגוריית מולטימודאל. ב-Railwail, GLPN Depth עולה ≈ 0.0094 $ להרצה.
תמחור
| הרצה טיפוסית (≈ 78 s ב-CPU) | 0.0094 $ להרצה |
|---|---|
| זמן GPU (CPU) | 0.00012 $ לשנייה של GPU |
- חיוב לפי זמן ה-GPU שההרצה בעצם לוקחת. כשההרצה מתחילה, 3× המחיר הטיפוסי מוזמן מהיתרה שלך ומסולק לאחר מכן.
- 1 קרדיט = 0.01 $
מחשבון עלויות
מחשבון מחירים
טיפוסי לפי הספק: כ-78 שנ׳
סה״כ
0.94 $
94 קרדיטים
לכל הרצה
0.0094 $ · 0.94 קרדיטים
חיוב לפי זמן ה-GPU בפועל; זו הערכה.
API
אין דוגמה API מאומתת
ה-API הציבורי מעביר פורמט קלט שונה מזה שהדגם הזה צריך. השתמש בגובה המשחק למעלה.
מפרטים
- ID מודל
glpn-depth- מפתח
- Community
- קטגוריה
- מולטימודאל
- קלט
- טקסט, תמונה
- פלט
- טקסט
- חיוב
- לפי שימוש (טוקנים או זמן GPU)
- רשומת הקטלוג עודכנה
- 23 בספטמבר 2026
תגיות
- replicate
- depth
- vision-understanding
- open-source
שאלות נפוצות
מה זה GLPN Depth?
GLPN Depth הוא מודל של Community בקטגוריית מולטימודאל.
כמה עולה GLPN Depth ב-Railwail?
ב-Railwail, GLPN Depth עולה ≈ 0.0094 $ להרצה. אתה משלם על מה שכל בקשה בעצם משתמשת. השימוש משולם מקרדיטים שנרכשו מראש; 1 קרדיט שווה 0.01 $.
כמה מהיר GLPN Depth?
עדיין אין מספיק הרצות שנמדדו של GLPN Depth ב-Railwail כדי לציין זמן הרצה. זה תלוי בקלט, בהגדרות ובעומס אצל הספק.
האם GLPN Depth טוב יותר מ-BLIP?
זה תלוי במשימה. GLPN Depth (Community) ו-BLIP (Salesforce) הם שניהם מודלים בקטגוריית מולטימודאל. דף ההשוואה מציג את המחירים והמפרטים שלהם זה לצד זה.
השווה בין GLPN Depth ל-BLIPהאם GLPN Depth יכול לעבד תמונות?
כן. GLPN Depth מקבל תמונות כקלט בנוסף לטקסט.
דגמים דומים
הכל בקטגוריה זו- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
כל המודלים דרך API אחד
מפתח API אחד לכל מודל ב-Railwail. השימוש מחויב מאשראי מראש, 1 אשראי = 0.01 $.