
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Verð
- ≈ 0,0086 USD/keyrsla
- Samhengi
- 4.096 tákn
- Hámarksúttak
- 2.048 tákn
- Inntak → úttak
- Texti + Mynd → Texti
- Þróunaraðili
- DeepSeek
- Uppfært
- 23. september 2026
Leiksvæði
Prófaðu DeepSeek-VL 7B
Engin inntaksform
Engin inntaksform fyrir þetta módel ennþá
Inntök þess eru ekki skjöluð ennþá. Til að engin keyrsla mistakist á röngum inntaki bjóðum við ekki upp á form hér. Veldu sambærilegt módel í staðinn.
Examples
 Input
Prompt
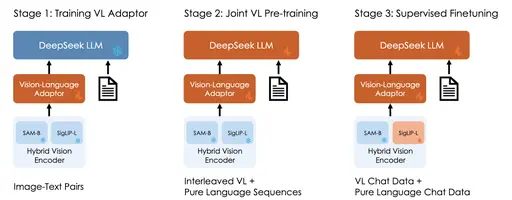
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
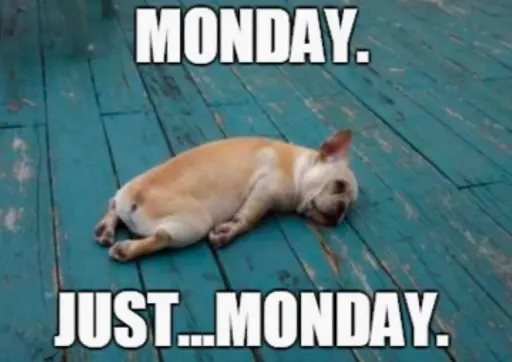
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Um DeepSeek-VL 7B
DeepSeek-VL 7B er módel frá DeepSeek í flokknum Fjölbreytilegt. Á Railwail kostar DeepSeek-VL 7B ≈ 0,0086 USD fyrir hverja keyrslu. Samhengisgluggi geymir 4.096 tákn og ein svör getur verið allt að 2.048 tákn löng.
Verðlagning
| Dæmigerð keyrsla (≈ 7 s á L40S) | 0,0086 USD fyrir hverja keyrslu |
|---|---|
| GPU-tími (L40S) | 0,00117 USD fyrir hverja GPU-sekúndu |
- Reikningsfærðir eru GPU-tíminn sem keyrslan tekur í raun. Þegar keyrslan hefst er 3× dæmigerðu verðinu frátekin frá inneign þinni og jöfnuð síðar.
- 1 inneign = 0,01 USD
Kostnaðarreiknir
Verðreiknir
Dæmigert samkvæmt veitanda: um 7,3 s
Samtals
0,86 USD
86 inneign
Fyrir hverja keyrslu
0,0086 USD · 0,86 inneign
Innheimt er fyrir raunverulegan GPU-tíma; þetta er mat.
API
Engin staðfest API-dæmi
Opinbera API sendir annað inntakssnið en þetta módel þarf. Notaðu leiksvæðið hér að ofan.
Forskriftir
- Módel-auðkenni
deepseek-vl-7b- Þróunaraðili
- DeepSeek
- Flokkur
- Fjölbreytilegt
- Inntak
- Texti, Mynd
- Úttak
- Texti
- Samhengisglugginn
- 4.096 tákn
- Hámark úttak
- 2.048 tákn
- Reikningur
- Eftir notkun (tókar eða GPU-tími)
- Vörulistafærsla uppfærð
- 23. september 2026
Merki
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Algengar spurningar
Hvað er DeepSeek-VL 7B?
DeepSeek-VL 7B er módel frá DeepSeek í flokknum Fjölbreytilegt.
Hvað kostar DeepSeek-VL 7B á Railwail?
Á Railwail kostar DeepSeek-VL 7B ≈ 0,0086 USD fyrir hverja keyrslu. Þér er rukkað fyrir það sem hver beiðni notar í raun. Notkun er greidd úr fyrirframgreiddum inneign; 1 inneign jafngildir 0,01 USD.
Hversu stór er samhengisgluggi DeepSeek-VL 7B?
Samhengisgluggi DeepSeek-VL 7B geymir 4.096 tákn. Ein svör getur verið allt að 2.048 tákn löng.
Hversu hratt er DeepSeek-VL 7B?
Það eru ekki nóg mældar keyrslur af DeepSeek-VL 7B á Railwail ennþá til að tilgreina keyrslutíma. Það fer eftir inntakinu, stillingum og álagi hjá veitandanum.
Er DeepSeek-VL 7B betra en BLIP?
Það fer eftir verkefninu. DeepSeek-VL 7B (DeepSeek) og BLIP (Salesforce) eru bæði módel í flokknum Fjölbreytilegt. Samanburðarsíðan sýnir verð og forskriftir þeirra hlið við hlið.
Bera saman DeepSeek-VL 7B og BLIPGetur DeepSeek-VL 7B unnið úr myndum?
Já. DeepSeek-VL 7B tekur myndir sem inntok auk texta.
Sambærileg módel
Öll í þessum flokki- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Öll módel í gegnum eina API
Einn API-lykil fyrir öll módel á Railwail. Notkun er rukkuð frá fyrirframgreiddum inneign, 1 inneign = 0,01 USD.