
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Verð
- ≈ 0,0012 USD/keyrsla
- Inntak → úttak
- Texti + Mynd → Texti
- Þróunaraðili
- Community
- Uppfært
- 23. september 2026
Leiksvæði
Prófaðu Florence-2 Large
Inntak og úttak
Þessi keyrsla
um 0,0012 USD · 0,12 inneign
0,0036 USD (0,36 inneign) eru fráteknar við upphaf; raunverulegur GPU-tími er innheimtaður.
Nýr hér?
10 ókeypis inneign (0,10 USD) þegar þú skráir þig með Google
Hægt að nota 24 klst. eftir skráningu, allt að 5 keyrslur á dag og að hámarki 2 inneign á keyrslu. Aðrar innskráningaraðferðir byrja án inneignar. Nægir fyrir 27 keyrslur þessa módels.
Examples
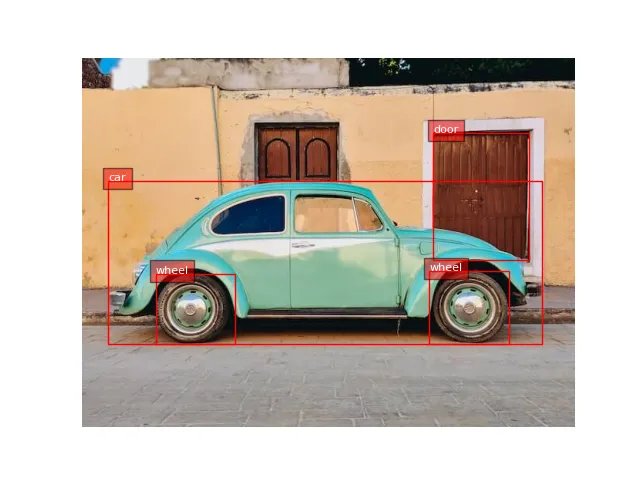 Open full size
 Input
No text prompt: the model only takes the input shown.
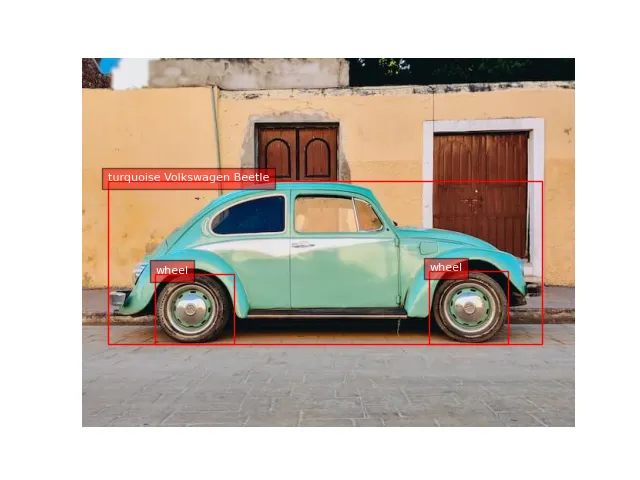 Open full size
 Input
No text prompt: the model only takes the input shown.
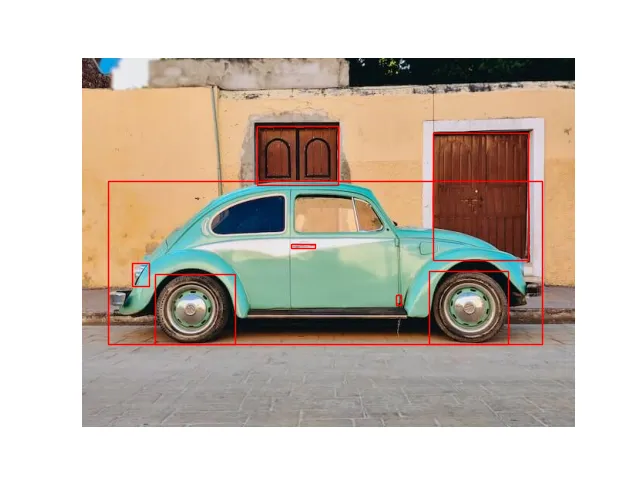 Open full size
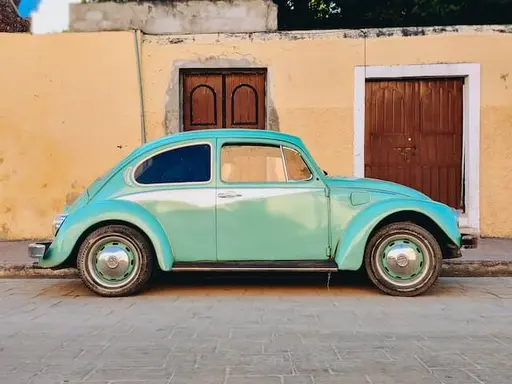 Input
No text prompt: the model only takes the input shown.
Um Florence-2 Large
Florence-2 Large er módel frá Community í flokknum Fjölbreytilegt. Á Railwail kostar Florence-2 Large ≈ 0,0012 USD fyrir hverja keyrslu.
Verðlagning
| Dæmigerð keyrsla (≈ 1 s á L40S) | 0,0012 USD fyrir hverja keyrslu |
|---|---|
| GPU-tími (L40S) | 0,00117 USD fyrir hverja GPU-sekúndu |
- Reikningsfærðir eru GPU-tíminn sem keyrslan tekur í raun. Þegar keyrslan hefst er 3× dæmigerðu verðinu frátekin frá inneign þinni og jöfnuð síðar.
- 1 inneign = 0,01 USD
Kostnaðarreiknir
Verðreiknir
Dæmigert samkvæmt veitanda: um 1 s
Samtals
0,12 USD
12 inneign
Fyrir hverja keyrslu
0,0012 USD · 0,12 inneign
Innheimt er fyrir raunverulegan GPU-tíma; þetta er mat.
API
Engin staðfest API-dæmi
Opinbera API sendir annað inntakssnið en þetta módel þarf. Notaðu leiksvæðið hér að ofan.
Forskriftir
- Módel-auðkenni
florence-2-large- Þróunaraðili
- Community
- Flokkur
- Fjölbreytilegt
- Inntak
- Texti, Mynd
- Úttak
- Texti
- Reikningur
- Eftir notkun (tókar eða GPU-tími)
- Vörulistafærsla uppfærð
- 23. september 2026
Inntaksbreytur
Inntak og stillingar úr inntakskerfi módelsins. Dæmið í API-hlutanum sýnir hverjar þeirra API samþykkir.
promptnauðsynlegtUser message or task instruction
Tegund: TextiSjálfgefið: –Leyfðir gildir: allt að 4.000 stafirtaskTegund: ValSjálfgefið:captionLeyfðir gildir: caption, detailed_caption, ocr, object_detection eða segmentationimage_urlImage URL to analyze
Tegund: TextiSjálfgefið: –Leyfðir gildir: –max_tokensTegund: HeiltalaSjálfgefið:1024Leyfðir gildir: 1 til 4.096temperatureTegund: TalaSjálfgefið:0.7Leyfðir gildir: 0 til 2
Merki
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Algengar spurningar
Hvað er Florence-2 Large?
Florence-2 Large er módel frá Community í flokknum Fjölbreytilegt.
Hvað kostar Florence-2 Large á Railwail?
Á Railwail kostar Florence-2 Large ≈ 0,0012 USD fyrir hverja keyrslu. Þér er rukkað fyrir það sem hver beiðni notar í raun. Notkun er greidd úr fyrirframgreiddum inneign; 1 inneign jafngildir 0,01 USD.
Hvaða stillingar styður Florence-2 Large?
Samkvæmt inntaksskema sínu þekkir Florence-2 Large þessa færibreytu: prompt (allt að 4.000 stafir), task (caption, detailed_caption, ocr, object_detection eða segmentation), image_url, max_tokens (1 til 4.096) og temperature (0 til 2).
Hversu hratt er Florence-2 Large?
Það eru ekki nóg mældar keyrslur af Florence-2 Large á Railwail ennþá til að tilgreina keyrslutíma. Það fer eftir inntakinu, stillingum og álagi hjá veitandanum.
Er Florence-2 Large betra en BLIP?
Það fer eftir verkefninu. Florence-2 Large (Community) og BLIP (Salesforce) eru bæði módel í flokknum Fjölbreytilegt. Samanburðarsíðan sýnir verð og forskriftir þeirra hlið við hlið.
Bera saman Florence-2 Large og BLIPGetur Florence-2 Large unnið úr myndum?
Já. Florence-2 Large tekur myndir sem inntok auk texta.
Sambærileg módel
Öll í þessum flokki- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Öll módel í gegnum eina API
Einn API-lykil fyrir öll módel á Railwail. Notkun er rukkuð frá fyrirframgreiddum inneign, 1 inneign = 0,01 USD.