
Segformer B5
segformer-b5NVIDIA SegFormer-B5 semantic segmentation. Hierarchical transformer encoder with lightweight MLP decoder, strong ADE20k and Cityscapes results.
- Verð
- ≈ 0,00030 USD/keyrsla
- Inntak → úttak
- Texti + Mynd → Texti
- Þróunaraðili
- Community
- Uppfært
- 23. september 2026
Leiksvæði
Prófaðu Segformer B5
Engin inntaksform
Engin inntaksform fyrir þetta módel ennþá
Inntök þess eru ekki skjöluð ennþá. Til að engin keyrsla mistakist á röngum inntaki bjóðum við ekki upp á form hér. Veldu sambærilegt módel í staðinn.
Examples
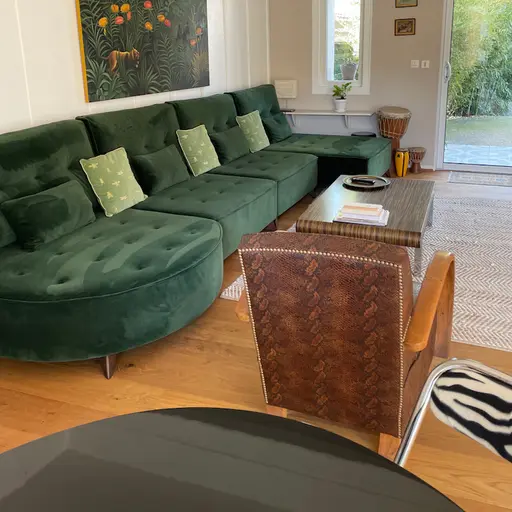 Input
No text prompt: the model only takes the input shown.
Output (JSON, shortened)
[
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAJrklEQVR4nO3d2XbjthIFUDIr///LykNst9oiJQ4YCqi9H+5K36QtiTyHBcga1sfS2Nr6BhtofhDfq3iIPz7SI7dd5IcU8k+7m4J4FIDUFKCEGZd1SbQvQLD1MrmZAKSmAKSmAEXYBIxKAWgt1C7w3/Y3+XC5HNbd7IbK/rIsXQpANmdj3/IKaQlEUa9hf8S77D9RgDIiLev63pdfcY8df0sgint8NzB49P+nABQ3RPK/WAKRmgKQmgIQTdN…",
    "label": "wall",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAARoklEQVR4nO3d2XaruBYFUHzH+f9f5j4kqThuMI22tCXN+VB1uiQYrYUExvayAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAA…",
    "label": "floor",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAD/ElEQVR4nO3cUWrCQBRAUVO6/y3bj2IrtOJECMF3z1lAmOC7iegk24Vxrscdejvu0Of4OHsBcCYBkCYA0gRAmgBIEwBpAiBNAKQJgB3G/Q8mANoEQJoA5jlwK9A8AiBNAKQJgDQBkCYA0gRAmgBIEwBpAiBNAKQJgDQBkCYA0gRAmgBYN++BMAHQJgDSBECaAEgTAGkCIE0ApAmANAGQJgDSBECaAEgTAGkCIE0ApAmANAGQJgDSBECaAEg…",
    "label": "windowpane",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAErklEQVR4nO3dMVLDUAxAQcL97xxKKOggkjJv9wJq/GZsf439+IBrnnOjPudGwT0CIE0ApAmANAGQJgDSBECaAEgTAGkC4JzBg2AB0CYA0gRAmgBIEwBpAiBNAFwz+RZUALQJgDQBkCYA0gRAmgC45jE5TACkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANI…",
    "label": "door",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANS…
Um Segformer B5
Segformer B5 er módel frá Community í flokknum Fjölbreytilegt. Á Railwail kostar Segformer B5 ≈ 0,00030 USD fyrir hverja keyrslu.
Verðlagning
| Dæmigerð keyrsla (≈ 1 s á T4) | 0,00030 USD fyrir hverja keyrslu |
|---|---|
| GPU-tími (T4) | 0,00027 USD fyrir hverja GPU-sekúndu |
- Reikningsfærðir eru GPU-tíminn sem keyrslan tekur í raun. Þegar keyrslan hefst er 3× dæmigerðu verðinu frátekin frá inneign þinni og jöfnuð síðar.
- 1 inneign = 0,01 USD
Kostnaðarreiknir
Verðreiknir
Dæmigert samkvæmt veitanda: um 1 s
Samtals
0,03 USD
3 inneign
Fyrir hverja keyrslu
0,0003 USD · 0,03 inneign
Innheimt er fyrir raunverulegan GPU-tíma; þetta er mat.
API
Engin staðfest API-dæmi
Opinbera API sendir annað inntakssnið en þetta módel þarf. Notaðu leiksvæðið hér að ofan.
Forskriftir
- Módel-auðkenni
segformer-b5- Þróunaraðili
- Community
- Flokkur
- Fjölbreytilegt
- Inntak
- Texti, Mynd
- Úttak
- Texti
- Reikningur
- Eftir notkun (tókar eða GPU-tími)
- Vörulistafærsla uppfærð
- 23. september 2026
Merki
- replicate
- segmentation
- vision-understanding
- nvidia
- open-weights
Algengar spurningar
Hvað er Segformer B5?
Segformer B5 er módel frá Community í flokknum Fjölbreytilegt.
Hvað kostar Segformer B5 á Railwail?
Á Railwail kostar Segformer B5 ≈ 0,00030 USD fyrir hverja keyrslu. Þér er rukkað fyrir það sem hver beiðni notar í raun. Notkun er greidd úr fyrirframgreiddum inneign; 1 inneign jafngildir 0,01 USD.
Hversu hratt er Segformer B5?
Það eru ekki nóg mældar keyrslur af Segformer B5 á Railwail ennþá til að tilgreina keyrslutíma. Það fer eftir inntakinu, stillingum og álagi hjá veitandanum.
Er Segformer B5 betra en BLIP?
Það fer eftir verkefninu. Segformer B5 (Community) og BLIP (Salesforce) eru bæði módel í flokknum Fjölbreytilegt. Samanburðarsíðan sýnir verð og forskriftir þeirra hlið við hlið.
Bera saman Segformer B5 og BLIPGetur Segformer B5 unnið úr myndum?
Já. Segformer B5 tekur myndir sem inntok auk texta.
Sambærileg módel
Öll í þessum flokki- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Öll módel í gegnum eina API
Einn API-lykil fyrir öll módel á Railwail. Notkun er rukkuð frá fyrirframgreiddum inneign, 1 inneign = 0,01 USD.