
BLIP
blip-captioningSalesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- Prezzo
- ≈ 0,00030 USD/esecuzione
- Input → output
- Testo + Immagine → Testo
- Sviluppatore
- Salesforce
- Aggiornato
- 23 settembre 2026
Playground
Prova BLIP
Input e output
Questa esecuzione
circa 0,0003 USD · 0,03 crediti
0,0009 USD (0,09 crediti) sono riservati all'inizio; il tempo GPU effettivo viene fatturato.
Nuovo qui?
10 crediti gratuiti (0,10 USD) quando ti iscrivi con Google
Utilizzabile 24 ore dopo l'iscrizione, fino a 5 esecuzioni al giorno e al massimo 2 crediti per esecuzione. Altri metodi di accesso iniziano senza crediti. Sufficiente per 111 esecuzioni di questo modello.
Examples
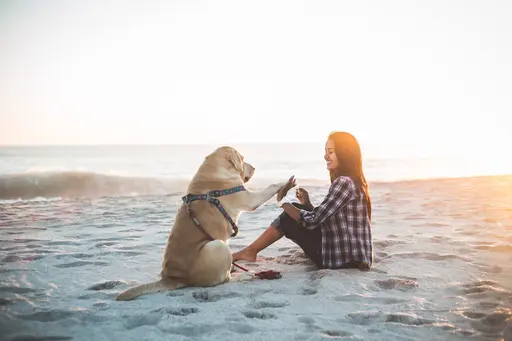 Input
Prompt
image_captioning
Output (JSON, shortened)
[ { "text": "Caption: a woman sitting on the beach with a dog" } ]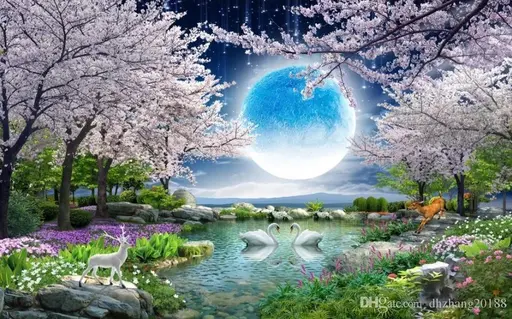 Input
Prompt
what is in the sky?
Output (JSON, shortened)
[ { "text": "Answer: moon" } ] Input
Prompt
what is in the lake?
Output (JSON, shortened)
[
  {
    "text": "Answer: swans"
  }
]
Informazioni su BLIP
BLIP è un modello di Salesforce nella categoria Multimodale. Su Railwail, BLIP costa ≈ 0,00030 USD per esecuzione.
Prezzi
| Esecuzione tipica (≈ 1 s su T4) | 0,00030 USD per esecuzione |
|---|---|
| Tempo GPU (T4) | 0,00027 USD per secondo GPU |
- Fatturato in base al tempo GPU effettivamente utilizzato. All'avvio, 3× il prezzo tipico viene riservato dal tuo saldo e regolato successivamente.
- 1 credito = 0,01 USD
Calcolatore di costi
Calcolatore prezzi
Tipico secondo il provider: circa 1 s
Totale
0,03 USD
3 crediti
Per esecuzione
0,0003 USD · 0,03 crediti
Fatturato in base al tempo GPU effettivo; questo è una stima.
API
Nessun esempio API verificato
L'API pubblica passa un formato di input diverso da quello richiesto da questo modello. Usa il playground sopra.
Specifiche
- ID modello
blip-captioning- Sviluppatore
- Salesforce
- Categoria
- Multimodale
- Input
- Testo, Immagine
- Output
- Testo
- Fatturazione
- In base all'utilizzo (token o tempo GPU)
- Voce di catalogo aggiornata
- 23 settembre 2026
Parametri di input
Input e impostazioni dallo schema di input del modello. L'esempio nella sezione API mostra quali di essi l'API accetta.
imageObbligatorioImage to caption or ask about
Tipo: TestoPredefinito: –Valori consentiti: –taskTipo: SceltaPredefinito:image_captioningValori consentiti: image_captioning o visual_question_answeringquestionQuestion for visual question answering mode
Tipo: TestoPredefinito: –Valori consentiti: –
Etichette
- replicate
- blip
- captioning
- vqa
- salesforce
- vision-understanding
- image
Domande frequenti
Cos'è BLIP?
BLIP è un modello di Salesforce nella categoria Multimodale.
Quanto costa BLIP su Railwail?
Su Railwail, BLIP costa ≈ 0,00030 USD per esecuzione. Ti viene addebitato ciò che ogni richiesta utilizza effettivamente. L'utilizzo viene pagato con crediti prepagati; 1 credito equivale a 0,01 USD.
Quali impostazioni supporta BLIP?
Secondo il suo schema di input, BLIP conosce questi parametri: image, task (image_captioning o visual_question_answering) e question.
Quanto è veloce BLIP?
Non ci sono ancora abbastanza esecuzioni misurate di BLIP su Railwail per indicare un tempo di esecuzione. Dipende dall'input, dalle impostazioni e dal carico presso il provider.
BLIP è migliore di CLIP Interrogator?
Dipende dall'attività. BLIP (Salesforce) e CLIP Interrogator (Community) sono entrambi modelli nella categoria Multimodale. La pagina di confronto mostra i loro prezzi e le specifiche affiancati.
Confronta BLIP e CLIP InterrogatorBLIP può elaborare immagini?
Sì. BLIP accetta immagini come input oltre al testo.
Modelli comparabili
Tutti in questa categoria- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Meta Segment Anything 2. Promptable segmentation across images and video with temporal memory. Zero-shot, point/box/mask prompts, fast on a single H100.
Tutti i modelli tramite un'API
Una chiave API per tutti i modelli su Railwail. L'utilizzo viene addebitato da crediti prepagati, 1 credito = 0,01 USD.