
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Kaina
- ≈ 0,0086 USD/paleidimas
- Kontekstas
- 4 096 žetonų
- Maks. išvestis
- 2 048 žetonų
- Įvestis → išvestis
- Tekstas + Vaizdas → Tekstas
- Kūrėjas
- DeepSeek
- Atnaujinta
- 2026 m. rugsėjo 23 d.
Žaidimų aikštelė
Išbandyti DeepSeek-VL 7B
Nėra įvesties formos
Šiam modeliui dar nėra įvesties formos
Jo įvestys dar nėra dokumentuotos. Kad vykdymas nepraeitų dėl neteisingos įvesties, čia nesiūlome formos. Pasirinkite panašų modelį.
Examples
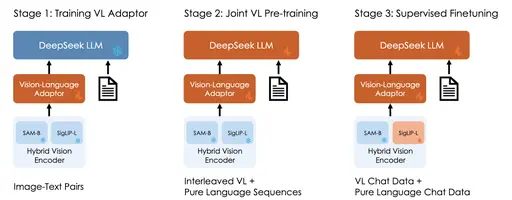 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
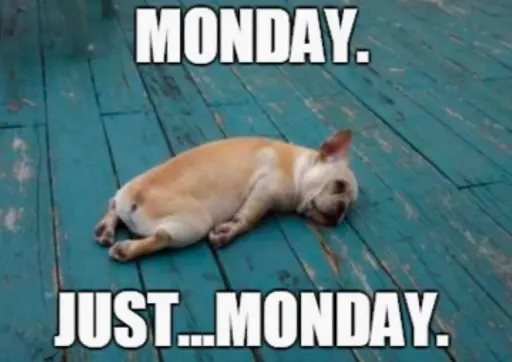 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Apie DeepSeek-VL 7B
DeepSeek-VL 7B yra DeepSeek modelis iš Multimodalus kategorijos. Per Railwail DeepSeek-VL 7B kainuoja ≈ 0,0086 USD už vieną paleidimą. Konteksto langas saugo 4 096 žetonų, o vienas atsakymas gali būti iki 2 048 žetonų ilgio.
Kainos
| Tipinis paleidimas (≈ 7 s su L40S) | 0,0086 USD už vieną paleidimą |
|---|---|
| GPU laikas (L40S) | 0,00117 USD už GPU sekundę |
- Apmokestinama pagal GPU laiką, kurio iš tikrųjų reikia paleidimui. Paleidimui pradėjus, iš jūsų balanso rezervuojamas 3× tipinis kaina ir vėliau sudengiama.
- 1 kreditas = 0,01 USD
Kainos skaičiuoklė
Kainos skaičiuoklė
Tipiškai pagal teikėją: apie 7,3 s
Iš viso
0,86 USD
86 kreditai
Per paleidimą
0,0086 USD · 0,86 kreditai
Sąskaitoje faktinis GPU laikas; tai yra sąmata.
API
Nėra patikrinto API pavyzdžio
Viešoji API perduoda kitą įvesties formatą nei šis modelis reikalingas. Naudokite aukščiau esančią žaidimų aikštelę.
Specifikacijos
- Modelio ID
deepseek-vl-7b- Kūrėjas
- DeepSeek
- Kategorija
- Multimodalus
- Įvestis
- Tekstas, Vaizdas
- Išvestis
- Tekstas
- Konteksto langas
- 4 096 žetonų
- Maks. išvestis
- 2 048 žetonų
- Sąskaita
- Pagal naudojimą (žetonai arba GPU laikas)
- Katalogo įrašas atnaujintas
- 2026 m. rugsėjo 23 d.
Žymos
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Dažnai užduodami klausimai
Kas yra DeepSeek-VL 7B?
DeepSeek-VL 7B yra DeepSeek modelis iš Multimodalus kategorijos.
Kiek kainuoja DeepSeek-VL 7B Railwail?
Per Railwail DeepSeek-VL 7B kainuoja ≈ 0,0086 USD už vieną paleidimą. Jums sąskaitoje pateikiama suma, kurią iš tikrųjų sunaudoja kiekvienas užklausa. Naudojimas apmokamas iš išanksto nupirktų kreditų; 1 kreditas = 0,01 USD.
Koks yra DeepSeek-VL 7B konteksto langas?
DeepSeek-VL 7B konteksto langas saugo 4 096 žetonų. Vienas atsakymas gali būti iki 2 048 žetonų ilgio.
Koks yra DeepSeek-VL 7B greitis?
DeepSeek-VL 7B Railwail platformoje dar nėra pakankamai išmatuotų vykdymų, kad būtų galima nurodyti vykdymo laiką. Jis priklauso nuo įvesties, nustatymų ir teikėjo apkrovos.
Ar DeepSeek-VL 7B geriau nei BLIP?
Tai priklauso nuo užduoties. DeepSeek-VL 7B (DeepSeek) ir BLIP (Salesforce) yra abu modeliai iš Multimodalus kategorijos. Palyginimo puslapyje jų kainos ir specifikacijos rodomos viena šalia kitos.
Palyginti DeepSeek-VL 7B ir BLIPAr DeepSeek-VL 7B gali apdoroti vaizdus?
Taip. DeepSeek-VL 7B priima vaizdus kaip įvestį, be teksto.
Panašūs modeliai
Visi šioje kategorijoje- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Visi modeliai per vieną API
Vienas API raktas visiems Railwail modeliams. Naudojimas apmokestinamas iš iš anksto nupirktų kreditų, 1 kreditas = 0,01 USD.