
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Kaina
- ≈ 0,0012 USD/paleidimas
- Įvestis → išvestis
- Tekstas + Vaizdas → Tekstas
- Kūrėjas
- Community
- Atnaujinta
- 2026 m. rugsėjo 23 d.
Žaidimų aikštelė
Išbandyti Florence-2 Large
Įvestis ir rezultatas
Šis paleidimas
apie 0,0012 USD · 0,12 kreditai
Pradžioje rezervuojama 0,0036 USD (0,36 kreditai); sąskaita sudaroma pagal faktinį GPU laiką.
Naujas čia?
10 nemokami kreditai (0,10 USD), kai užsiregistruojate naudodami Google
Galima naudoti 24 valandų po registracijos, iki 5 paleidimų per dieną ir daugiausia 2 kreditų per paleidimą. Kiti prisijungimo būdai pradedami be kreditų. Pakanka 27 šio modelio paleidimams.
Examples
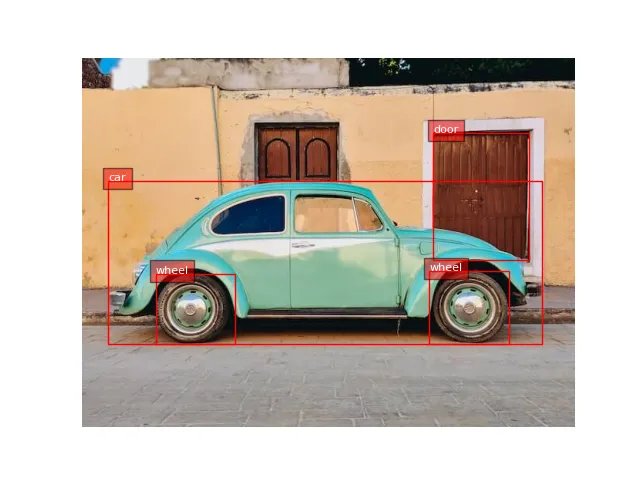 Open full size
 Input
No text prompt: the model only takes the input shown.
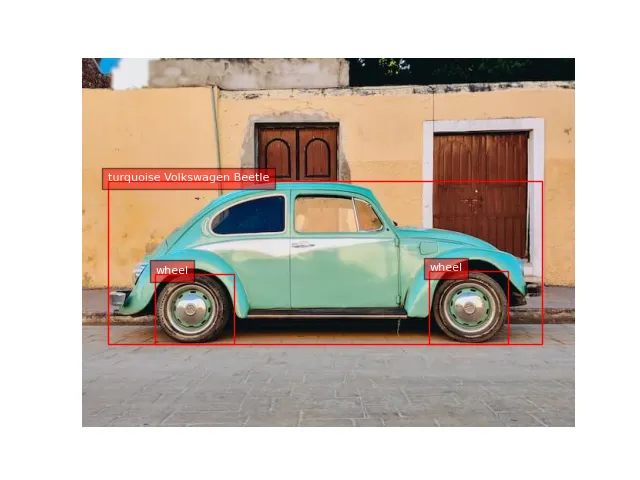 Open full size
 Input
No text prompt: the model only takes the input shown.
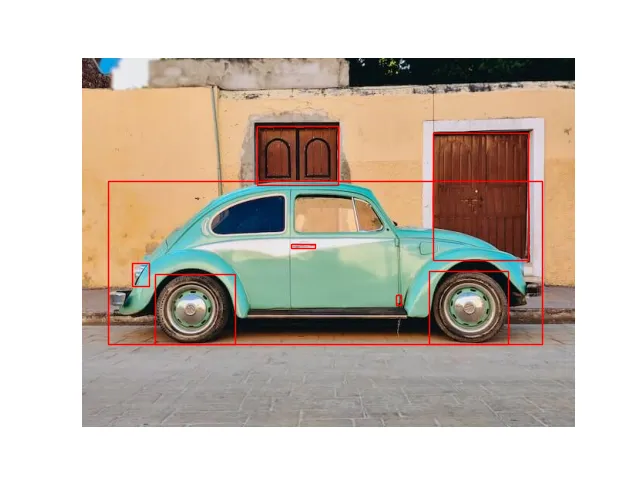 Open full size
 Input
No text prompt: the model only takes the input shown.
Apie Florence-2 Large
Florence-2 Large yra Community modelis iš Multimodalus kategorijos. Per Railwail Florence-2 Large kainuoja ≈ 0,0012 USD už vieną paleidimą.
Kainos
| Tipinis paleidimas (≈ 1 s su L40S) | 0,0012 USD už vieną paleidimą |
|---|---|
| GPU laikas (L40S) | 0,00117 USD už GPU sekundę |
- Apmokestinama pagal GPU laiką, kurio iš tikrųjų reikia paleidimui. Paleidimui pradėjus, iš jūsų balanso rezervuojamas 3× tipinis kaina ir vėliau sudengiama.
- 1 kreditas = 0,01 USD
Kainos skaičiuoklė
Kainos skaičiuoklė
Tipiškai pagal teikėją: apie 1 s
Iš viso
0,12 USD
12 kreditai
Per paleidimą
0,0012 USD · 0,12 kreditai
Sąskaitoje faktinis GPU laikas; tai yra sąmata.
API
Nėra patikrinto API pavyzdžio
Viešoji API perduoda kitą įvesties formatą nei šis modelis reikalingas. Naudokite aukščiau esančią žaidimų aikštelę.
Specifikacijos
- Modelio ID
florence-2-large- Kūrėjas
- Community
- Kategorija
- Multimodalus
- Įvestis
- Tekstas, Vaizdas
- Išvestis
- Tekstas
- Sąskaita
- Pagal naudojimą (žetonai arba GPU laikas)
- Katalogo įrašas atnaujintas
- 2026 m. rugsėjo 23 d.
Įvesties parametrai
Įvestys ir nustatymai iš modelio įvesties schemos. API sekcijoje pateiktas pavyzdys rodo, kuriuos iš jų priima API.
promptprivalomasUser message or task instruction
Tipas: TekstasNumatytasis: –Leidžiamos reikšmės: iki 4 000 simboliųtaskTipas: PasirinkimasNumatytasis:captionLeidžiamos reikšmės: caption, detailed_caption, ocr, object_detection ar segmentationimage_urlImage URL to analyze
Tipas: TekstasNumatytasis: –Leidžiamos reikšmės: –max_tokensTipas: Sveikasis skaičiusNumatytasis:1024Leidžiamos reikšmės: 1 iki 4 096temperatureTipas: SkaičiusNumatytasis:0.7Leidžiamos reikšmės: 0 iki 2
Žymos
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Dažnai užduodami klausimai
Kas yra Florence-2 Large?
Florence-2 Large yra Community modelis iš Multimodalus kategorijos.
Kiek kainuoja Florence-2 Large Railwail?
Per Railwail Florence-2 Large kainuoja ≈ 0,0012 USD už vieną paleidimą. Jums sąskaitoje pateikiama suma, kurią iš tikrųjų sunaudoja kiekvienas užklausa. Naudojimas apmokamas iš išanksto nupirktų kreditų; 1 kreditas = 0,01 USD.
Kokius nustatymus palaiko Florence-2 Large?
Pagal jos įvesties schemą, Florence-2 Large žino šiuos parametrus: prompt (iki 4 000 simbolių), task (caption, detailed_caption, ocr, object_detection ar segmentation), image_url, max_tokens (1 iki 4 096) ir temperature (0 iki 2).
Koks yra Florence-2 Large greitis?
Florence-2 Large Railwail platformoje dar nėra pakankamai išmatuotų vykdymų, kad būtų galima nurodyti vykdymo laiką. Jis priklauso nuo įvesties, nustatymų ir teikėjo apkrovos.
Ar Florence-2 Large geriau nei BLIP?
Tai priklauso nuo užduoties. Florence-2 Large (Community) ir BLIP (Salesforce) yra abu modeliai iš Multimodalus kategorijos. Palyginimo puslapyje jų kainos ir specifikacijos rodomos viena šalia kitos.
Palyginti Florence-2 Large ir BLIPAr Florence-2 Large gali apdoroti vaizdus?
Taip. Florence-2 Large priima vaizdus kaip įvestį, be teksto.
Panašūs modeliai
Visi šioje kategorijoje- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Visi modeliai per vieną API
Vienas API raktas visiems Railwail modeliams. Naudojimas apmokestinamas iš iš anksto nupirktų kreditų, 1 kreditas = 0,01 USD.