
Llama 3.2 Vision 11B (Ollama)
llama-3-2-vision-11b-ollamaMeta Llama 3.2 11B Vision served via Ollama on Replicate. Open-weights multimodal model for image captioning, document and chart reading, and visual question answering.
- Prix
- ≈ 0,0039 $US/exécution
- Entrée → Sortie
- Texte + Image → Texte
- Développeur
- Community
- Mis à jour
- 23 septembre 2026
Playground
Essayer Llama 3.2 Vision 11B (Ollama)
Entrée & résultat
Cette exécution
environ 0,0039 $US · 0,39 crédits
0,0116 $US (1,16 crédits) sont réservés au démarrage ; le temps GPU réel est facturé.
Nouveau par ici ?
10 crédits gratuits (0,10 $US) lors de l'inscription avec Google
Utilisable 24 heures après l'inscription, jusqu'à 5 exécutions par jour et au maximum 2 crédits par exécution. Les autres méthodes de connexion commencent sans crédits. Suffisant pour 8 exécutions de ce modèle.
Examples
 Input
Prompt
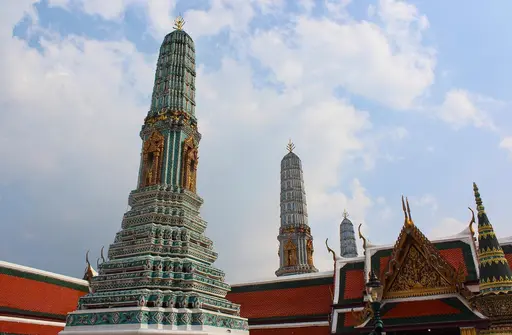
Where to find this monument? Can you give me other recommendations around the area?
Response
**Wat Phra Kaew (Temple of the Emerald Buddha)** in Bangkok, Thailand. Located within the Grand Palace complex, Wat Phra Kaew is a highly revered and sacred site that houses the iconic Emerald Buddha image. The temple's design incorporates traditional Thai architecture with intricate details and ornate decorations, featuring an imposing spire topped by a golden finial adorned with images of mythical creatures. **Recommendations for Your Visit:** * **Grand Palace**: Explore the sprawling palace grounds, which include several other notable temples and buildings. * **Wat Arun (Temple of Dawn)**: A nearby temple famous for its distinctive spire covered in colorful ceramics and glints of gold. * **Chao Phraya River Cruise**: Take a boat ride along the river to admire the city's skyline and learn about its history. * **Jim Thompson House Museum**: Visit this museum dedicated to Thai art and culture, featuring traditional architecture and beautiful gardens. Wat Phra Kaew is an absolute must-visit attraction when in Bangkok. With these recommendations, you'll have a well-rounded experience of the city's rich cultural heritage.
 Input
Prompt
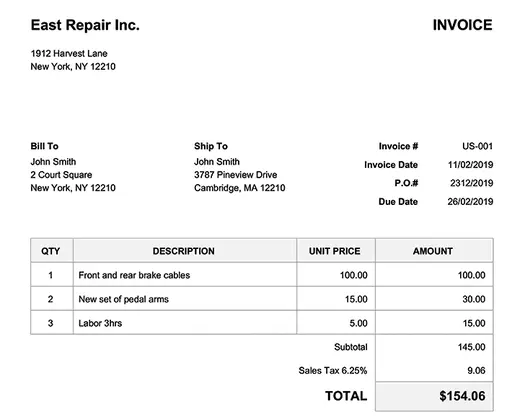
How long does it take from invoice date to due date? Be short and concise.
Response
From the invoice date of 11/02/2019 to the due date of 26/02/2019, there is a difference of **15 days**. This calculation was performed by subtracting the invoice date from the due date: 26/02/2019 - 11/02/2019 = 15
 Input
Prompt
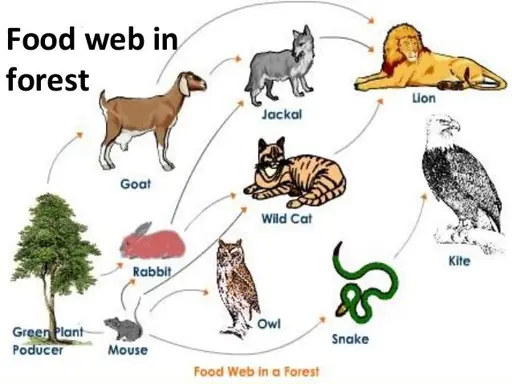
What happens when you take out white cat from this chain?
Response
The white cat is not present in the food web. The correct term for a wild animal would be "wildcat." If we were to remove a wildcat from the ecosystem, it would no longer be able to hunt or prey on other animals. This could have cascading effects throughout the entire ecosystem. *Answer*: Wildcat will lose its source of food and nutrients
À propos de Llama 3.2 Vision 11B (Ollama)
Llama 3.2 Vision 11B (Ollama) est un modèle de Community dans la catégorie Multimodal. Sur Railwail, Llama 3.2 Vision 11B (Ollama) coûte ≈ 0,0039 $US par exécution.
Tarification
| Exécution typique (≈ 3 s sur L40S) | 0,0039 $US par exécution |
|---|---|
| Temps GPU (L40S) | 0,00117 $US par seconde GPU |
- Facturée selon le temps GPU que l'exécution prend réellement. Au démarrage, 3× le prix typique est réservé de votre solde et régularisé ensuite.
- 1 crédit = 0,01 $US
Calculateur de coûts
Calculatrice de prix
Typique selon le fournisseur : environ 3,3 s
Total
0,39 $US
39 crédits
Par exécution
0,0039 $US · 0,39 crédits
Facturé selon le temps GPU réel ; il s'agit d'une estimation.
API
Aucun exemple API vérifié
L'API publique transmet un format d'entrée différent de celui dont ce modèle a besoin. Utilisez le playground ci-dessus.
Spécifications
- ID du modèle
llama-3-2-vision-11b-ollama- Développeur
- Community
- Catégorie
- Multimodal
- Entrée
- Texte, Image
- Sortie
- Texte
- Facturation
- À l'usage (tokens ou temps GPU)
- Entrée du catalogue mise à jour
- 23 septembre 2026
Paramètres d'entrée
Entrées et paramètres du schéma d'entrée du modèle. L'exemple dans la section API montre lesquels l'API accepte.
promptObligatoireQuestion about the image
Type: TexteDéfaut: –Valeurs autorisées: jusqu'à 16.000 caractèresimage_urlImage URL to analyze
Type: TexteDéfaut: –Valeurs autorisées: –max_tokensType: Nombre entierDéfaut:1024Valeurs autorisées: 1 à 4.096temperatureType: NombreDéfaut:0.7Valeurs autorisées: 0 à 2
Étiquettes
- replicate
- meta
- llama
- vision-understanding
- open-weights
- ollama
Questions fréquemment posées
Qu'est-ce que Llama 3.2 Vision 11B (Ollama) ?
Llama 3.2 Vision 11B (Ollama) est un modèle de Community dans la catégorie Multimodal.
Combien coûte Llama 3.2 Vision 11B (Ollama) sur Railwail ?
Sur Railwail, Llama 3.2 Vision 11B (Ollama) coûte ≈ 0,0039 $US par exécution. Vous êtes facturé pour ce que chaque requête utilise réellement. L'utilisation est payée à partir de crédits prépayés ; 1 crédit équivaut à 0,01 $US.
Quels paramètres Llama 3.2 Vision 11B (Ollama) supporte-t-il ?
Selon son schéma d'entrée, Llama 3.2 Vision 11B (Ollama) connaît ces paramètres : prompt (jusqu'à 16.000 caractères), image_url, max_tokens (1 à 4.096) et temperature (0 à 2).
Quelle est la vitesse de Llama 3.2 Vision 11B (Ollama) ?
Il n'y a pas encore assez d'exécutions mesurées de Llama 3.2 Vision 11B (Ollama) sur Railwail pour indiquer un temps d'exécution. Cela dépend de l'entrée, des paramètres et de la charge chez le fournisseur.
Llama 3.2 Vision 11B (Ollama) est-il meilleur que BLIP ?
Cela dépend de la tâche. Llama 3.2 Vision 11B (Ollama) (Community) et BLIP (Salesforce) sont tous deux des modèles de la catégorie Multimodal. La page de comparaison affiche leurs prix et spécifications côte à côte.
Comparer Llama 3.2 Vision 11B (Ollama) et BLIPLlama 3.2 Vision 11B (Ollama) peut-il traiter des images ?
Oui. Llama 3.2 Vision 11B (Ollama) accepte les images en entrée en plus du texte.
Modèles comparables
Tous dans cette catégorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ 0,0457 $US/exécution
1.072 % plus cher par unité
Comparer Llama 3.2 Vision 11B (Ollama) et CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ 0,0050 $US/exécution
28 % plus cher par unité
Comparer Llama 3.2 Vision 11B (Ollama) et Depth Anything v2
Tous les modèles via une API
Une clé API pour tous les modèles sur Railwail. L'utilisation est facturée à partir de crédits prépayés, 1 crédit = 0,01 $US.