
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Cena
- ≈ 0,0114 $/palaidi
- Konteksts
- 8192 marķieri
- Maks. izvade
- 2048 marķieri
- Ievade → Izvade
- Teksts + Attēls → Teksts
- Izstrādātājs
- Community
- Atjaunināts
- 2026. gada 23. septembris
Spēļu laukums
Izmēģiniet CogVLM2 19B
Nav ievades formas
Šim modelim vēl nav ievades formas
Tā ievades vēl nav dokumentētas. Lai neviena izpilde neuztrūktos nepareizas ievades dēļ, mēs šeit nepiedāvājam formu. Tā vietā izvēlieties salīdzināmu modeli.
Examples
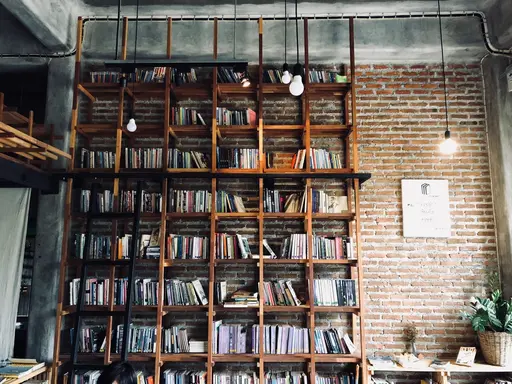 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
Par CogVLM2 19B
CogVLM2 19B ir Community modelis kategorijā Multimodāls. Railwail platformā CogVLM2 19B maksā ≈ 0,0114 $ par palaidi. Konteksta logs satur 8192 žetonus, un viena atbilde var būt līdz 2048 žetonu gara.
Cenas
| Tipisks palaidi (≈ 10 s uz L40S) | 0,0114 $ par palaidi |
|---|---|
| GPU laiks (L40S) | 0,00117 $ par GPU sekundi |
- Norēķināšana notiek par GPU laiku, ko palaidi faktiskā aizņem. Palaides sākumā no jūsu atlikuma tiek rezervēts 3× tipiskā cena un vēlāk nosegts.
- 1 kredīts = 0,01 $
Izmaksu kalkulators
Cenu kalkulators
Tipiski pēc sniedzēja: aptuveni 9,7 s
Kopā
1,14 $
114 kredīti
Uz palaišanu
0,0114 $ · 1,14 kredīti
Norēķins pēc faktiskā GPU laika; šī ir aprēķins.
API
Nav pārbaudīta API piemēra
Publiskā API nodod citu ievades formātu, nekā nepieciešams šim modelim. Izmantojiet smilšu kasti iepriekš.
Specifikācijas
- Modeļa ID
cogvlm2-19b- Izstrādātājs
- Community
- Kategorija
- Multimodāls
- Ievade
- Teksts, Attēls
- Izvade
- Teksts
- Konteksta logs
- 8192 marķieri
- Maks. izvade
- 2048 marķieri
- Norēķini
- Pēc lietojuma (tokeni vai GPU laiks)
- Kataloga ieraksts atjaunināts
- 2026. gada 23. septembris
Tagi
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Bieži uzdotie jautājumi
Kas ir CogVLM2 19B?
CogVLM2 19B ir Community izstrādāts modelis Multimodāls kategorijā.
Cik maksā CogVLM2 19B Railwail?
Railwail platformā CogVLM2 19B maksā ≈ 0,0114 $ par palaidi. Jums tiek ņemta maksa par to, ko katra pieprasījuma izpilde faktiski izmanto. Izmantošana tiek apmaksāta no iepriekš nopirkto kredītu; 1 kredīts = 0,01 $.
Kāds ir CogVLM2 19B konteksta logs?
CogVLM2 19B konteksta logs satur 8192 žetonus. Viena atbilde var būt līdz 2048 žetonu gara.
Cik ātrs ir CogVLM2 19B?
Railwail platformā CogVLM2 19B vēl nav pietiekami daudz izmērītu izpilžu, lai norādītu izpildes laiku. Tas ir atkarīgs no ievades, iestatījumiem un sniedzēja slodzes.
Vai CogVLM2 19B ir labāks par BLIP?
Tas ir atkarīgs no uzdevuma. CogVLM2 19B (Community) un BLIP (Salesforce) ir abi modeļi Multimodāls kategorijā. Salīdzināšanas lapā to cenas un specifikācijas ir parādītas blakus.
Salīdzināt CogVLM2 19B un BLIPVai CogVLM2 19B var apstrādāt attēlus?
Jā. CogVLM2 19B pieņem attēlus kā ievadi papildus tekstam.
Salīdzināmi modeļi
Visi šajā kategorijā- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Visi modeļi caur vienu API
Viena API atslēga visiem Railwail modeļiem. Izmantošana tiek aprēķināta no iepriekš apmaksātiem kredītiem, 1 kredīts = 0,01 $.