
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cena
- ≈ 0,0012 $/palaidi
- Ievade → Izvade
- Teksts + Attēls → Teksts
- Izstrādātājs
- Community
- Atjaunināts
- 2026. gada 23. septembris
Spēļu laukums
Izmēģiniet Florence-2 Large
Ievade un rezultāts
Šis palaišanas gadījums
apmēram 0,0012 $ · 0,12 kredīti
Sākumā tiek rezervēti 0,0036 $ (0,36 kredīti); tiek norēķināts faktiskais GPU laiks.
Jauns šeit?
10 bezmaksas kredīti (0,10 $), reģistrējies ar Google
Pieejams 24 stundas pēc reģistrācijas, līdz 5 palaišanas gadījumi dienā un maksimāli 2 kredīti uz palaišanas gadījumu. Citas pierakstīšanās metodes sākas bez kredītiem. Pietiek 27 šī modeļa palaišanām.
Examples
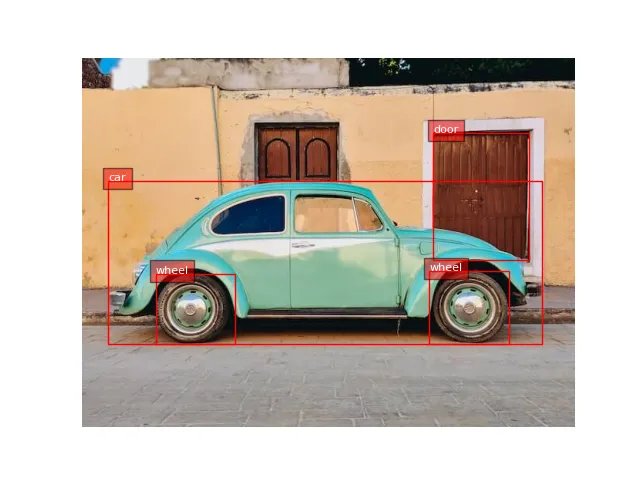 Open full size
 Input
No text prompt: the model only takes the input shown.
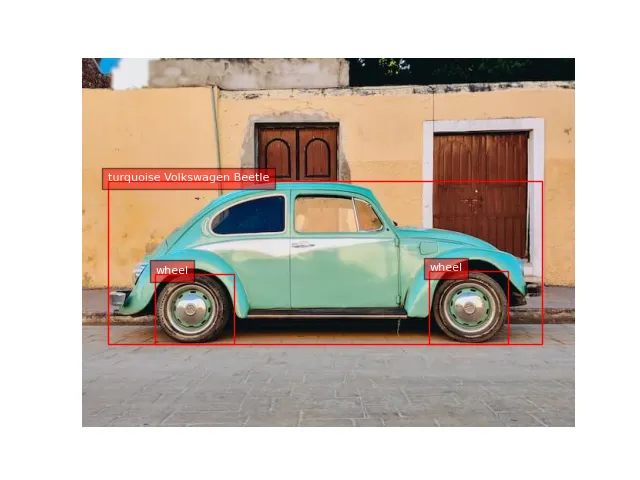 Open full size
 Input
No text prompt: the model only takes the input shown.
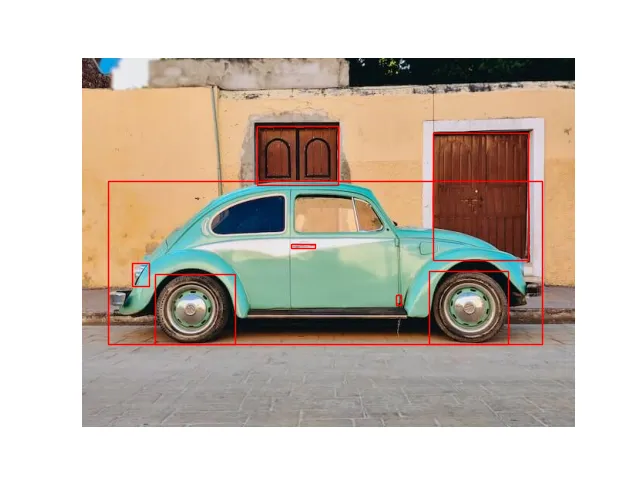 Open full size
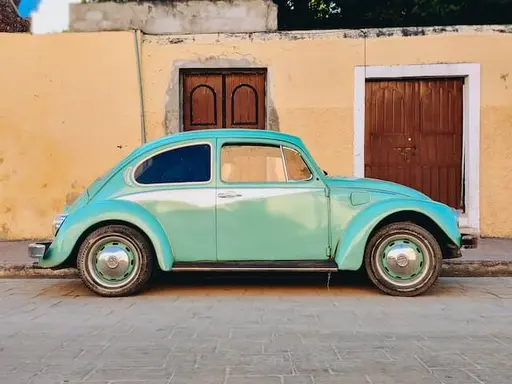 Input
No text prompt: the model only takes the input shown.
Par Florence-2 Large
Florence-2 Large ir Community modelis kategorijā Multimodāls. Railwail platformā Florence-2 Large maksā ≈ 0,0012 $ par palaidi.
Cenas
| Tipisks palaidi (≈ 1 s uz L40S) | 0,0012 $ par palaidi |
|---|---|
| GPU laiks (L40S) | 0,00117 $ par GPU sekundi |
- Norēķināšana notiek par GPU laiku, ko palaidi faktiskā aizņem. Palaides sākumā no jūsu atlikuma tiek rezervēts 3× tipiskā cena un vēlāk nosegts.
- 1 kredīts = 0,01 $
Izmaksu kalkulators
Cenu kalkulators
Tipiski pēc sniedzēja: aptuveni 1 s
Kopā
0,12 $
12 kredīti
Uz palaišanu
0,0012 $ · 0,12 kredīti
Norēķins pēc faktiskā GPU laika; šī ir aprēķins.
API
Nav pārbaudīta API piemēra
Publiskā API nodod citu ievades formātu, nekā nepieciešams šim modelim. Izmantojiet smilšu kasti iepriekš.
Specifikācijas
- Modeļa ID
florence-2-large- Izstrādātājs
- Community
- Kategorija
- Multimodāls
- Ievade
- Teksts, Attēls
- Izvade
- Teksts
- Norēķini
- Pēc lietojuma (tokeni vai GPU laiks)
- Kataloga ieraksts atjaunināts
- 2026. gada 23. septembris
Ievades parametri
Ievades un iestatījumi no modeļa ievades shēmas. Piemērs API sadaļā parāda, kurus no tiem API pieņem.
promptobligātsUser message or task instruction
Tips: TekstsNoklusējums: –Atļautās vērtības: līdz 4000 rakstzīmēmtaskTips: IzvēleNoklusējums:captionAtļautās vērtības: caption, detailed_caption, ocr, object_detection vai segmentationimage_urlImage URL to analyze
Tips: TekstsNoklusējums: –Atļautās vērtības: –max_tokensTips: Vesels skaitlisNoklusējums:1024Atļautās vērtības: 1 līdz 4096temperatureTips: SkaitlisNoklusējums:0.7Atļautās vērtības: 0 līdz 2
Tagi
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Bieži uzdotie jautājumi
Kas ir Florence-2 Large?
Florence-2 Large ir Community izstrādāts modelis Multimodāls kategorijā.
Cik maksā Florence-2 Large Railwail?
Railwail platformā Florence-2 Large maksā ≈ 0,0012 $ par palaidi. Jums tiek ņemta maksa par to, ko katra pieprasījuma izpilde faktiski izmanto. Izmantošana tiek apmaksāta no iepriekš nopirkto kredītu; 1 kredīts = 0,01 $.
Kādus iestatījumus atbalsta Florence-2 Large?
Saskaņā ar tā ievades shēmu, Florence-2 Large pazīst šos parametrus: prompt (līdz 4000 rakstzīmēm), task (caption, detailed_caption, ocr, object_detection vai segmentation), image_url, max_tokens (1 līdz 4096) un temperature (0 līdz 2).
Cik ātrs ir Florence-2 Large?
Railwail platformā Florence-2 Large vēl nav pietiekami daudz izmērītu izpilžu, lai norādītu izpildes laiku. Tas ir atkarīgs no ievades, iestatījumiem un sniedzēja slodzes.
Vai Florence-2 Large ir labāks par BLIP?
Tas ir atkarīgs no uzdevuma. Florence-2 Large (Community) un BLIP (Salesforce) ir abi modeļi Multimodāls kategorijā. Salīdzināšanas lapā to cenas un specifikācijas ir parādītas blakus.
Salīdzināt Florence-2 Large un BLIPVai Florence-2 Large var apstrādāt attēlus?
Jā. Florence-2 Large pieņem attēlus kā ievadi papildus tekstam.
Salīdzināmi modeļi
Visi šajā kategorijā- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Visi modeļi caur vienu API
Viena API atslēga visiem Railwail modeļiem. Izmantošana tiek aprēķināta no iepriekš apmaksātiem kredītiem, 1 kredīts = 0,01 $.