
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Cijena
- ≈ 0,0086 US$/pokretanje
- Kontekst
- 4.096 tokena
- Maks. izlaz
- 2.048 tokena
- Ulaz → izlaz
- Tekst + Slika → Tekst
- Razvojni inženjer
- DeepSeek
- Ažurirano
- 23. septembar 2026.
Playground
Isprobaj DeepSeek-VL 7B
Nema obrasca za unos
Za ovaj model još nema obrasca za unos
Njegovi unosi još nisu dokumentirani. Kako bi se izbjeglo neuspješno pokretanje zbog pogrešnog unosa, ovdje ne nudimo obrazac. Umjesto toga odaberi usporediv model.
Examples
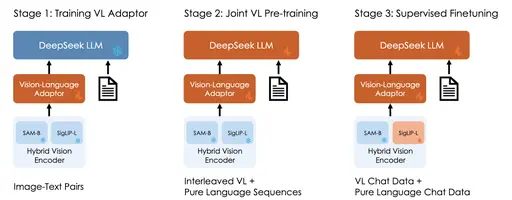 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
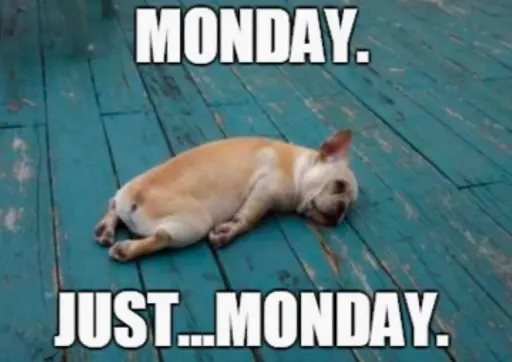 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
O DeepSeek-VL 7B
DeepSeek-VL 7B je model od DeepSeek iz kategorije Multimodalni. Na Railwailu, DeepSeek-VL 7B košta ≈ 0,0086 US$ po pokretanju. Kontekstni prozor sadrži 4.096 tokena, a jedan odgovor može biti dugačak do 2.048 tokena.
Cijene
| Tipično pokretanje (≈ 7 s na L40S) | 0,0086 US$ po pokretanju |
|---|---|
| GPU vrijeme (L40S) | 0,00117 US$ po GPU sekundi |
- Naplaćuje se prema GPU vremenu koje pokretanje zapravo traje. Kada se pokretanje počne, 3× tipična cijena se rezervira iz vašeg stanja i naknadno se namiruje.
- 1 kredit = 0,01 US$
Kalkulator troškova
Kalkulator cijena
Tipično prema pružatelju: oko 7,3 s
Ukupno
0,86 US$
86 kredita
Po pokretanju
0,0086 US$ · 0,86 kredita
Naplaćuje se stvarno GPU vrijeme; ovo je procjena.
API
Nema provjeren primjer API-ja
Javni API prosleđuje drugačiji format unosa nego što ovaj model trebuje. Koristite playground gore.
Specifikacije
- ID modela
deepseek-vl-7b- Razvojni inženjer
- DeepSeek
- Kategorija
- Multimodalni
- Ulaz
- Tekst, Slika
- Izlaz
- Tekst
- Kontekstni prozor
- 4.096 tokena
- Maks. izlaz
- 2.048 tokena
- Naplata
- Po potrošnji (tokeni ili GPU vrijeme)
- Katalog ažuriran
- 23. septembar 2026.
Oznake
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Često postavljana pitanja
Što je DeepSeek-VL 7B?
DeepSeek-VL 7B je model od DeepSeek iz kategorije Multimodalni.
Koliko stoji DeepSeek-VL 7B na Railwailu?
Na Railwailu, DeepSeek-VL 7B košta ≈ 0,0086 US$ po pokretanju. Naplaćuje se ono što svaki zahtjev zapravo koristi. Korištenje se plaća iz unaprijed kupljenih kredita; 1 kredit jednaka je 0,01 US$.
Koliki je kontekstni prozor od DeepSeek-VL 7B?
Kontekstni prozor od DeepSeek-VL 7B sadrži 4.096 tokena. Jedan odgovor može biti dugačak do 2.048 tokena.
Koliko je brz DeepSeek-VL 7B?
Za DeepSeek-VL 7B na Railwailu još nema dovoljno izmjerenih pokretanja da bi se navedlo vrijeme izvršavanja. Ovisi o unošenju, postavkama i opterećenju kod pružatelja.
Je li DeepSeek-VL 7B bolji od BLIP?
To ovisi o zadatku. DeepSeek-VL 7B (DeepSeek) i BLIP (Salesforce) su oba modela iz kategorije Multimodalni. Stranica za usporedbu prikazuje njihove cijene i specifikacije usporedno.
Usporedi DeepSeek-VL 7B i BLIPMože li DeepSeek-VL 7B obraditi slike?
Da. DeepSeek-VL 7B prihvaća slike kao unos osim teksta.
Usporedivi modeli
Svi u ovoj kategoriji- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Svi modeli preko jednog API-ja
Jedan API ključ za sve modele na Railwailu. Korištenje se naplaćuje iz unaprijed plaćenih kredita, 1 kredit = 0,01 US$.