
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cijena
- ≈ 0,0012 US$/pokretanje
- Ulaz → izlaz
- Tekst + Slika → Tekst
- Razvojni inženjer
- Community
- Ažurirano
- 23. septembar 2026.
Playground
Isprobaj Florence-2 Large
Unos i rezultat
Ovaj pokus
oko 0,0012 US$ · 0,12 kredita
Na početku se rezervira 0,0036 US$ (0,36 kredita); naplata se vrši prema stvarnom GPU vremenu.
Novi si ovdje?
10 besplatnih kredita (0,10 US$) kada se registriraš s Googlom
Dostupno 24 sati nakon registracije, do 5 pokusa dnevno i najviše 2 kredita po pokusu. Ostale metode prijave počinju bez kredita. Dovoljno za 27 pokretanja ovog modela.
Examples
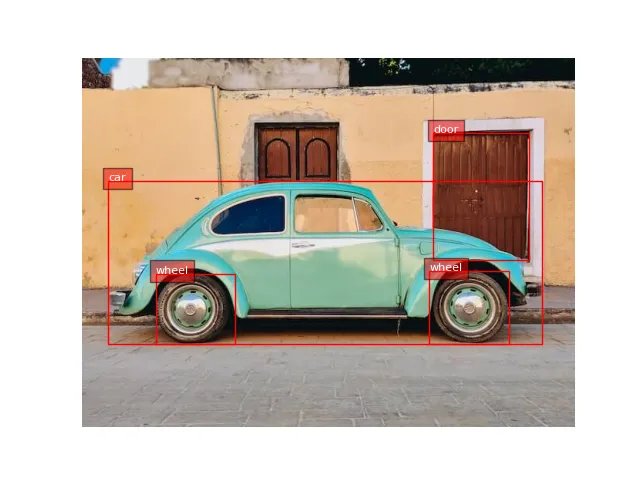 Open full size
 Input
No text prompt: the model only takes the input shown.
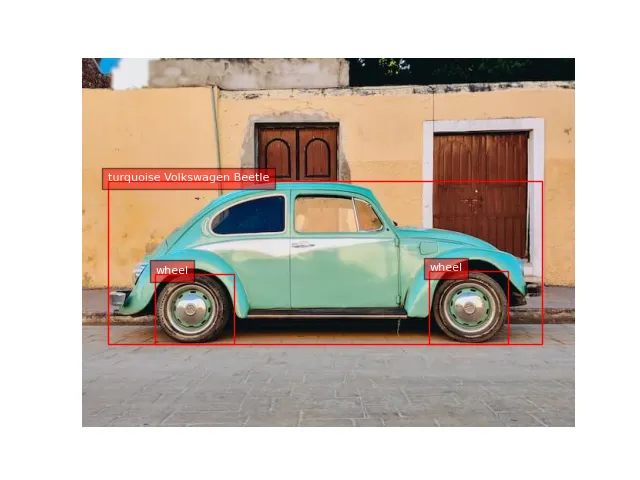 Open full size
 Input
No text prompt: the model only takes the input shown.
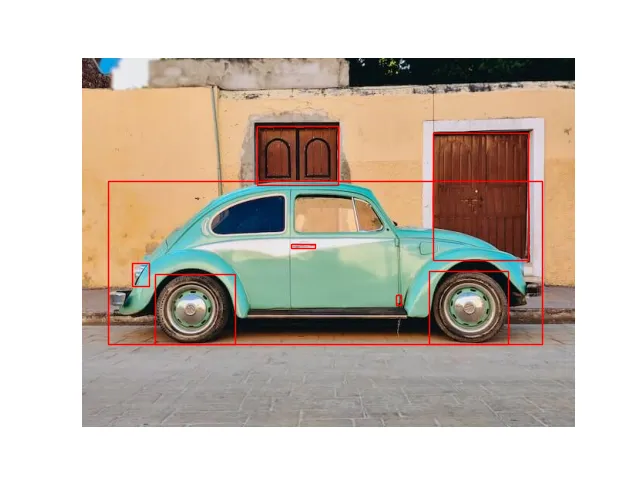 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Large
Florence-2 Large je model od Community iz kategorije Multimodalni. Na Railwailu, Florence-2 Large košta ≈ 0,0012 US$ po pokretanju.
Cijene
| Tipično pokretanje (≈ 1 s na L40S) | 0,0012 US$ po pokretanju |
|---|---|
| GPU vrijeme (L40S) | 0,00117 US$ po GPU sekundi |
- Naplaćuje se prema GPU vremenu koje pokretanje zapravo traje. Kada se pokretanje počne, 3× tipična cijena se rezervira iz vašeg stanja i naknadno se namiruje.
- 1 kredit = 0,01 US$
Kalkulator troškova
Kalkulator cijena
Tipično prema pružatelju: oko 1 s
Ukupno
0,12 US$
12 kredita
Po pokretanju
0,0012 US$ · 0,12 kredita
Naplaćuje se stvarno GPU vrijeme; ovo je procjena.
API
Nema provjeren primjer API-ja
Javni API prosleđuje drugačiji format unosa nego što ovaj model trebuje. Koristite playground gore.
Specifikacije
- ID modela
florence-2-large- Razvojni inženjer
- Community
- Kategorija
- Multimodalni
- Ulaz
- Tekst, Slika
- Izlaz
- Tekst
- Naplata
- Po potrošnji (tokeni ili GPU vrijeme)
- Katalog ažuriran
- 23. septembar 2026.
Parametri ulaza
Ulazi i postavke iz sheme ulaza modela. Primjer u odjeljku API pokazuje koje od njih API prihvaća.
promptobaveznoUser message or task instruction
Tip: TekstZadano: –Dozvoljene vrijednosti: do 4.000 znakovataskTip: IzborZadano:captionDozvoljene vrijednosti: caption, detailed_caption, ocr, object_detection ili segmentationimage_urlImage URL to analyze
Tip: TekstZadano: –Dozvoljene vrijednosti: –max_tokensTip: Cijeli brojZadano:1024Dozvoljene vrijednosti: 1 do 4.096temperatureTip: BrojZadano:0.7Dozvoljene vrijednosti: 0 do 2
Oznake
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Često postavljana pitanja
Što je Florence-2 Large?
Florence-2 Large je model od Community iz kategorije Multimodalni.
Koliko stoji Florence-2 Large na Railwailu?
Na Railwailu, Florence-2 Large košta ≈ 0,0012 US$ po pokretanju. Naplaćuje se ono što svaki zahtjev zapravo koristi. Korištenje se plaća iz unaprijed kupljenih kredita; 1 kredit jednaka je 0,01 US$.
Koje postavke podržava Florence-2 Large?
Prema svojoj shemi unosa, Florence-2 Large poznaje ove parametre: prompt (do 4.000 znakova), task (caption, detailed_caption, ocr, object_detection ili segmentation), image_url, max_tokens (1 do 4.096) i temperature (0 do 2).
Koliko je brz Florence-2 Large?
Za Florence-2 Large na Railwailu još nema dovoljno izmjerenih pokretanja da bi se navedlo vrijeme izvršavanja. Ovisi o unošenju, postavkama i opterećenju kod pružatelja.
Je li Florence-2 Large bolji od BLIP?
To ovisi o zadatku. Florence-2 Large (Community) i BLIP (Salesforce) su oba modela iz kategorije Multimodalni. Stranica za usporedbu prikazuje njihove cijene i specifikacije usporedno.
Usporedi Florence-2 Large i BLIPMože li Florence-2 Large obraditi slike?
Da. Florence-2 Large prihvaća slike kao unos osim teksta.
Usporedivi modeli
Svi u ovoj kategoriji- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Svi modeli preko jednog API-ja
Jedan API ključ za sve modele na Railwailu. Korištenje se naplaćuje iz unaprijed plaćenih kredita, 1 kredit = 0,01 US$.