
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Цена
- ≈ 0,0012 US$/извршување
- Влез → излез
- Текст + Слика → Текст
- Развивач
- Community
- Ажурирано
- 23 септември 2026 г.
Playground
Пробајте Florence-2 Large
Влез и резултат
Овој тек
приблизно 0,0012 US$ · 0,12 кредити
0,0036 US$ (0,36 кредити) се резервирани на почетокот; вистинското GPU време се наплачува.
Нов си овде?
10 бесплатни кредити (0,10 US$) кога ќе се регистрираш со Google
Употребливо 24 часа по регистрација, до 5 текови по ден и максимално 2 кредити по тек. Други методи на пријава почнуваат без кредити. Доволно за 27 извршувања на овој модел.
Examples
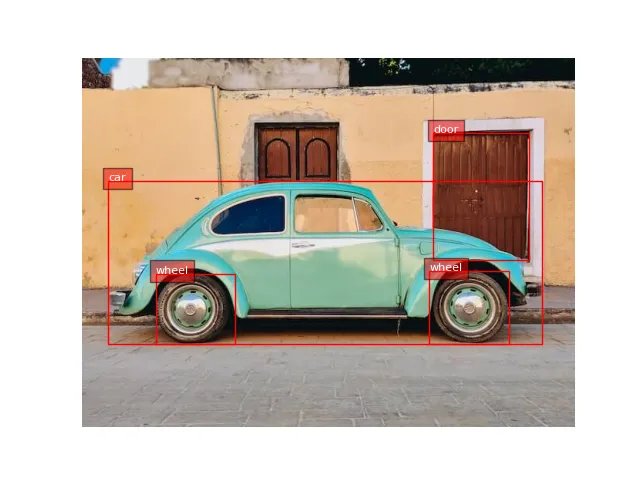 Open full size
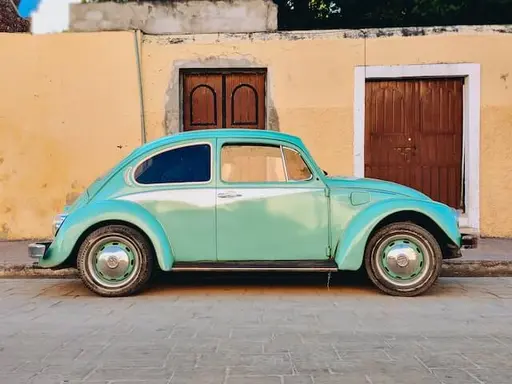 Input
No text prompt: the model only takes the input shown.
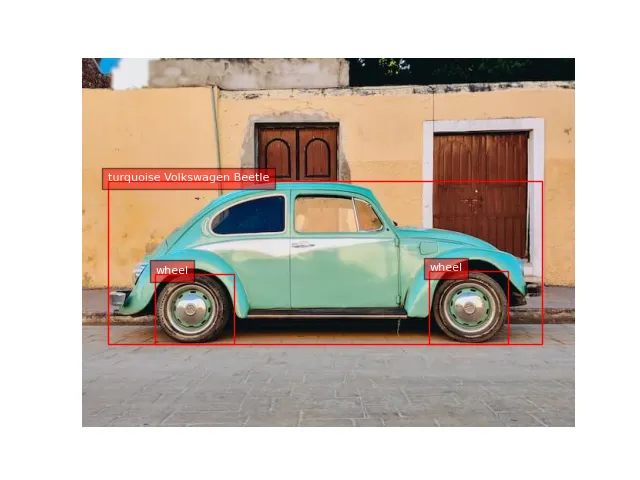 Open full size
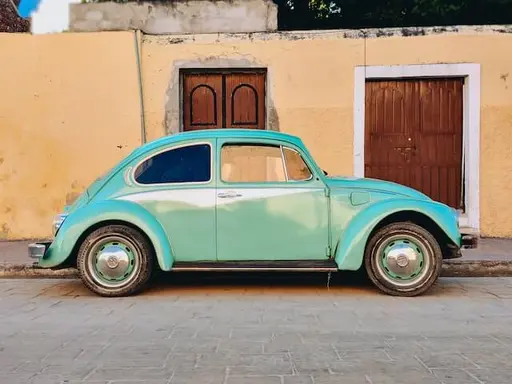 Input
No text prompt: the model only takes the input shown.
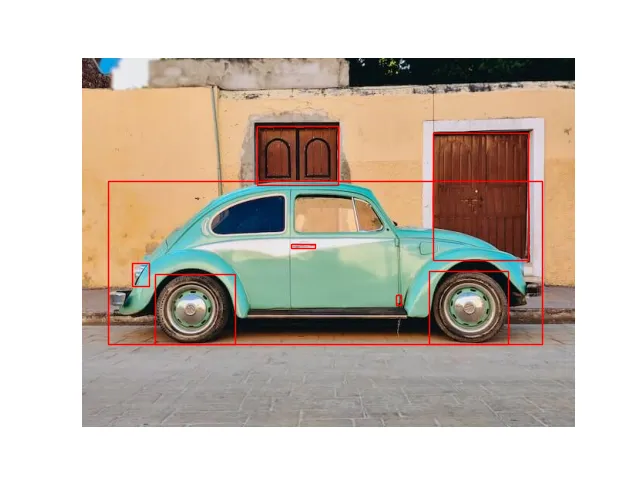 Open full size
 Input
No text prompt: the model only takes the input shown.
За Florence-2 Large
Florence-2 Large е модел од Community во категоријата Мултимодален. На Railwail, Florence-2 Large чини ≈ 0,0012 US$ по извршување.
Цени
| Типично извршување (≈ 1 s на L40S) | 0,0012 US$ по извршување |
|---|---|
| GPU време (L40S) | 0,00117 US$ по GPU секунда |
- Се наплаќува според GPU времето што извршувањето всушност го потребува. Кога извршувањето почнува, 3× типичната цена се резервира од вашиот салдо и се пресметува потоа.
- 1 кредит = 0,01 US$
Калкулатор за трошоци
Калкулатор за цена
Типично според добавувачот: околу 1 s
Вкупно
0,12 US$
12 кредити
По извршување
0,0012 US$ · 0,12 кредити
Наплачено е вистинското GPU време; ова е проценка.
API
Нема потврден API пример
Јавниот API пренесува различен формат на влез отколку што овој модел има потреба. Користете го игралиштето погоре.
Спецификации
- ID на моделот
florence-2-large- Развивач
- Community
- Категорија
- Мултимодален
- Влез
- Текст, Слика
- Излез
- Текст
- Наплата
- По употреба (токени или GPU време)
- Каталошка ставка ажурирана
- 23 септември 2026 г.
Параметри на влез
Влезови и поставки од шемата на влез на моделот. Примерот во делот API покажува кои од нив ги прифаќа API.
promptзадолжителноUser message or task instruction
Тип: ТекстСтандардно: –Дозволени вредности: до 4.000 знациtaskТип: ИзборСтандардно:captionДозволени вредности: caption, detailed_caption, ocr, object_detection или segmentationimage_urlImage URL to analyze
Тип: ТекстСтандардно: –Дозволени вредности: –max_tokensТип: ЦелинаСтандардно:1024Дозволени вредности: 1 до 4.096temperatureТип: БројСтандардно:0.7Дозволени вредности: 0 до 2
Ознаки
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Често поставувани прашања
Што е Florence-2 Large?
Florence-2 Large е модел од Community во категоријата Мултимодален.
Колку чини Florence-2 Large на Railwail?
На Railwail, Florence-2 Large чини ≈ 0,0012 US$ по извршување. Се наплаќува за она што секој барање всушност користи. Употребата се плаќа од подготвени кредити; 1 кредит е еднаков на 0,01 US$.
Кои поставки поддржува Florence-2 Large?
Според неговата шема за влез, Florence-2 Large ги познава овие параметри: prompt (до 4.000 знаци), task (caption, detailed_caption, ocr, object_detection или segmentation), image_url, max_tokens (1 до 4.096) и temperature (0 до 2).
Колку брз е Florence-2 Large?
Нема доволно измерени извршувања на Florence-2 Large на Railwail за да се наведе време на извршување. Зависи од влезот, поставките и оптеретувањето кај добавувачот.
Дали Florence-2 Large е подобар од BLIP?
Зависи од задачата. Florence-2 Large (Community) и BLIP (Salesforce) се обата модели во категоријата Мултимодален. Страницата за споредба ги покажува нивните цени и спецификации една до друга.
Спореди Florence-2 Large и BLIPМоже ли Florence-2 Large да обработува слики?
Да. Florence-2 Large прифаќа слики како влез покрај текстот.
Слични модели
Сите во оваа категорија- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Сите модели преку една API
Еден API клуч за секој модел на Railwail. Употребата се наплаќува од подготвени кредити, 1 кредит = 0,01 US$.