
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Цена
- ≈ 0,0012 US$/извршување
- Влез → излез
- Текст + Слика → Текст
- Развивач
- Community
- Ажурирано
- 23 септември 2026 г.
Playground
Пробајте Florence-2 Segmentation
Нема форма за влез
За овој модел сè уште нема форма за влез
Неговите влезови сè уште не се документирани. За да не пропадне извршување поради погрешен влез, не нудиме форма овде. Наместо тоа, изберете сличен модел.
Examples
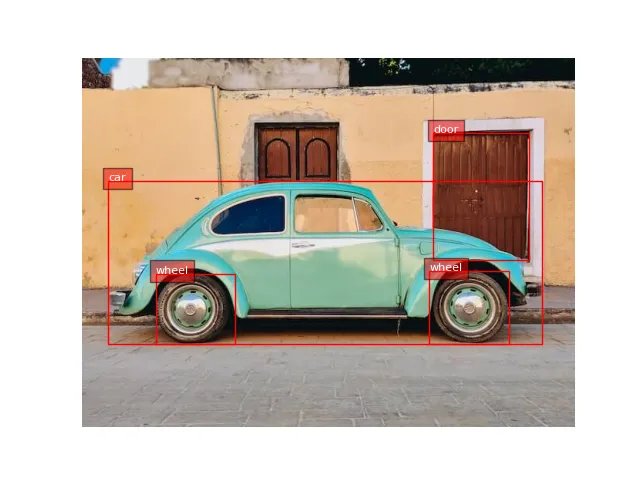 Open full size
 Input
No text prompt: the model only takes the input shown.
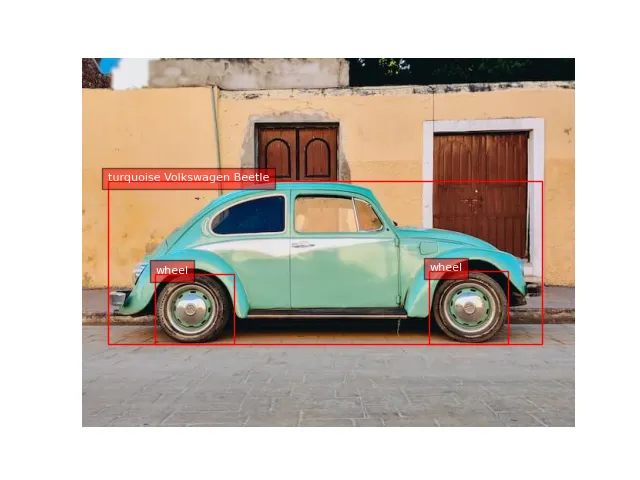 Open full size
 Input
No text prompt: the model only takes the input shown.
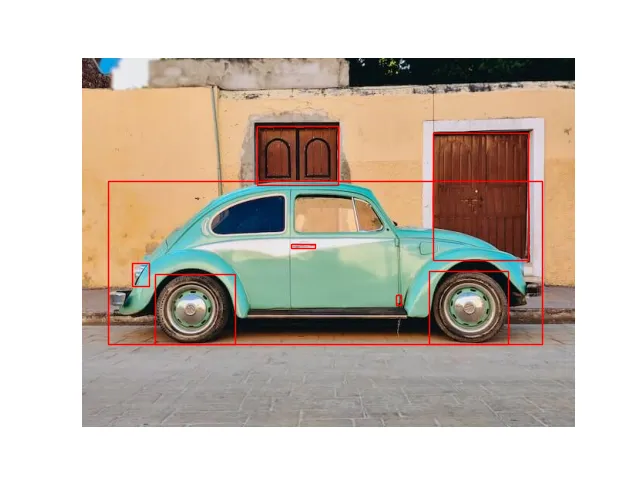 Open full size
 Input
No text prompt: the model only takes the input shown.
За Florence-2 Segmentation
Florence-2 Segmentation е модел од Community во категоријата Мултимодален. На Railwail, Florence-2 Segmentation чини ≈ 0,0012 US$ по извршување.
Цени
| Типично извршување (≈ 1 s на L40S) | 0,0012 US$ по извршување |
|---|---|
| GPU време (L40S) | 0,00117 US$ по GPU секунда |
- Се наплаќува според GPU времето што извршувањето всушност го потребува. Кога извршувањето почнува, 3× типичната цена се резервира од вашиот салдо и се пресметува потоа.
- 1 кредит = 0,01 US$
Калкулатор за трошоци
Калкулатор за цена
Типично според добавувачот: околу 1 s
Вкупно
0,12 US$
12 кредити
По извршување
0,0012 US$ · 0,12 кредити
Наплачено е вистинското GPU време; ова е проценка.
API
Нема потврден API пример
Јавниот API пренесува различен формат на влез отколку што овој модел има потреба. Користете го игралиштето погоре.
Спецификации
- ID на моделот
florence-2-segmentation- Развивач
- Community
- Категорија
- Мултимодален
- Влез
- Текст, Слика
- Излез
- Текст
- Наплата
- По употреба (токени или GPU време)
- Каталошка ставка ажурирана
- 23 септември 2026 г.
Ознаки
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Често поставувани прашања
Што е Florence-2 Segmentation?
Florence-2 Segmentation е модел од Community во категоријата Мултимодален.
Колку чини Florence-2 Segmentation на Railwail?
На Railwail, Florence-2 Segmentation чини ≈ 0,0012 US$ по извршување. Се наплаќува за она што секој барање всушност користи. Употребата се плаќа од подготвени кредити; 1 кредит е еднаков на 0,01 US$.
Колку брз е Florence-2 Segmentation?
Нема доволно измерени извршувања на Florence-2 Segmentation на Railwail за да се наведе време на извршување. Зависи од влезот, поставките и оптеретувањето кај добавувачот.
Дали Florence-2 Segmentation е подобар од BLIP?
Зависи од задачата. Florence-2 Segmentation (Community) и BLIP (Salesforce) се обата модели во категоријата Мултимодален. Страницата за споредба ги покажува нивните цени и спецификации една до друга.
Спореди Florence-2 Segmentation и BLIPМоже ли Florence-2 Segmentation да обработува слики?
Да. Florence-2 Segmentation прифаќа слики како влез покрај текстот.
Слични модели
Сите во оваа категорија- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ 0,0457 US$/извршување
3.708 % поскапо по единица
Споредете Florence-2 Segmentation и CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ 0,0050 US$/извршување
317 % поскапо по единица
Споредете Florence-2 Segmentation и Depth Anything v2
Сите модели преку една API
Еден API клуч за секој модел на Railwail. Употребата се наплаќува од подготвени кредити, 1 кредит = 0,01 US$.