
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Prijs
- ≈ US$ 0,0086/uitvoering
- Context
- 4.096 tokens
- Max. uitvoer
- 2.048 tokens
- Invoer → Uitvoer
- Tekst + Afbeelding → Tekst
- Ontwikkelaar
- DeepSeek
- Bijgewerkt
- 23 september 2026
Playground
DeepSeek-VL 7B proberen
Geen invoerformulier
Voor dit model is nog geen invoerformulier beschikbaar
De invoeren zijn nog niet gedocumenteerd. Om te voorkomen dat een uitvoering mislukt door onjuiste invoer, bieden we hier geen formulier aan. Kies in plaats daarvan een vergelijkbaar model.
Examples
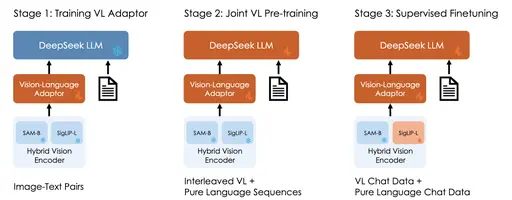 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
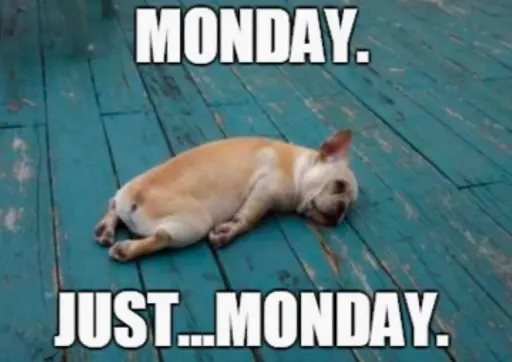 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Over DeepSeek-VL 7B
DeepSeek-VL 7B is een model van DeepSeek in de categorie Multimodaal. Op Railwail kost DeepSeek-VL 7B ≈ US$ 0,0086 per uitvoering. Het contextvenster bevat 4.096 tokens, en een antwoord kan tot 2.048 tokens lang zijn.
Prijzen
| Typische uitvoering (≈ 7 s op L40S) | US$ 0,0086 per uitvoering |
|---|---|
| GPU-tijd (L40S) | US$ 0,00117 per GPU-seconde |
- Afgerekend wordt de GPU-tijd die de run werkelijk gebruikt. Wanneer de run start, wordt het 3-voudige van de typische prijs van uw saldo gereserveerd en later verrekend.
- 1 credit = US$ 0,01
Kostencalculator
Prijscalculator
Typisch volgens de provider: ongeveer 7,3 s
Totaal
US$ 0,86
86 credits
Per run
US$ 0,0086 · 0,86 credits
Afgerekend wordt de werkelijke GPU-tijd; dit is een schatting.
API
Geen geverifieerd API-voorbeeld
De openbare API geeft een ander invoerformaat door dan dit model nodig heeft. Gebruik de playground hierboven.
Specificaties
- Model-ID
deepseek-vl-7b- Ontwikkelaar
- DeepSeek
- Categorie
- Multimodaal
- Invoer
- Tekst, Afbeelding
- Uitvoer
- Tekst
- Contextvenster
- 4.096 tokens
- Max. uitvoer
- 2.048 tokens
- Facturering
- Op basis van gebruik (tokens of GPU-tijd)
- Catalogusitem bijgewerkt
- 23 september 2026
Tags
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Veelgestelde vragen
Wat is DeepSeek-VL 7B?
DeepSeek-VL 7B is een model van DeepSeek in de categorie Multimodaal.
Hoeveel kost DeepSeek-VL 7B op Railwail?
Op Railwail kost DeepSeek-VL 7B ≈ US$ 0,0086 per uitvoering. U betaalt voor wat elke aanvraag daadwerkelijk verbruikt. Gebruik wordt betaald met vooraf gekochte credits; 1 credit is gelijk aan US$ 0,01.
Wat is het contextvenster van DeepSeek-VL 7B?
Het contextvenster van DeepSeek-VL 7B bevat 4.096 tokens. Een antwoord kan tot 2.048 tokens lang zijn.
Hoe snel is DeepSeek-VL 7B?
Er zijn nog niet genoeg gemeten runs van DeepSeek-VL 7B op Railwail om een uitvoeringstijd op te geven. Dit hangt af van de invoer, de instellingen en de belasting bij de provider.
Is DeepSeek-VL 7B beter dan BLIP?
Dat hangt van de taak af. DeepSeek-VL 7B (DeepSeek) en BLIP (Salesforce) zijn beide modellen in de categorie Multimodaal. De vergelijkingspagina toont hun prijzen en specificaties naast elkaar.
DeepSeek-VL 7B en BLIP vergelijkenKan DeepSeek-VL 7B afbeeldingen verwerken?
Ja. DeepSeek-VL 7B accepteert afbeeldingen als invoer naast tekst.
Vergelijkbare modellen
Alle in deze categorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modellen via één API
Één API-sleutel voor elk model op Railwail. Gebruik wordt afgerekend via vooraf gekochte credits, 1 credit = US$ 0,01.