
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Prijs
- ≈ US$ 0,0012/uitvoering
- Invoer → Uitvoer
- Tekst + Afbeelding → Tekst
- Ontwikkelaar
- Community
- Bijgewerkt
- 23 september 2026
Playground
Florence-2 Large proberen
Invoer & resultaat
Deze uitvoering
ongeveer US$ 0,0012 · 0,12 credits
US$ 0,0036 (0,36 credits) worden gereserveerd bij het starten; de werkelijke GPU-tijd wordt gefactureerd.
Nieuw hier?
10 gratis credits (US$ 0,10) wanneer je je aanmeldt met Google
Bruikbaar 24 uur na aanmelding, tot 5 uitvoeringen per dag en maximaal 2 credits per uitvoering. Andere aanmeldmethoden starten zonder credits. Voldoende voor 27 uitvoeringen van dit model.
Examples
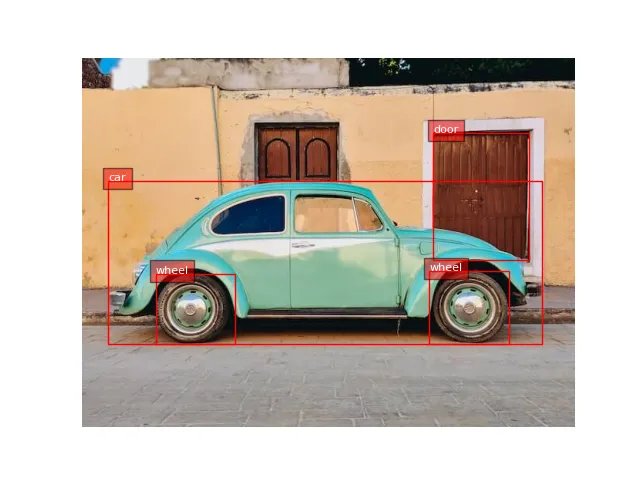 Open full size
 Input
No text prompt: the model only takes the input shown.
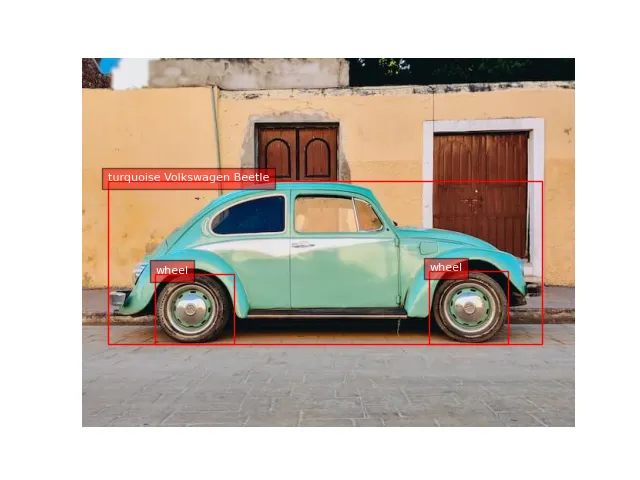 Open full size
 Input
No text prompt: the model only takes the input shown.
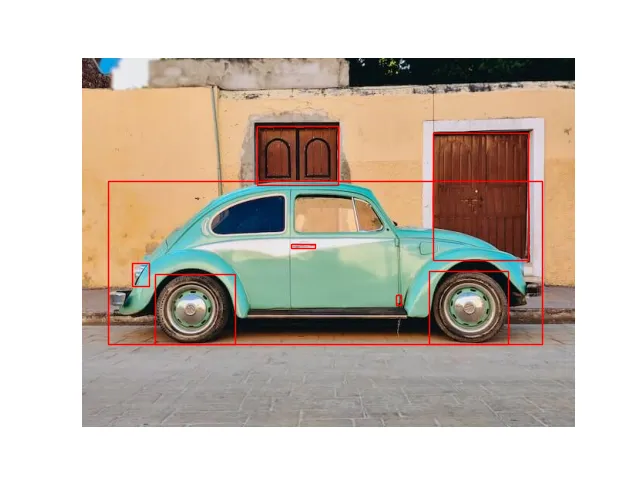 Open full size
 Input
No text prompt: the model only takes the input shown.
Over Florence-2 Large
Florence-2 Large is een model van Community in de categorie Multimodaal. Op Railwail kost Florence-2 Large ≈ US$ 0,0012 per uitvoering.
Prijzen
| Typische uitvoering (≈ 1 s op L40S) | US$ 0,0012 per uitvoering |
|---|---|
| GPU-tijd (L40S) | US$ 0,00117 per GPU-seconde |
- Afgerekend wordt de GPU-tijd die de run werkelijk gebruikt. Wanneer de run start, wordt het 3-voudige van de typische prijs van uw saldo gereserveerd en later verrekend.
- 1 credit = US$ 0,01
Kostencalculator
Prijscalculator
Typisch volgens de provider: ongeveer 1 s
Totaal
US$ 0,12
12 credits
Per run
US$ 0,0012 · 0,12 credits
Afgerekend wordt de werkelijke GPU-tijd; dit is een schatting.
API
Geen geverifieerd API-voorbeeld
De openbare API geeft een ander invoerformaat door dan dit model nodig heeft. Gebruik de playground hierboven.
Specificaties
- Model-ID
florence-2-large- Ontwikkelaar
- Community
- Categorie
- Multimodaal
- Invoer
- Tekst, Afbeelding
- Uitvoer
- Tekst
- Facturering
- Op basis van gebruik (tokens of GPU-tijd)
- Catalogusitem bijgewerkt
- 23 september 2026
Invoerparameters
Invoeren en instellingen uit het invoerschema van het model. Het voorbeeld in de API-sectie toont welke daarvan de API accepteert.
promptVerplichtUser message or task instruction
Type: TekstStandaard: –Toegestane waarden: tot 4.000 tekenstaskType: KeuzeStandaard:captionToegestane waarden: caption, detailed_caption, ocr, object_detection of segmentationimage_urlImage URL to analyze
Type: TekstStandaard: –Toegestane waarden: –max_tokensType: Geheel getalStandaard:1024Toegestane waarden: 1 tot 4.096temperatureType: GetalStandaard:0.7Toegestane waarden: 0 tot 2
Tags
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Veelgestelde vragen
Wat is Florence-2 Large?
Florence-2 Large is een model van Community in de categorie Multimodaal.
Hoeveel kost Florence-2 Large op Railwail?
Op Railwail kost Florence-2 Large ≈ US$ 0,0012 per uitvoering. U betaalt voor wat elke aanvraag daadwerkelijk verbruikt. Gebruik wordt betaald met vooraf gekochte credits; 1 credit is gelijk aan US$ 0,01.
Welke instellingen ondersteunt Florence-2 Large?
Volgens het invoerschema kent Florence-2 Large deze parameters: prompt (tot 4.000 tekens), task (caption, detailed_caption, ocr, object_detection of segmentation), image_url, max_tokens (1 tot 4.096) en temperature (0 tot 2).
Hoe snel is Florence-2 Large?
Er zijn nog niet genoeg gemeten runs van Florence-2 Large op Railwail om een uitvoeringstijd op te geven. Dit hangt af van de invoer, de instellingen en de belasting bij de provider.
Is Florence-2 Large beter dan BLIP?
Dat hangt van de taak af. Florence-2 Large (Community) en BLIP (Salesforce) zijn beide modellen in de categorie Multimodaal. De vergelijkingspagina toont hun prijzen en specificaties naast elkaar.
Florence-2 Large en BLIP vergelijkenKan Florence-2 Large afbeeldingen verwerken?
Ja. Florence-2 Large accepteert afbeeldingen als invoer naast tekst.
Vergelijkbare modellen
Alle in deze categorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modellen via één API
Één API-sleutel voor elk model op Railwail. Gebruik wordt afgerekend via vooraf gekochte credits, 1 credit = US$ 0,01.