
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Pris
- ≈ 0,0086 USD/kjøring
- Kontekst
- 4 096 tokens
- Maks. utdata
- 2 048 tokens
- Input → output
- Tekst + Bilde → Tekst
- Utvikler
- DeepSeek
- Oppdatert
- 23. september 2026
Playground
Prøv DeepSeek-VL 7B
Ingen innmaskering
Ingen innmaskering for denne modellen ennå
Inndataene er ikke dokumentert ennå. For at ingen kjøring skal mislykkes på grunn av feil inndata, tilbyr vi ikke et skjema her. Velg en sammenlignbar modell i stedet.
Examples
 Input
Prompt
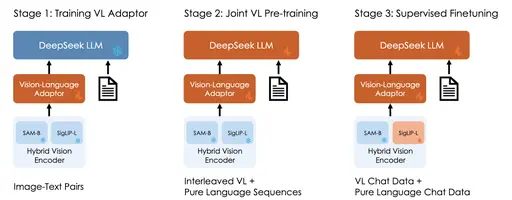
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
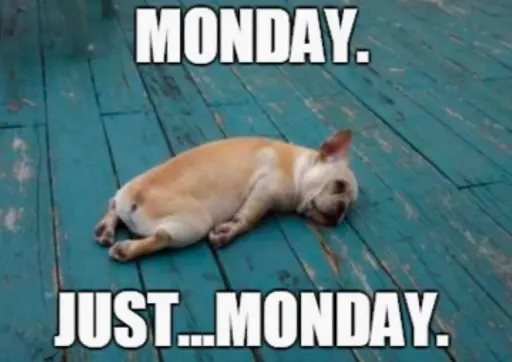
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Om DeepSeek-VL 7B
DeepSeek-VL 7B er en modell fra DeepSeek i kategorien Multimodal. På Railwail koster DeepSeek-VL 7B ≈ 0,0086 USD per kjøring. Kontekstvinduet inneholder 4 096 tokens, og ett svar kan være opptil 2 048 tokens langt.
Priser
| Typisk kjøring (≈ 7 s på L40S) | 0,0086 USD per kjøring |
|---|---|
| GPU-tid (L40S) | 0,00117 USD per GPU-sekund |
- Faktureres etter GPU-tiden kjøringen faktisk tar. Når kjøringen starter, blir 3× den typiske prisen reservert fra saldoen din og gjort opp etterpå.
- 1 kreditt = 0,01 USD
Kostnadsberegner
Prisberegner
Typisk ifølge leverandøren: ca. 7,3 s
Totalt
0,86 USD
86 credits
Per kjøring
0,0086 USD · 0,86 credits
Fakturert etter faktisk GPU-tid; dette er et estimat.
API
Ingen verifisert API-eksempel
Det offentlige API-et sender et annet inngangsformat enn det denne modellen trenger. Bruk lekeplassen ovenfor.
Spesifikasjoner
- Modell-ID
deepseek-vl-7b- Utvikler
- DeepSeek
- Kategori
- Multimodal
- Inndata
- Tekst, Bilde
- Utdata
- Tekst
- Kontekstvindu
- 4 096 tokens
- Maks. utdata
- 2 048 tokens
- Fakturering
- Etter bruk (tokens eller GPU-tid)
- Katalogoppføring oppdatert
- 23. september 2026
Merkelapper
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Ofte stilte spørsmål
Hva er DeepSeek-VL 7B?
DeepSeek-VL 7B er en modell fra DeepSeek i kategorien Multimodal.
Hvor mye koster DeepSeek-VL 7B på Railwail?
På Railwail koster DeepSeek-VL 7B ≈ 0,0086 USD per kjøring. Du betaler for det hver forespørsel faktisk bruker. Bruk betales fra forhåndskjøpte kreditter; 1 kreditt tilsvarer 0,01 USD.
Hvor stort er kontekstvinduet til DeepSeek-VL 7B?
Kontekstvinduet til DeepSeek-VL 7B inneholder 4 096 tokens. Ett svar kan være opptil 2 048 tokens langt.
Hvor rask er DeepSeek-VL 7B?
Det finnes ennå ikke nok målte kjøringer av DeepSeek-VL 7B på Railwail til å angi en kjøretid. Det avhenger av inndataene, innstillingene og belastningen hos leverandøren.
Er DeepSeek-VL 7B bedre enn BLIP?
Det avhenger av oppgaven. DeepSeek-VL 7B (DeepSeek) og BLIP (Salesforce) er begge modeller i kategorien Multimodal. Sammenligningssiden viser prisene og spesifikasjonene deres side ved side.
Sammenlign DeepSeek-VL 7B og BLIPKan DeepSeek-VL 7B behandle bilder?
Ja. DeepSeek-VL 7B godtar bilder som inndata i tillegg til tekst.
Sammenlignbare modeller
Alle i denne kategorien- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modeller gjennom én API
Én API-nøkkel for alle modeller på Railwail. Bruk belastes fra forhåndsbetalt kreditt, 1 kreditt = 0,01 USD.