
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Pris
- ≈ 0,0012 USD/kjøring
- Input → output
- Tekst + Bilde → Tekst
- Utvikler
- Community
- Oppdatert
- 23. september 2026
Playground
Prøv Florence-2 Large
Inndata og resultat
Denne kjøringen
ca. 0,0012 USD · 0,12 credits
0,0036 USD (0,36 credits) reserveres ved start; faktisk GPU-tid faktureres.
Ny her?
10 gratis credits (0,10 USD) når du registrerer deg med Google
Kan brukes 24 timer etter registrering, opptil 5 kjøringer per dag og maksimalt 2 credits per kjøring. Andre påloggingsmetoder starter uten credits. Nok for 27 kjøringer av denne modellen.
Examples
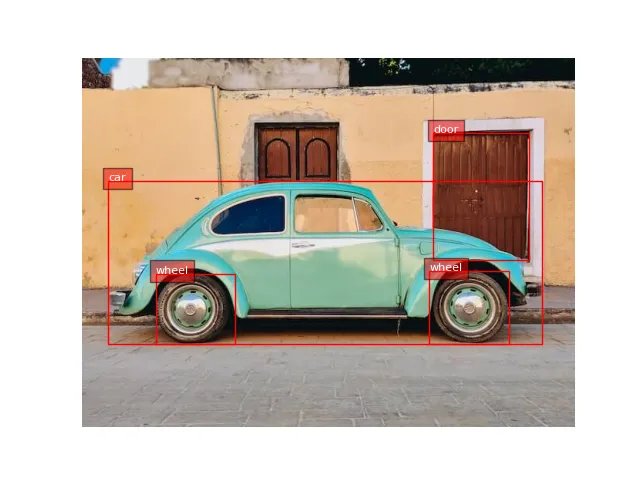 Open full size
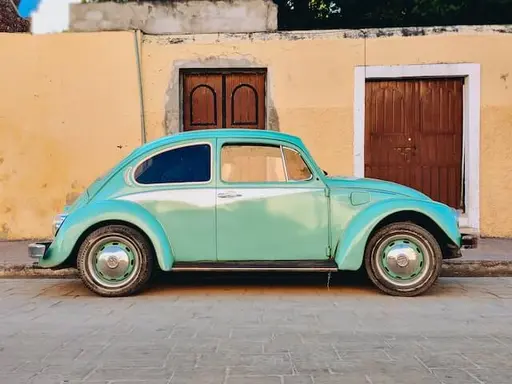 Input
No text prompt: the model only takes the input shown.
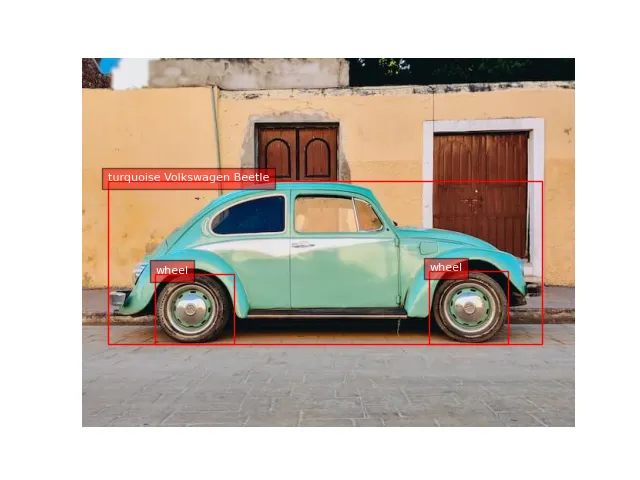 Open full size
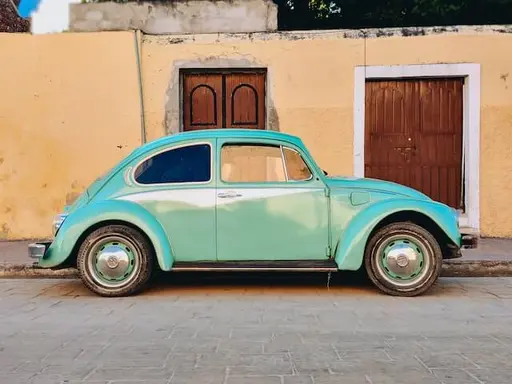 Input
No text prompt: the model only takes the input shown.
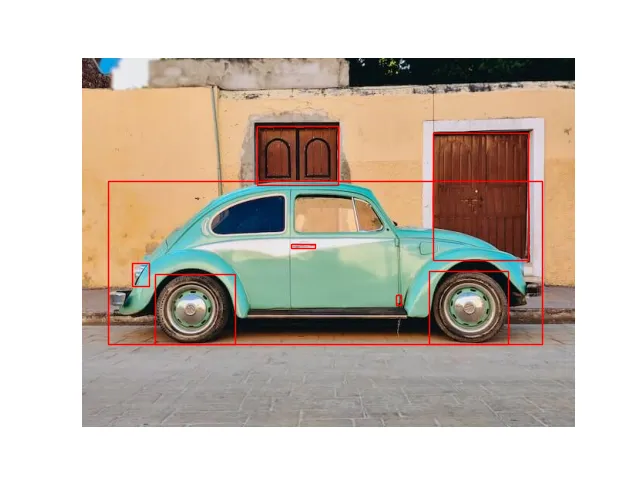 Open full size
 Input
No text prompt: the model only takes the input shown.
Om Florence-2 Large
Florence-2 Large er en modell fra Community i kategorien Multimodal. På Railwail koster Florence-2 Large ≈ 0,0012 USD per kjøring.
Priser
| Typisk kjøring (≈ 1 s på L40S) | 0,0012 USD per kjøring |
|---|---|
| GPU-tid (L40S) | 0,00117 USD per GPU-sekund |
- Faktureres etter GPU-tiden kjøringen faktisk tar. Når kjøringen starter, blir 3× den typiske prisen reservert fra saldoen din og gjort opp etterpå.
- 1 kreditt = 0,01 USD
Kostnadsberegner
Prisberegner
Typisk ifølge leverandøren: ca. 1 s
Totalt
0,12 USD
12 credits
Per kjøring
0,0012 USD · 0,12 credits
Fakturert etter faktisk GPU-tid; dette er et estimat.
API
Ingen verifisert API-eksempel
Det offentlige API-et sender et annet inngangsformat enn det denne modellen trenger. Bruk lekeplassen ovenfor.
Spesifikasjoner
- Modell-ID
florence-2-large- Utvikler
- Community
- Kategori
- Multimodal
- Inndata
- Tekst, Bilde
- Utdata
- Tekst
- Fakturering
- Etter bruk (tokens eller GPU-tid)
- Katalogoppføring oppdatert
- 23. september 2026
Inndataparametere
Inndataer og innstillinger fra modellens inndataskjema. Eksemplet i API-delen viser hvilke av dem APIen godtar.
promptobligatoriskUser message or task instruction
Type: TekstStandard: –Tillatte verdier: opptil 4 000 tegntaskType: ValgStandard:captionTillatte verdier: caption, detailed_caption, ocr, object_detection eller segmentationimage_urlImage URL to analyze
Type: TekstStandard: –Tillatte verdier: –max_tokensType: HeltallStandard:1024Tillatte verdier: 1 til 4 096temperatureType: TallStandard:0.7Tillatte verdier: 0 til 2
Merkelapper
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Ofte stilte spørsmål
Hva er Florence-2 Large?
Florence-2 Large er en modell fra Community i kategorien Multimodal.
Hvor mye koster Florence-2 Large på Railwail?
På Railwail koster Florence-2 Large ≈ 0,0012 USD per kjøring. Du betaler for det hver forespørsel faktisk bruker. Bruk betales fra forhåndskjøpte kreditter; 1 kreditt tilsvarer 0,01 USD.
Hvilke innstillinger støtter Florence-2 Large?
I henhold til inndataskjemaet kjenner Florence-2 Large disse parametrene: prompt (opptil 4 000 tegn), task (caption, detailed_caption, ocr, object_detection eller segmentation), image_url, max_tokens (1 til 4 096) og temperature (0 til 2).
Hvor rask er Florence-2 Large?
Det finnes ennå ikke nok målte kjøringer av Florence-2 Large på Railwail til å angi en kjøretid. Det avhenger av inndataene, innstillingene og belastningen hos leverandøren.
Er Florence-2 Large bedre enn BLIP?
Det avhenger av oppgaven. Florence-2 Large (Community) og BLIP (Salesforce) er begge modeller i kategorien Multimodal. Sammenligningssiden viser prisene og spesifikasjonene deres side ved side.
Sammenlign Florence-2 Large og BLIPKan Florence-2 Large behandle bilder?
Ja. Florence-2 Large godtar bilder som inndata i tillegg til tekst.
Sammenlignbare modeller
Alle i denne kategorien- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alle modeller gjennom én API
Én API-nøkkel for alle modeller på Railwail. Bruk belastes fra forhåndsbetalt kreditt, 1 kreditt = 0,01 USD.