
BLIP
blip-captioningSalesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- Cena
- ≈ 0,00030 USD/uruchomienie
- Wejście → Wyjście
- Tekst + Obraz → Tekst
- Deweloper
- Salesforce
- Zaktualizowano
- 23 września 2026
Playground
Spróbuj BLIP
Wejście i wyjście
To uruchomienie
ok. 0,0003 USD · 0,03 kredytów
Na początek rezerwowane jest 0,0009 USD (0,09 kredytów); rozliczana jest rzeczywista czas GPU.
Nowy tutaj?
10 darmowych kredytów (0,10 USD) po zarejestrowaniu się przez Google
Dostępne 24 godzin po rejestracji, do 5 uruchomień dziennie i maksymalnie 2 kredytów na uruchomienie. Inne metody logowania uruchamiają się bez kredytów. Wystarczy na 111 uruchomień tego modelu.
Examples
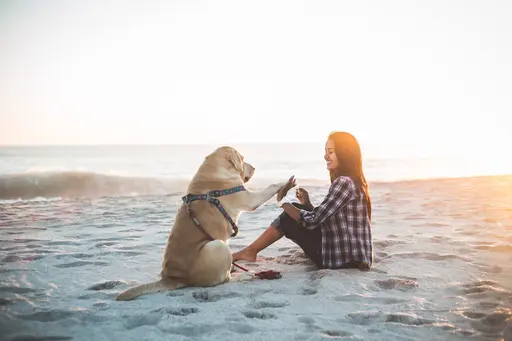 Input
Prompt
image_captioning
Output (JSON, shortened)
[ { "text": "Caption: a woman sitting on the beach with a dog" } ]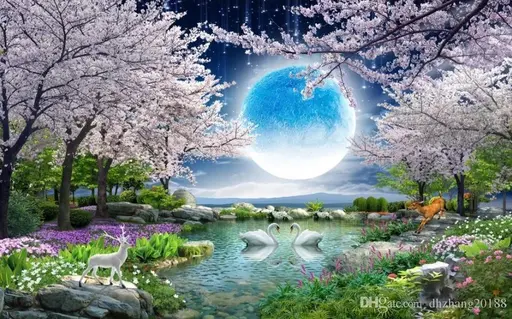 Input
Prompt
what is in the sky?
Output (JSON, shortened)
[ { "text": "Answer: moon" } ] Input
Prompt
what is in the lake?
Output (JSON, shortened)
[
  {
    "text": "Answer: swans"
  }
]
O BLIP
BLIP to model opracowany przez Salesforce w kategorii Multimodalne. W serwisie Railwail BLIP kosztuje ≈ 0,00030 USD za uruchomienie.
Ceny
| Typowe uruchomienie (≈ 1 s na T4) | 0,00030 USD za uruchomienie |
|---|---|
| Czas GPU (T4) | 0,00027 USD za sekundę GPU |
- Rozliczane są czasy GPU, które przebieg faktycznie zajmuje. Po uruchomieniu przebiegu 3× typowej ceny jest rezerwowane z Twojego salda i rozliczane później.
- 1 kredyt = 0,01 USD
Kalkulator kosztów
Kalkulator cen
Typowo według dostawcy: ok. 1 s
Razem
0,03 USD
3 kredytów
Za uruchomienie
0,0003 USD · 0,03 kredytów
Rozliczane są rzeczywiste sekundy GPU; wartość jest szacunkiem.
API
Brak zweryfikowanego przykładu API
Publiczny API przekazuje inny format wejściowy niż wymaga ten model. Użyj placu zabaw powyżej.
Specyfikacje
- ID modelu
blip-captioning- Deweloper
- Salesforce
- Kategoria
- Multimodalne
- Wejście
- Tekst, Obraz
- Wyjście
- Tekst
- Rozliczenie
- Według użycia (tokeny lub czas GPU)
- Wpis w katalogu zaktualizowany
- 23 września 2026
Parametry wejściowe
Dane wejściowe i ustawienia ze schematu wejściowego modelu. Przykład w sekcji API pokazuje, które z nich API akceptuje.
imagewymaganeImage to caption or ask about
Typ: TekstDomyślnie: –Dozwolone wartości: –taskTyp: WybórDomyślnie:image_captioningDozwolone wartości: image_captioning lub visual_question_answeringquestionQuestion for visual question answering mode
Typ: TekstDomyślnie: –Dozwolone wartości: –
Tagi
- replicate
- blip
- captioning
- vqa
- salesforce
- vision-understanding
- image
Często zadawane pytania
Co to jest BLIP?
BLIP to model opracowany przez Salesforce w kategorii Multimodalne.
Ile kosztuje BLIP w serwisie Railwail?
W serwisie Railwail BLIP kosztuje ≈ 0,00030 USD za uruchomienie. Opłata jest pobierana za to, co faktycznie zużywa każde żądanie. Użycie jest opłacane z przedpłaconych kredytów; 1 kredyt równa się 0,01 USD.
Jakie ustawienia obsługuje BLIP?
Zgodnie ze schematem wejściowym, BLIP obsługuje te parametry: image, task (image_captioning lub visual_question_answering) i question.
Jak szybki jest BLIP?
Dla BLIP jest jeszcze zbyt mało zmierzonych przebiegów w serwisie Railwail, aby podać czas przebiegu. Zależy to od wejścia, ustawień i obciążenia u dostawcy.
Czy BLIP jest lepszy niż CLIP Interrogator?
To zależy od zadania. BLIP (Salesforce) i CLIP Interrogator (Community) to oba modele z kategorii Multimodalne. Strona porównania pokazuje ich ceny i specyfikacje obok siebie.
Porównaj BLIP i CLIP InterrogatorCzy BLIP może przetwarzać obrazy?
Tak. BLIP akceptuje obrazy jako wejście oprócz tekstu.
Porównywalne modele
Wszystkie w tej kategorii- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Meta Segment Anything 2. Promptable segmentation across images and video with temporal memory. Zero-shot, point/box/mask prompts, fast on a single H100.
Wszystkie modele przez jedno API
Jeden klucz API dla każdego modelu na Railwail. Opłaty pobierane są z przedpłaconych kredytów, 1 kredyt = 0,01 USD.