
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Preço
- ≈ US$ 0,0012/execução
- Entrada → Saída
- Texto + Imagem → Texto
- Desenvolvedor
- Community
- Atualizado
- 23 de setembro de 2026
Playground
Experimentar Florence-2 Large
Entrada & saída
Esta execução
cerca de US$ 0,0012 · 0,12 créditos
US$ 0,0036 (0,36 créditos) são reservados no início; o tempo real de GPU é cobrado.
Novo por aqui?
10 créditos grátis (US$ 0,10) ao se inscrever com Google
Utilizável 24 horas após inscrição, até 5 execuções por dia e no máximo 2 créditos por execução. Outros métodos de login começam sem créditos. Suficiente para 27 execuções deste modelo.
Examples
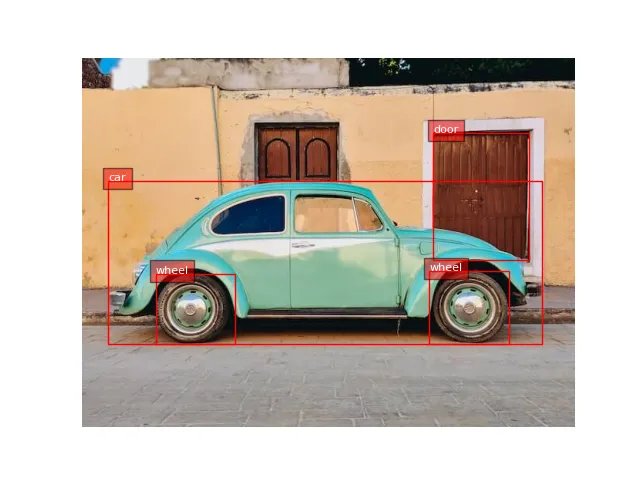 Open full size
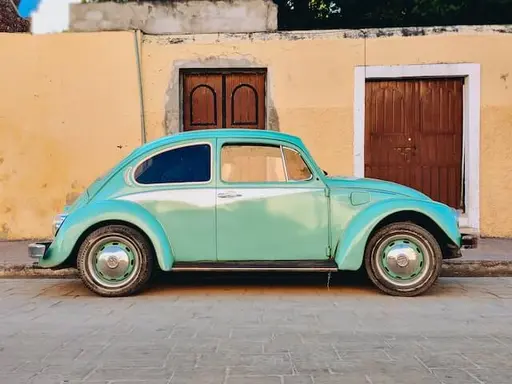 Input
No text prompt: the model only takes the input shown.
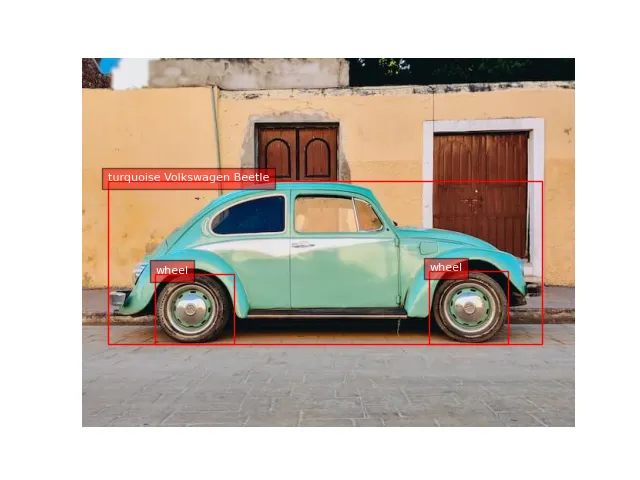 Open full size
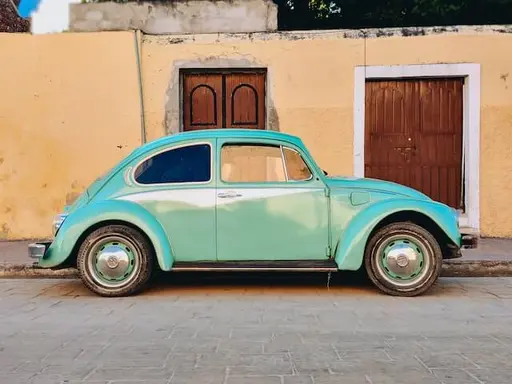 Input
No text prompt: the model only takes the input shown.
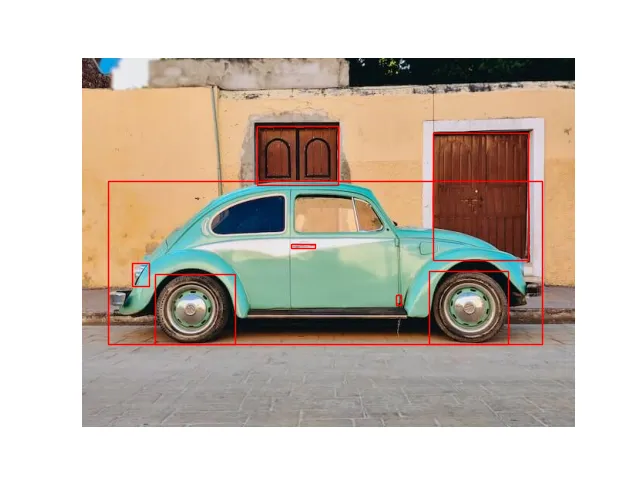 Open full size
 Input
No text prompt: the model only takes the input shown.
Sobre Florence-2 Large
Florence-2 Large é um modelo de Community na categoria Multimodal. No Railwail, Florence-2 Large custa ≈ US$ 0,0012 por execução.
Preços
| Execução típica (≈ 1 s em L40S) | US$ 0,0012 por execução |
|---|---|
| Tempo de GPU (L40S) | US$ 0,00117 por segundo de GPU |
- Faturado pelo tempo de GPU que a execução realmente leva. Quando a execução começa, 3× o preço típico é reservado do seu saldo e liquidado depois.
- 1 crédito = US$ 0,01
Calculadora de custos
Calculadora de preços
Típico conforme o provedor: cerca de 1 s
Total
US$ 0,12
12 créditos
Por execução
US$ 0,0012 · 0,12 créditos
Faturado pelo tempo real de GPU; este é uma estimativa.
API
Nenhum exemplo de API verificado
A API pública passa um formato de entrada diferente do que este modelo precisa. Use o playground acima.
Especificações
- ID do modelo
florence-2-large- Desenvolvedor
- Community
- Categoria
- Multimodal
- Entrada
- Texto, Imagem
- Saída
- Texto
- Faturamento
- Por uso (tokens ou tempo de GPU)
- Entrada do catálogo atualizada
- 23 de setembro de 2026
Parâmetros de entrada
Entradas e configurações do esquema de entrada do modelo. O exemplo na seção API mostra quais delas a API aceita.
promptobrigatórioUser message or task instruction
Tipo: TextoPadrão: –Valores permitidos: até 4.000 caracterestaskTipo: EscolhaPadrão:captionValores permitidos: caption, detailed_caption, ocr, object_detection ou segmentationimage_urlImage URL to analyze
Tipo: TextoPadrão: –Valores permitidos: –max_tokensTipo: Número inteiroPadrão:1024Valores permitidos: 1 a 4.096temperatureTipo: NúmeroPadrão:0.7Valores permitidos: 0 a 2
Etiquetas
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Perguntas frequentes
O que é Florence-2 Large?
Florence-2 Large é um modelo de Community na categoria Multimodal.
Quanto custa Florence-2 Large no Railwail?
No Railwail, Florence-2 Large custa ≈ US$ 0,0012 por execução. Você é cobrado pelo que cada solicitação realmente usa. O uso é pago com créditos pré-pagos; 1 crédito equivale a US$ 0,01.
Quais configurações Florence-2 Large suporta?
De acordo com seu esquema de entrada, Florence-2 Large conhece estes parâmetros: prompt (até 4.000 caracteres), task (caption, detailed_caption, ocr, object_detection ou segmentation), image_url, max_tokens (1 a 4.096) e temperature (0 a 2).
Qual é a velocidade de Florence-2 Large?
Ainda não há execuções medidas suficientes de Florence-2 Large no Railwail para indicar um tempo de execução. Depende da entrada, das configurações e da carga no provedor.
Florence-2 Large é melhor que BLIP?
Depende da tarefa. Florence-2 Large (Community) e BLIP (Salesforce) são ambos modelos na categoria Multimodal. A página de comparação mostra seus preços e especificações lado a lado.
Comparar Florence-2 Large e BLIPFlorence-2 Large pode processar imagens?
Sim. Florence-2 Large aceita imagens como entrada além de texto.
Modelos comparáveis
Todos nesta categoria- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Todos os modelos através de uma API
Uma chave API para todos os modelos no Railwail. O uso é cobrado a partir de créditos pré-pagos, 1 crédito = US$ 0,01.