
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Preço
- ≈ US$ 0,0012/execução
- Entrada → Saída
- Texto + Imagem → Texto
- Desenvolvedor
- Community
- Atualizado
- 23 de setembro de 2026
Playground
Experimentar Florence-2 Segmentation
Sem formulário de entrada
Ainda não há formulário de entrada para este modelo
Suas entradas ainda não foram documentadas. Para que nenhuma execução falhe com uma entrada incorreta, não oferecemos um formulário aqui. Escolha um modelo comparável em vez disso.
Examples
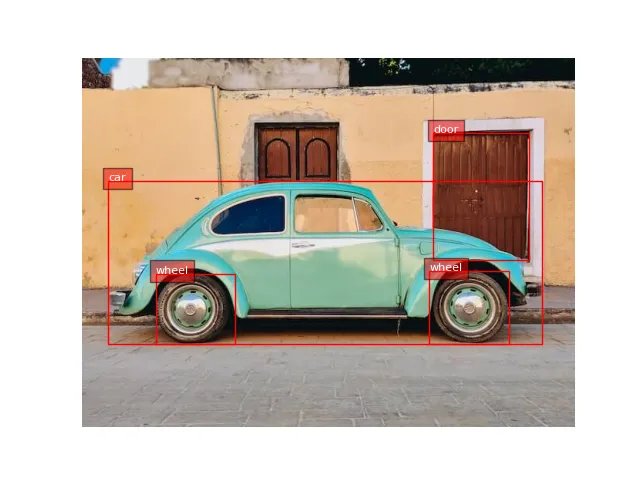 Open full size
 Input
No text prompt: the model only takes the input shown.
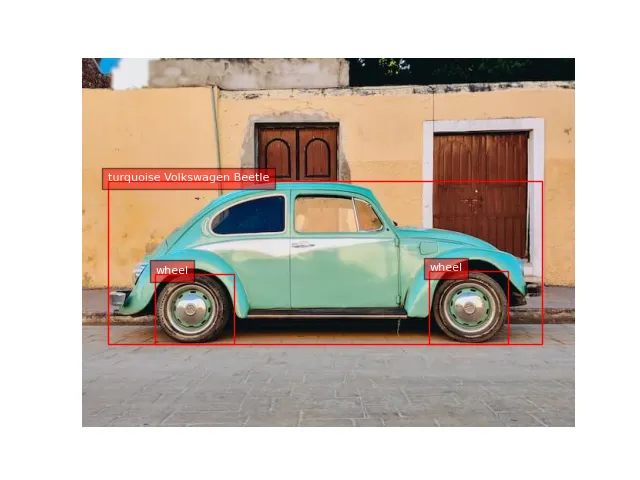 Open full size
 Input
No text prompt: the model only takes the input shown.
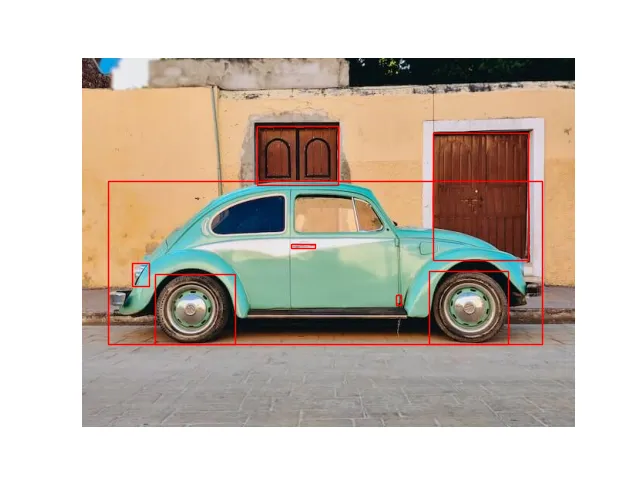 Open full size
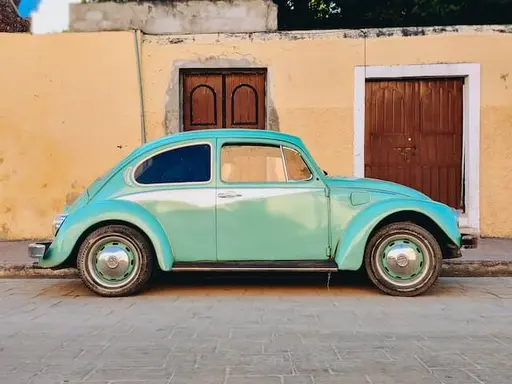 Input
No text prompt: the model only takes the input shown.
Sobre Florence-2 Segmentation
Florence-2 Segmentation é um modelo de Community na categoria Multimodal. No Railwail, Florence-2 Segmentation custa ≈ US$ 0,0012 por execução.
Preços
| Execução típica (≈ 1 s em L40S) | US$ 0,0012 por execução |
|---|---|
| Tempo de GPU (L40S) | US$ 0,00117 por segundo de GPU |
- Faturado pelo tempo de GPU que a execução realmente leva. Quando a execução começa, 3× o preço típico é reservado do seu saldo e liquidado depois.
- 1 crédito = US$ 0,01
Calculadora de custos
Calculadora de preços
Típico conforme o provedor: cerca de 1 s
Total
US$ 0,12
12 créditos
Por execução
US$ 0,0012 · 0,12 créditos
Faturado pelo tempo real de GPU; este é uma estimativa.
API
Nenhum exemplo de API verificado
A API pública passa um formato de entrada diferente do que este modelo precisa. Use o playground acima.
Especificações
- ID do modelo
florence-2-segmentation- Desenvolvedor
- Community
- Categoria
- Multimodal
- Entrada
- Texto, Imagem
- Saída
- Texto
- Faturamento
- Por uso (tokens ou tempo de GPU)
- Entrada do catálogo atualizada
- 23 de setembro de 2026
Etiquetas
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Perguntas frequentes
O que é Florence-2 Segmentation?
Florence-2 Segmentation é um modelo de Community na categoria Multimodal.
Quanto custa Florence-2 Segmentation no Railwail?
No Railwail, Florence-2 Segmentation custa ≈ US$ 0,0012 por execução. Você é cobrado pelo que cada solicitação realmente usa. O uso é pago com créditos pré-pagos; 1 crédito equivale a US$ 0,01.
Qual é a velocidade de Florence-2 Segmentation?
Ainda não há execuções medidas suficientes de Florence-2 Segmentation no Railwail para indicar um tempo de execução. Depende da entrada, das configurações e da carga no provedor.
Florence-2 Segmentation é melhor que BLIP?
Depende da tarefa. Florence-2 Segmentation (Community) e BLIP (Salesforce) são ambos modelos na categoria Multimodal. A página de comparação mostra seus preços e especificações lado a lado.
Comparar Florence-2 Segmentation e BLIPFlorence-2 Segmentation pode processar imagens?
Sim. Florence-2 Segmentation aceita imagens como entrada além de texto.
Modelos comparáveis
Todos nesta categoria- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ US$ 0,0457/execução
3.708 % mais caro por unidade
Comparar Florence-2 Segmentation vs. CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ US$ 0,0050/execução
317 % mais caro por unidade
Comparar Florence-2 Segmentation vs. Depth Anything v2
Todos os modelos através de uma API
Uma chave API para todos os modelos no Railwail. O uso é cobrado a partir de créditos pré-pagos, 1 crédito = US$ 0,01.