
PaddleOCR v3
paddleocr-v3Baidu PaddleOCR v3 PP-OCR pipeline. Lightweight detector plus recognizer optimized for production use with 80+ language support.
- Preço
- ≈ US$ 0,0216/execução
- Entrada → Saída
- Texto + Imagem → Texto
- Desenvolvedor
- Community
- Atualizado
- 23 de setembro de 2026
Playground
Experimentar PaddleOCR v3
Sem formulário de entrada
Ainda não há formulário de entrada para este modelo
Suas entradas ainda não foram documentadas. Para que nenhuma execução falhe com uma entrada incorreta, não oferecemos um formulário aqui. Escolha um modelo comparável em vez disso.
Examples
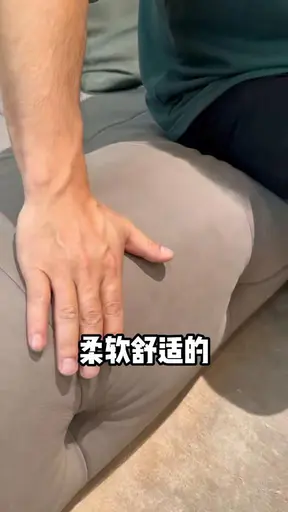 Input
No text prompt: the model only takes the input shown.
Output (JSON, shortened)
{ "results": [ { "box": [ [ 161, 669 ], [ 418, 669 ], [ 418, 732 ], [ 161, 732 ] ], "text": "柔软舒适的", "confidence": 0.9974066019058228 } ] }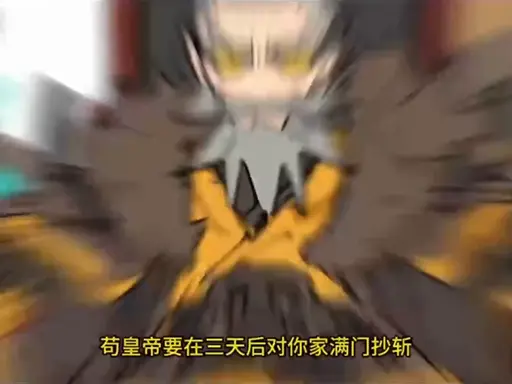 Input
No text prompt: the model only takes the input shown.
Output (JSON, shortened)
{
  "results": [
    {
      "box": [
        [
          285,
          947
        ],
        [
          1155,
          948
        ],
        [
          1155,
          1000
        ],
        [
          285,
          999
        ]
      ],
      "text": "苟皇帝要在三天后对你家满门抄斩",
      "confidence": 0.9324864745140076
    }
  ]
}
Sobre PaddleOCR v3
PaddleOCR v3 é um modelo de Community na categoria Multimodal. No Railwail, PaddleOCR v3 custa ≈ US$ 0,0216 por execução.
Preços
| Execução típica (≈ 80 s em T4) | US$ 0,0216 por execução |
|---|---|
| Tempo de GPU (T4) | US$ 0,00027 por segundo de GPU |
- Faturado pelo tempo de GPU que a execução realmente leva. Quando a execução começa, 3× o preço típico é reservado do seu saldo e liquidado depois.
- 1 crédito = US$ 0,01
Calculadora de custos
Calculadora de preços
Típico conforme o provedor: cerca de 80 s
Total
US$ 2,16
216 créditos
Por execução
US$ 0,0216 · 2,16 créditos
Faturado pelo tempo real de GPU; este é uma estimativa.
API
Nenhum exemplo de API verificado
A API pública passa um formato de entrada diferente do que este modelo precisa. Use o playground acima.
Especificações
- ID do modelo
paddleocr-v3- Desenvolvedor
- Community
- Categoria
- Multimodal
- Entrada
- Texto, Imagem
- Saída
- Texto
- Faturamento
- Por uso (tokens ou tempo de GPU)
- Entrada do catálogo atualizada
- 23 de setembro de 2026
Etiquetas
- replicate
- ocr
- vision-understanding
- baidu
- open-source
- multilingual
Perguntas frequentes
O que é PaddleOCR v3?
PaddleOCR v3 é um modelo de Community na categoria Multimodal.
Quanto custa PaddleOCR v3 no Railwail?
No Railwail, PaddleOCR v3 custa ≈ US$ 0,0216 por execução. Você é cobrado pelo que cada solicitação realmente usa. O uso é pago com créditos pré-pagos; 1 crédito equivale a US$ 0,01.
Qual é a velocidade de PaddleOCR v3?
Ainda não há execuções medidas suficientes de PaddleOCR v3 no Railwail para indicar um tempo de execução. Depende da entrada, das configurações e da carga no provedor.
PaddleOCR v3 é melhor que BLIP?
Depende da tarefa. PaddleOCR v3 (Community) e BLIP (Salesforce) são ambos modelos na categoria Multimodal. A página de comparação mostra seus preços e especificações lado a lado.
Comparar PaddleOCR v3 e BLIPPaddleOCR v3 pode processar imagens?
Sim. PaddleOCR v3 aceita imagens como entrada além de texto.
Modelos comparáveis
Todos nesta categoria- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Todos os modelos através de uma API
Uma chave API para todos os modelos no Railwail. O uso é cobrado a partir de créditos pré-pagos, 1 crédito = US$ 0,01.