
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Preț
- ≈ 0,0012 USD/rulare
- Intrare → ieșire
- Text + Imagine → Text
- Dezvoltator
- Community
- Actualizat
- 23 septembrie 2026
Playground
Încearcă Florence-2 Large
Intrare & rezultat
Această rulare
aproximativ 0,0012 USD · 0,12 credite
La start se rezervă 0,0036 USD (0,36 credite); se factureaza timpul GPU real.
Nou aici?
10 credite gratuite (0,10 USD) când te înregistrezi cu Google
Utilizabil 24 ore după înregistrare, până la 5 rulări pe zi și maximum 2 credite pe rulare. Alte metode de conectare încep fără credite. Suficient pentru 27 de rulări ale acestui model.
Examples
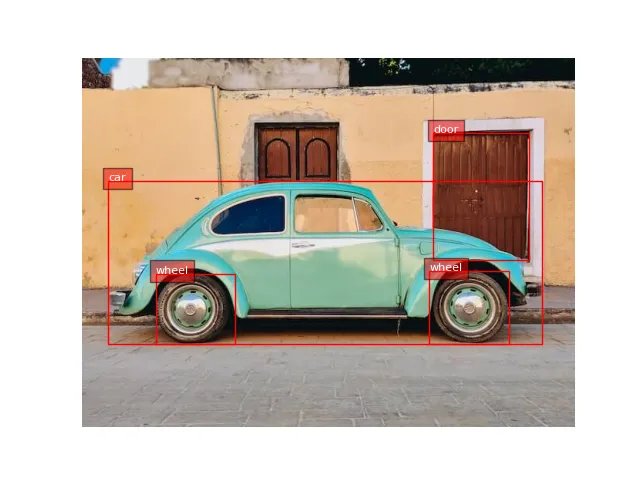 Open full size
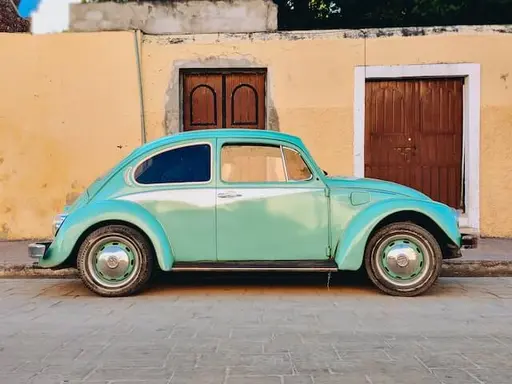 Input
No text prompt: the model only takes the input shown.
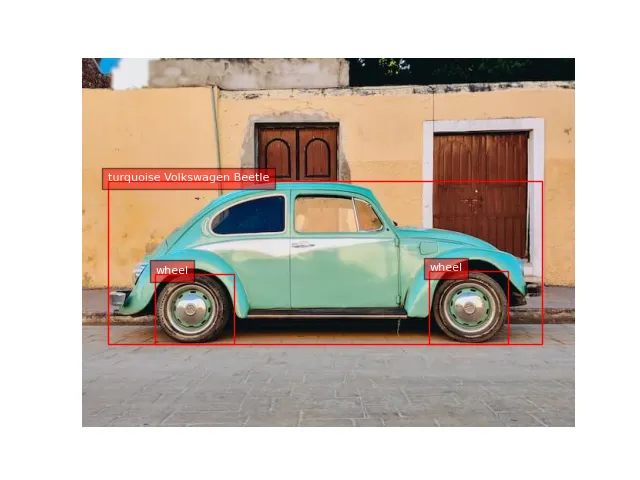 Open full size
 Input
No text prompt: the model only takes the input shown.
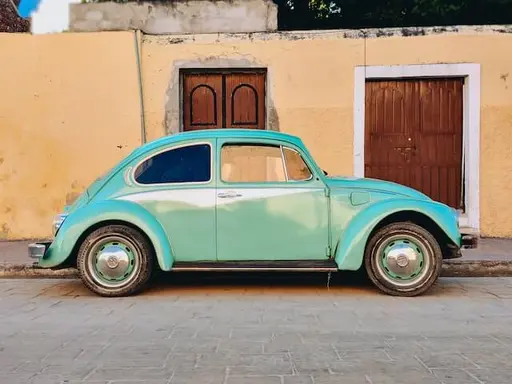
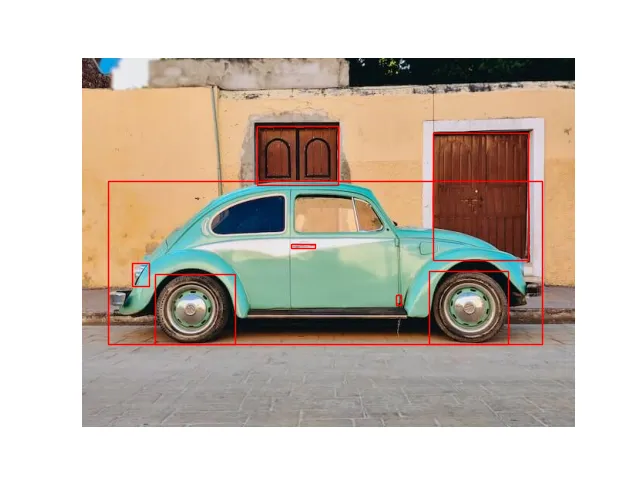 Open full size
 Input
No text prompt: the model only takes the input shown.
Despre Florence-2 Large
Florence-2 Large este un model de Community din categoria Multimodal. Pe Railwail, Florence-2 Large costă ≈ 0,0012 USD per rulare.
Prețuri
| Rulare tipică (≈ 1 s pe L40S) | 0,0012 USD per rulare |
|---|---|
| Timp GPU (L40S) | 0,00117 USD per secundă GPU |
- Se facturează timpul GPU pe care îl necesită efectiv rularea. La pornire, se rezervă din soldul tău 3× prețul tipic și se decontează ulterior.
- 1 credit = 0,01 USD
Calculator de costuri
Calculator de preț
Tipic conform furnizorului: aprox. 1 s
Total
0,12 USD
12 credite
Pe rulare
0,0012 USD · 0,12 credite
Se factură după timpul GPU real; aceasta este o estimare.
API
Niciun exemplu API verificat
API-ul public transmite un format de intrare diferit de ceea ce are nevoie acest model. Folosește playground-ul de mai sus.
Specificații
- ID model
florence-2-large- Dezvoltator
- Community
- Categorie
- Multimodal
- Intrare
- Text, Imagine
- Ieșire
- Text
- Facturare
- După utilizare (tokeni sau timp GPU)
- Intrare catalog actualizată
- 23 septembrie 2026
Parametri de intrare
Intrări și setări din schema de intrare a modelului. Exemplul din secțiunea API arată care dintre ele acceptă API-ul.
promptobligatoriuUser message or task instruction
Tip: TextImplicit: –Valori permise: până la 4.000 caracteretaskTip: AlegereImplicit:captionValori permise: caption, detailed_caption, ocr, object_detection sau segmentationimage_urlImage URL to analyze
Tip: TextImplicit: –Valori permise: –max_tokensTip: Număr întregImplicit:1024Valori permise: 1 până la 4.096temperatureTip: NumărImplicit:0.7Valori permise: 0 până la 2
Etichete
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Întrebări frecvente
Ce este Florence-2 Large?
Florence-2 Large este un model de Community din categoria Multimodal.
Cât costă Florence-2 Large pe Railwail?
Pe Railwail, Florence-2 Large costă ≈ 0,0012 USD per rulare. Ți se percepe taxa pentru ceea ce fiecare cerere folosește efectiv. Utilizarea se plătește din credite prepay; 1 credit egal cu 0,01 USD.
Ce setări acceptă Florence-2 Large?
Conform schemei sale de intrare, Florence-2 Large cunoaște acești parametri: prompt (până la 4.000 caractere), task (caption, detailed_caption, ocr, object_detection sau segmentation), image_url, max_tokens (1 până la 4.096) și temperature (0 până la 2).
Cât de rapid este Florence-2 Large?
Nu sunt suficiente rulări măsurate ale Florence-2 Large pe Railwail încă pentru a indica un timp de rulare. Depinde de intrare, de setări și de sarcina la furnizor.
Este Florence-2 Large mai bun decât BLIP?
Depinde de sarcină. Florence-2 Large (Community) și BLIP (Salesforce) sunt ambele modele din categoria Multimodal. Pagina de comparație arată prețurile și specificațiile lor una lângă alta.
Compară Florence-2 Large și BLIPPoate Florence-2 Large procesa imagini?
Da. Florence-2 Large acceptă imagini ca intrare, pe lângă text.
Modele comparabile
Toate din această categorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Toate modelele printr-o singură API
O cheie API pentru fiecare model pe Railwail. Utilizarea se percepe din credite prepay, 1 credit = 0,01 USD.