
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Preț
- ≈ 0,0012 USD/rulare
- Intrare → ieșire
- Text + Imagine → Text
- Dezvoltator
- Community
- Actualizat
- 23 septembrie 2026
Playground
Încearcă Florence-2 Segmentation
Fără formular de intrare
Nicio formă de intrare pentru acest model încă
Intrările sale nu sunt documentate încă. Pentru ca nicio rulare să nu eșueze din cauza unei intrări greșite, nu oferim un formular aici. Alege în schimb un model comparabil.
Examples
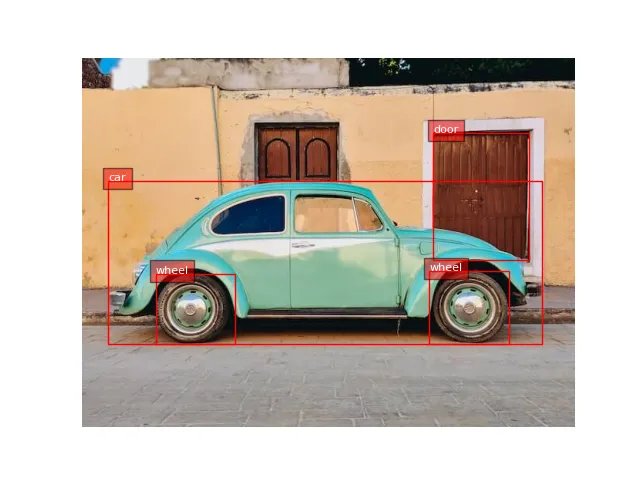 Open full size
 Input
No text prompt: the model only takes the input shown.
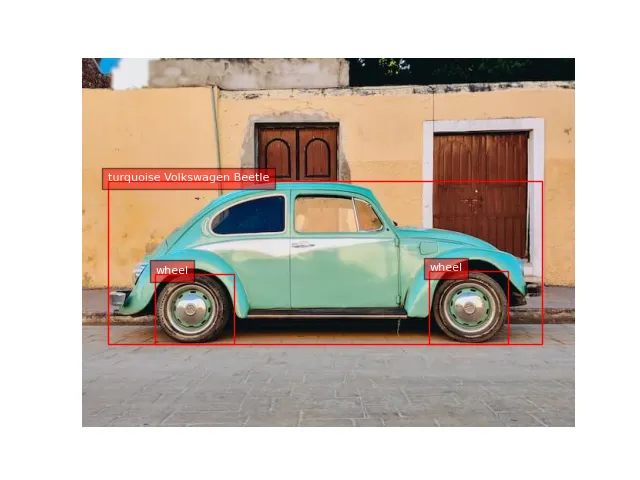 Open full size
 Input
No text prompt: the model only takes the input shown.
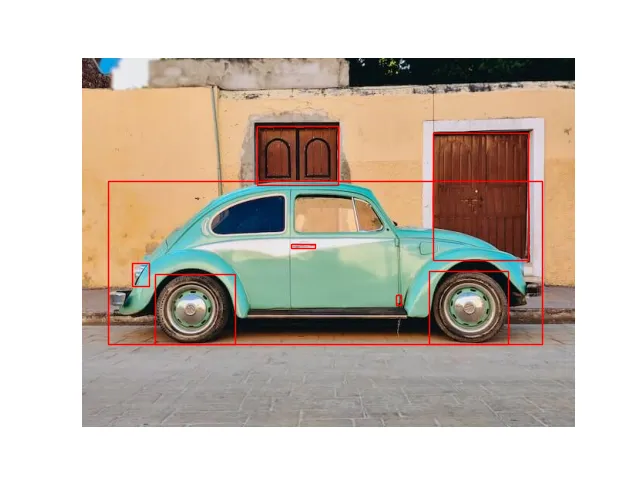 Open full size
 Input
No text prompt: the model only takes the input shown.
Despre Florence-2 Segmentation
Florence-2 Segmentation este un model de Community din categoria Multimodal. Pe Railwail, Florence-2 Segmentation costă ≈ 0,0012 USD per rulare.
Prețuri
| Rulare tipică (≈ 1 s pe L40S) | 0,0012 USD per rulare |
|---|---|
| Timp GPU (L40S) | 0,00117 USD per secundă GPU |
- Se facturează timpul GPU pe care îl necesită efectiv rularea. La pornire, se rezervă din soldul tău 3× prețul tipic și se decontează ulterior.
- 1 credit = 0,01 USD
Calculator de costuri
Calculator de preț
Tipic conform furnizorului: aprox. 1 s
Total
0,12 USD
12 credite
Pe rulare
0,0012 USD · 0,12 credite
Se factură după timpul GPU real; aceasta este o estimare.
API
Niciun exemplu API verificat
API-ul public transmite un format de intrare diferit de ceea ce are nevoie acest model. Folosește playground-ul de mai sus.
Specificații
- ID model
florence-2-segmentation- Dezvoltator
- Community
- Categorie
- Multimodal
- Intrare
- Text, Imagine
- Ieșire
- Text
- Facturare
- După utilizare (tokeni sau timp GPU)
- Intrare catalog actualizată
- 23 septembrie 2026
Etichete
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Întrebări frecvente
Ce este Florence-2 Segmentation?
Florence-2 Segmentation este un model de Community din categoria Multimodal.
Cât costă Florence-2 Segmentation pe Railwail?
Pe Railwail, Florence-2 Segmentation costă ≈ 0,0012 USD per rulare. Ți se percepe taxa pentru ceea ce fiecare cerere folosește efectiv. Utilizarea se plătește din credite prepay; 1 credit egal cu 0,01 USD.
Cât de rapid este Florence-2 Segmentation?
Nu sunt suficiente rulări măsurate ale Florence-2 Segmentation pe Railwail încă pentru a indica un timp de rulare. Depinde de intrare, de setări și de sarcina la furnizor.
Este Florence-2 Segmentation mai bun decât BLIP?
Depinde de sarcină. Florence-2 Segmentation (Community) și BLIP (Salesforce) sunt ambele modele din categoria Multimodal. Pagina de comparație arată prețurile și specificațiile lor una lângă alta.
Compară Florence-2 Segmentation și BLIPPoate Florence-2 Segmentation procesa imagini?
Da. Florence-2 Segmentation acceptă imagini ca intrare, pe lângă text.
Modele comparabile
Toate din această categorie- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ 0,0457 USD/rulare
3.708 % mai scump pe unitate
Compară Florence-2 Segmentation vs. CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Toate modelele printr-o singură API
O cheie API pentru fiecare model pe Railwail. Utilizarea se percepe din credite prepay, 1 credit = 0,01 USD.