
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Цена
- ≈ 0,0086 US$/покретање
- Контекст
- 4.096 токена
- Макс. излаз
- 2.048 токена
- Унос → излаз
- Текст + Слика → Текст
- Програмер
- DeepSeek
- Ажурирано
- 23. септембар 2026.
Плејграунд
Пробајте DeepSeek-VL 7B
Нема маске за унос
За овај модел још нема маске за унос
Његови уноси још нису документовани. Да би се избегло неуспешно покретање због погрешног уноса, овде не нудимо образац. Уместо тога, изаберите упоредив модел.
Examples
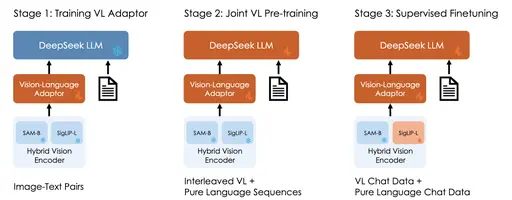 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
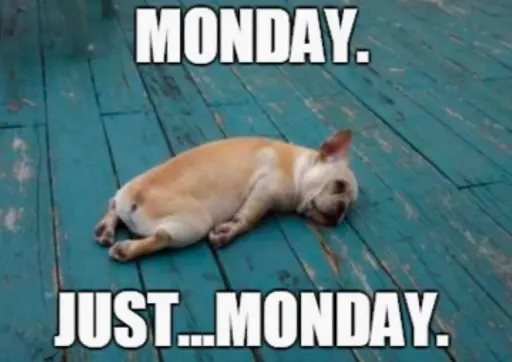 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
О DeepSeek-VL 7B
DeepSeek-VL 7B је модел од DeepSeek из категорије Мултимодално. На Railwail-у, DeepSeek-VL 7B кошта ≈ 0,0086 US$ по покретању. Контекстни прозор садржи 4.096 токена, а један одговор може бити дугачак до 2.048 токена.
Цене
| Типично покретање (≈ 7 s на L40S) | 0,0086 US$ по покретању |
|---|---|
| GPU време (L40S) | 0,00117 US$ по GPU секунди |
- Наплаћује се GPU време које покретање заиста траје. Када се покретање почне, 3× типична цена се резервише са вашег салда и касније се намирава.
- 1 кредит = 0,01 US$
Калкулатор трошкова
Калкулатор цена
Типично према добављачу: око 7,3 s
Укупно
0,86 US$
86 кредита
По покретању
0,0086 US$ · 0,86 кредита
Наплаћује се стварно време GPU; ово је процена.
API
Нема верификованог API примера
Јавни API прослеђује другачији формат улаза него што овај модел треба. Користите playground изнад.
Спецификације
- ID модела
deepseek-vl-7b- Програмер
- DeepSeek
- Категорија
- Мултимодално
- Унос
- Текст, Слика
- Излаз
- Текст
- Контекстни прозор
- 4.096 токена
- Макс. излаз
- 2.048 токена
- Наплата
- По потрошњи (токени или GPU време)
- Унос у каталог ажуриран
- 23. септембар 2026.
Ознаке
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Често постављана питања
Шта је DeepSeek-VL 7B?
DeepSeek-VL 7B је модел од DeepSeek у категорији Мултимодално.
Колико кошта DeepSeek-VL 7B на Railwail-у?
На Railwail-у, DeepSeek-VL 7B кошта ≈ 0,0086 US$ по покретању. Наплаћује се оно што свака захтева заиста користи. Коришћење се плаћа из унапред припремљених кредита; 1 кредит је једнак 0,01 US$.
Колики је контекстни прозор од DeepSeek-VL 7B?
Контекстни прозор од DeepSeek-VL 7B садржи 4.096 токена. Један одговор може бити дугачак до 2.048 токена.
Колико је брз DeepSeek-VL 7B?
За DeepSeek-VL 7B на Railwail-у још нема довољно измерених покретања да би се наводило време извршавања. Зависи од уноса, поставки и оптерећења код пружаоца услуге.
Да ли је DeepSeek-VL 7B бољи од BLIP?
То зависи од задатка. DeepSeek-VL 7B (DeepSeek) и BLIP (Salesforce) су оба модела у категорији Мултимодално. Страница за поређење приказује њихове цене и спецификације упоредо.
Упоредите DeepSeek-VL 7B и BLIPМоже ли DeepSeek-VL 7B обрадити слике?
Да. DeepSeek-VL 7B прихвата слике као унос поред текста.
Упоредиви модели
Сви у овој категорији- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Сви модели преко једног API-ја
Један API кључ за сваки модел на Railwail. Употреба се наплаћује из унапред припремљених кредита, 1 кредит = 0,01 US$.