
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Pris
- ≈ 0,0012 US$/körning
- Inmatning → utmatning
- Text + Bild → Text
- Utvecklare
- Community
- Uppdaterad
- 23 september 2026
Playground
Prova Florence-2 Large
Inmatning & resultat
Denna körning
ca. 0,0012 US$ · 0,12 credits
0,0036 US$ (0,36 credits) reserveras vid start; den faktiska GPU-tiden faktureras.
Ny här?
10 gratis credits (0,10 US$) när du registrerar dig med Google
Användbar 24 timmar efter registrering, upp till 5 körningar per dag och högst 2 credits per körning. Andra inloggningsmetoder startar utan credits. Räcker för 27 körningar av denna modell.
Examples
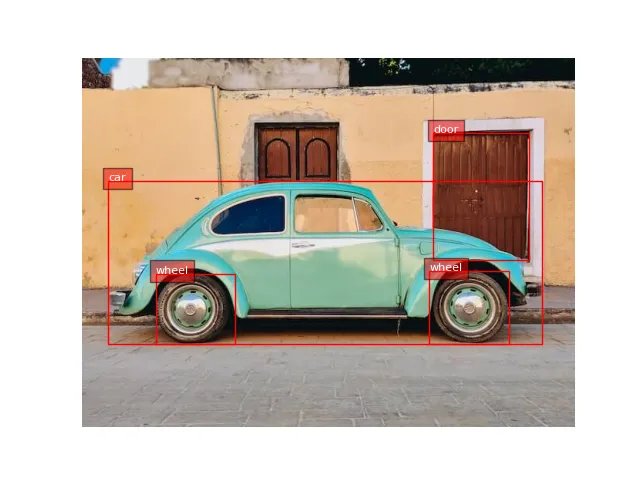 Open full size
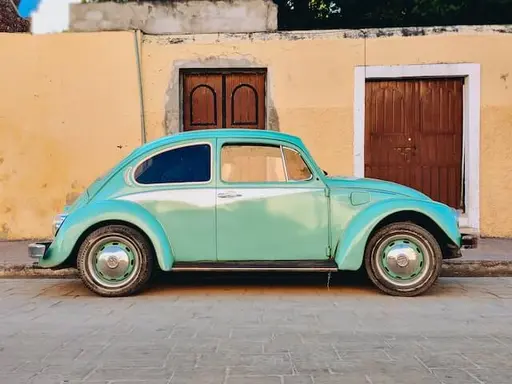 Input
No text prompt: the model only takes the input shown.
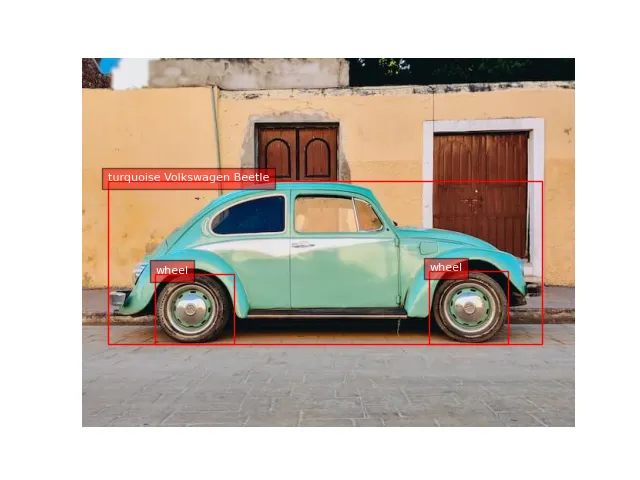 Open full size
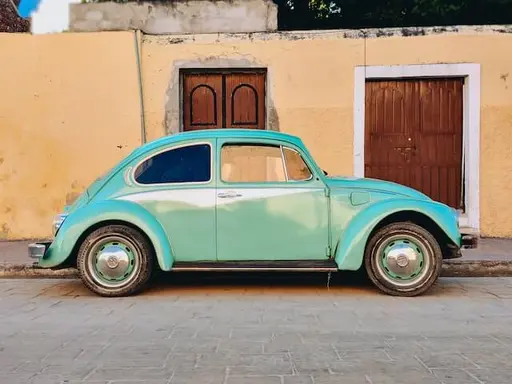 Input
No text prompt: the model only takes the input shown.
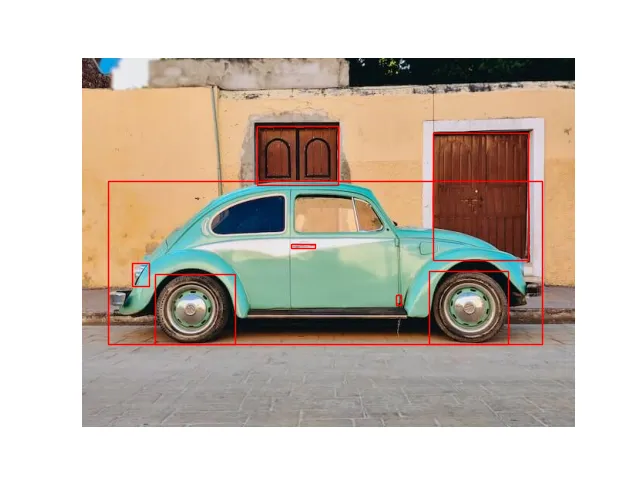 Open full size
 Input
No text prompt: the model only takes the input shown.
Om Florence-2 Large
Florence-2 Large är en modell av Community i kategorin Multimodal. På Railwail kostar Florence-2 Large ≈ 0,0012 US$ per körning.
Priser
| Typisk körning (≈ 1 s på L40S) | 0,0012 US$ per körning |
|---|---|
| GPU-tid (L40S) | 0,00117 US$ per GPU-sekund |
- Faktureras enligt den GPU-tid som körningen faktiskt tar. När körningen startar reserveras 3× det typiska priset från ditt saldo och regleras efteråt.
- 1 kredit = 0,01 US$
Kostnadsräknare
Prisräknare
Typisk enligt leverantören: ca 1 s
Totalt
0,12 US$
12 krediter
Per körning
0,0012 US$ · 0,12 krediter
Faktureras enligt faktisk GPU-tid; detta är en uppskattning.
API
Inget verifierat API-exempel
Det offentliga API:et skickar ett annat inmatningsformat än vad denna modell behöver. Använd lekplatsen ovan.
Specifikationer
- Modell-ID
florence-2-large- Utvecklare
- Community
- Kategori
- Multimodal
- Inmatning
- Text, Bild
- Utmatning
- Text
- Fakturering
- Efter användning (tokens eller GPU-tid)
- Kataloginlägg uppdaterat
- 23 september 2026
Indataparametrar
Inmatningar och inställningar från modellens indataschema. Exemplet i API-avsnittet visar vilka som API:et accepterar.
promptobligatoriskUser message or task instruction
Typ: TextStandard: –Tillåtna värden: upp till 4 000 teckentaskTyp: ValStandard:captionTillåtna värden: caption, detailed_caption, ocr, object_detection eller segmentationimage_urlImage URL to analyze
Typ: TextStandard: –Tillåtna värden: –max_tokensTyp: HeltalStandard:1024Tillåtna värden: 1 till 4 096temperatureTyp: TalStandard:0.7Tillåtna värden: 0 till 2
Taggar
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Vanliga frågor
Vad är Florence-2 Large?
Florence-2 Large är en modell av Community i kategorin Multimodal.
Vad kostar Florence-2 Large på Railwail?
På Railwail kostar Florence-2 Large ≈ 0,0012 US$ per körning. Du debiteras för det som varje begäran faktiskt använder. Användningen betalas från förbetald kredit; 1 kredit motsvarar 0,01 US$.
Vilka inställningar stöder Florence-2 Large?
Enligt sitt inmatningsschema känner Florence-2 Large till dessa parametrar: prompt (upp till 4 000 tecken), task (caption, detailed_caption, ocr, object_detection eller segmentation), image_url, max_tokens (1 till 4 096) och temperature (0 till 2).
Hur snabb är Florence-2 Large?
Det finns ännu inte tillräckligt många uppmätta körningar av Florence-2 Large på Railwail för att ange en körningstid. Det beror på inmatningen, inställningarna och belastningen hos leverantören.
Är Florence-2 Large bättre än BLIP?
Det beror på uppgiften. Florence-2 Large (Community) och BLIP (Salesforce) är båda modeller i kategorin Multimodal. Jämförelsesidan visar deras priser och specifikationer sida vid sida.
Jämför Florence-2 Large och BLIPKan Florence-2 Large bearbeta bilder?
Ja. Florence-2 Large accepterar bilder som inmatning utöver text.
Jämförbara modeller
Alla i denna kategori- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alla modeller via ett API
En API-nyckel för alla modeller på Railwail. Användningen debiteras från förbetald kredit, 1 kredit = 0,01 US$.