
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Pris
- ≈ 0,0012 US$/körning
- Inmatning → utmatning
- Text + Bild → Text
- Utvecklare
- Community
- Uppdaterad
- 23 september 2026
Playground
Prova Florence-2 Segmentation
Ingen inmatningsformulär
Ingen inmatningsformulär för denna modell än
Dess inmatningar är ännu inte dokumenterade. För att ingen körning ska misslyckas på grund av felaktig inmatning erbjuder vi ingen formulär här. Välj istället en jämförbar modell.
Examples
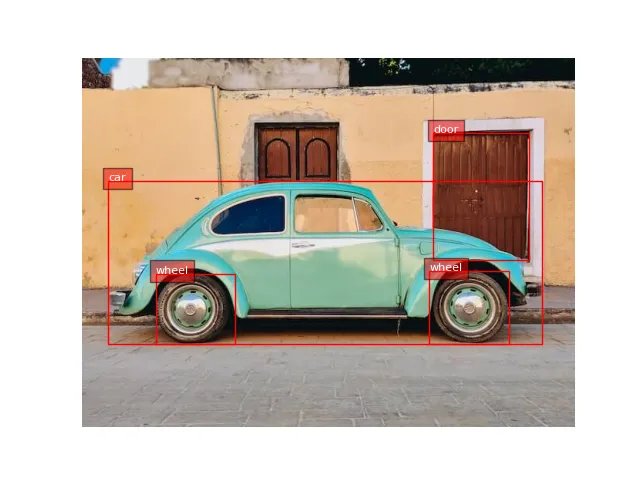 Open full size
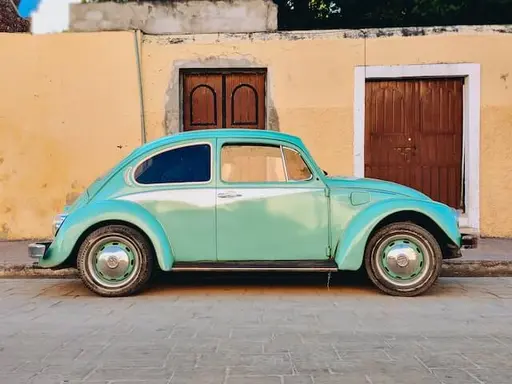 Input
No text prompt: the model only takes the input shown.
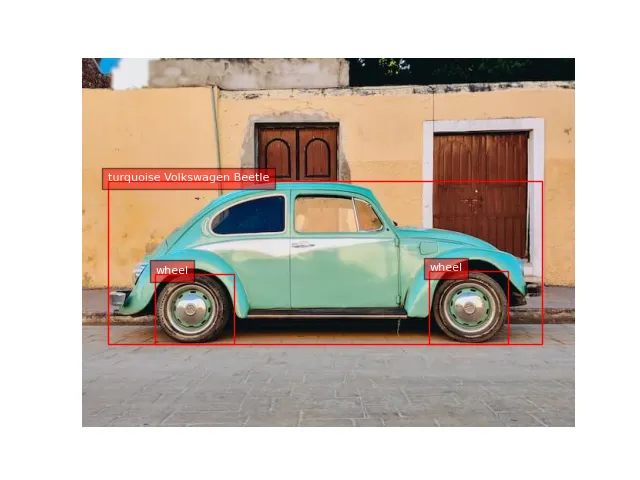 Open full size
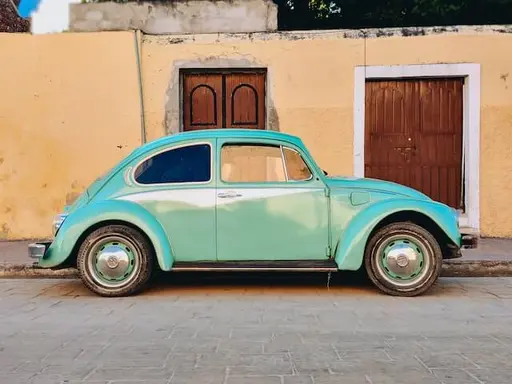 Input
No text prompt: the model only takes the input shown.
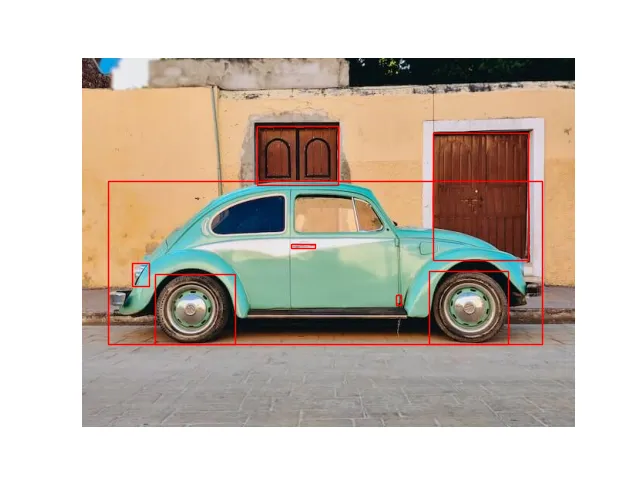 Open full size
 Input
No text prompt: the model only takes the input shown.
Om Florence-2 Segmentation
Florence-2 Segmentation är en modell av Community i kategorin Multimodal. På Railwail kostar Florence-2 Segmentation ≈ 0,0012 US$ per körning.
Priser
| Typisk körning (≈ 1 s på L40S) | 0,0012 US$ per körning |
|---|---|
| GPU-tid (L40S) | 0,00117 US$ per GPU-sekund |
- Faktureras enligt den GPU-tid som körningen faktiskt tar. När körningen startar reserveras 3× det typiska priset från ditt saldo och regleras efteråt.
- 1 kredit = 0,01 US$
Kostnadsräknare
Prisräknare
Typisk enligt leverantören: ca 1 s
Totalt
0,12 US$
12 krediter
Per körning
0,0012 US$ · 0,12 krediter
Faktureras enligt faktisk GPU-tid; detta är en uppskattning.
API
Inget verifierat API-exempel
Det offentliga API:et skickar ett annat inmatningsformat än vad denna modell behöver. Använd lekplatsen ovan.
Specifikationer
- Modell-ID
florence-2-segmentation- Utvecklare
- Community
- Kategori
- Multimodal
- Inmatning
- Text, Bild
- Utmatning
- Text
- Fakturering
- Efter användning (tokens eller GPU-tid)
- Kataloginlägg uppdaterat
- 23 september 2026
Taggar
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Vanliga frågor
Vad är Florence-2 Segmentation?
Florence-2 Segmentation är en modell av Community i kategorin Multimodal.
Vad kostar Florence-2 Segmentation på Railwail?
På Railwail kostar Florence-2 Segmentation ≈ 0,0012 US$ per körning. Du debiteras för det som varje begäran faktiskt använder. Användningen betalas från förbetald kredit; 1 kredit motsvarar 0,01 US$.
Hur snabb är Florence-2 Segmentation?
Det finns ännu inte tillräckligt många uppmätta körningar av Florence-2 Segmentation på Railwail för att ange en körningstid. Det beror på inmatningen, inställningarna och belastningen hos leverantören.
Är Florence-2 Segmentation bättre än BLIP?
Det beror på uppgiften. Florence-2 Segmentation (Community) och BLIP (Salesforce) är båda modeller i kategorin Multimodal. Jämförelsesidan visar deras priser och specifikationer sida vid sida.
Jämför Florence-2 Segmentation och BLIPKan Florence-2 Segmentation bearbeta bilder?
Ja. Florence-2 Segmentation accepterar bilder som inmatning utöver text.
Jämförbara modeller
Alla i denna kategori- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Alla modeller via ett API
En API-nyckel för alla modeller på Railwail. Användningen debiteras från förbetald kredit, 1 kredit = 0,01 US$.