
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cena
- ≈ 0,0012 $/zagon
- Vhod → Izhod
- Besedilo + Slika → Besedilo
- Razvijalec
- Community
- Posodobljeno
- 23. september 2026
Igrišče
Preizkusi Florence-2 Large
Vnos in rezultat
Ta zagon
približno 0,0012 $ · 0,12 kreditov
Na začetku se rezervira 0,0036 $ (0,36 kreditov); obračunava se dejanski čas GPU.
Novo tukaj?
10 brezplačnih kreditov (0,10 $) ob prijavi z Googlom
Uporabno 24 ur po prijavi, do 5 zaganom na dan in največ 2 kreditov na zagon. Druge metode prijave se začnejo brez kreditov. Dovolj za 27 zagonov tega modela.
Examples
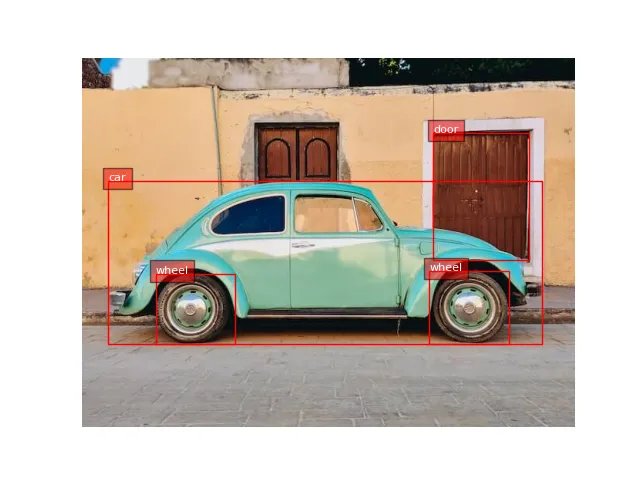 Open full size
 Input
No text prompt: the model only takes the input shown.
 Open full size
 Input
No text prompt: the model only takes the input shown.
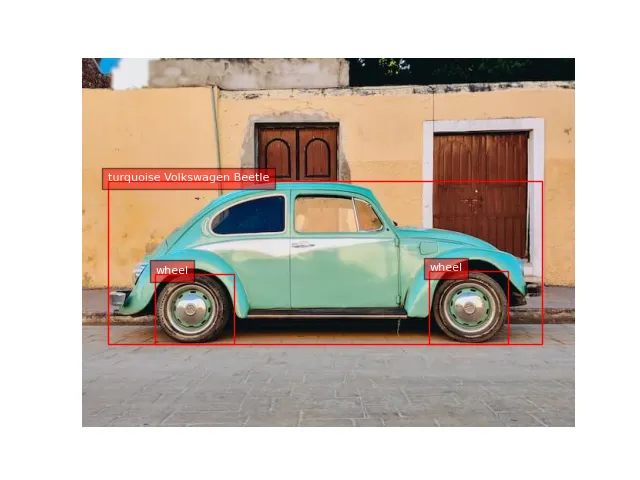
 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Large
Florence-2 Large je model razvijalca Community iz kategorije Multimodalno. Na Railwail stane Florence-2 Large ≈ 0,0012 $ na zagon.
Cene
| Tipičen zagon (≈ 1 s na L40S) | 0,0012 $ na zagon |
|---|---|
| Čas GPU (L40S) | 0,00117 $ na sekundo GPU |
- Obračunan je čas GPU, ki ga zagon dejansko potrebuje. Ko se zagon začne, se od vašega stanja rezervira 3× tipična cena in se pozneje poravna.
- 1 kredit = 0,01 $
Kalkulator stroškov
Kalkulator cen
Tipično po ponudniku: približno 1 s
Skupaj
0,12 $
12 kreditov
Na zagon
0,0012 $ · 0,12 kreditov
Obračunava se dejanski čas GPU; to je ocena.
API
Ni preverjenega primera API
Javni API prosledi drugačno obliko vnosa, kot jo potrebuje ta model. Uporabite igrišče zgoraj.
Specifikacije
- ID modela
florence-2-large- Razvijalec
- Community
- Kategorija
- Multimodalno
- Vhod
- Besedilo, Slika
- Izhod
- Besedilo
- Obračunavanje
- Po porabi (žetoni ali čas GPU)
- Kataložni vnos posodobljen
- 23. september 2026
Vhodne parametre
Vhodi in nastavitve iz vhodne sheme modela. Primer v razdelku API prikazuje, katere od njih API sprejema.
promptObveznoUser message or task instruction
Tip: BesediloPrivzeto: –Dovoljene vrednosti: Do 4000 znakovtaskTip: IzbiraPrivzeto:captionDovoljene vrednosti: caption, detailed_caption, ocr, object_detection ali segmentationimage_urlImage URL to analyze
Tip: BesediloPrivzeto: –Dovoljene vrednosti: –max_tokensTip: Celo številoPrivzeto:1024Dovoljene vrednosti: 1 do 4096temperatureTip: ŠteviloPrivzeto:0.7Dovoljene vrednosti: 0 do 2
Oznake
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Pogosta vprašanja
Kaj je Florence-2 Large?
Florence-2 Large je model podjetja Community iz kategorije Multimodalno.
Koliko stane Florence-2 Large na Railwailu?
Na Railwail stane Florence-2 Large ≈ 0,0012 $ na zagon. Zaračunano vam je tisto, kar vsaka zahteva dejansko porabi. Uporaba se plača s predplačanimi krediti; 1 kredit je enak 0,01 $.
Katere nastavitve podpira Florence-2 Large?
Glede na shemo vnosa Florence-2 Large pozna te parametre: prompt (Do 4000 znakov), task (caption, detailed_caption, ocr, object_detection ali segmentation), image_url, max_tokens (1 do 4096) in temperature (0 do 2).
Kako hiter je Florence-2 Large?
Za Florence-2 Large je na Railwailu še premalo izmerjenih zagonov, da bi navedli čas izvajanja. Odvisno je od vnosa, nastavitev in obremenitve pri ponudniku.
Je Florence-2 Large boljši od BLIP?
To je odvisno od naloge. Florence-2 Large (Community) in BLIP (Salesforce) sta oba modela iz kategorije Multimodalno. Stran za primerjavo prikazuje njune cene in specifikacije drug ob drugem.
Primerjaj Florence-2 Large in BLIPAli Florence-2 Large lahko obdeluje slike?
Da. Florence-2 Large sprejema slike kot vhod poleg besedila.
Primerljivi modeli
Vsi v tej kategoriji- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Vsi modeli prek ene API
En API ključ za vsak model na Railwail. Uporaba se obračuna iz vnaprej plačanih kreditov, 1 kredit = 0,01 $.