
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cena
- ≈ 0,0012 USD/spustenie
- Vstup → výstup
- Text + Obrázok → Text
- Vývojár
- Community
- Aktualizované
- 23. septembra 2026
Playground
Vyskúšajte Florence-2 Large
Vstup a výstup
Tento beh
približne 0,0012 USD · 0,12 credits
Na začiatku sa rezervuje 0,0036 USD (0,36 credits); fakturuje sa skutočný čas GPU.
Nový tu?
10 bezplatných credits (0,10 USD) pri registrácii cez Google
Použiteľné 24 hodín po registrácii, až 5 behov za deň a maximálne 2 credits za beh. Ostatné spôsoby prihlásenia sa spúšťajú bez credits. Stačí na 27 spustení tohto modelu.
Examples
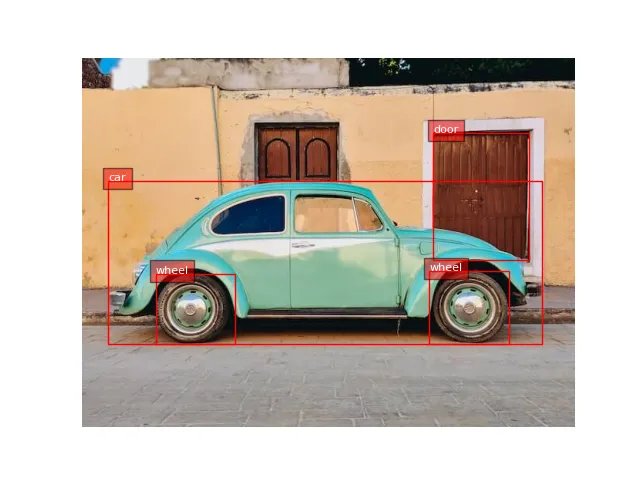 Open full size
 Input
No text prompt: the model only takes the input shown.
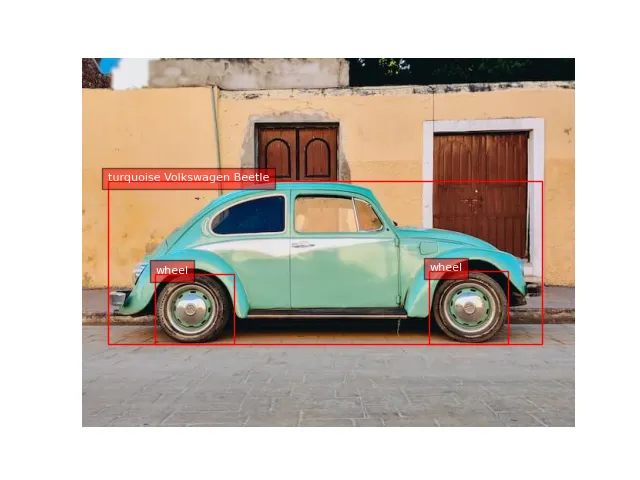 Open full size
 Input
No text prompt: the model only takes the input shown.
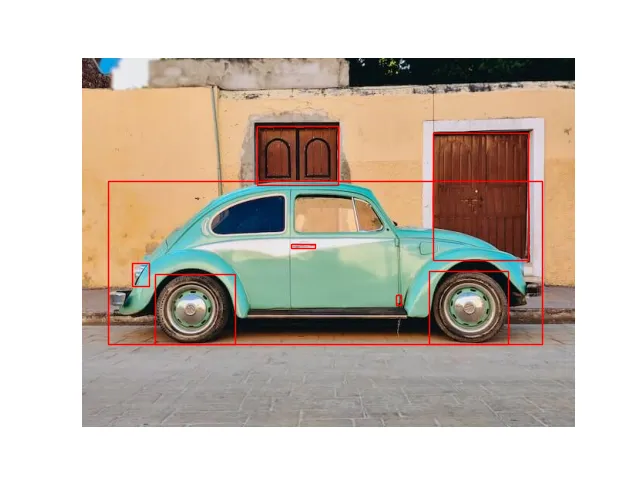 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Large
Florence-2 Large je model od Community v kategórii Multimodálne. Na Railwail stojí Florence-2 Large ≈ 0,0012 USD za spustenie.
Ceny
| Typické spustenie (≈ 1 s na L40S) | 0,0012 USD za spustenie |
|---|---|
| Čas GPU (L40S) | 0,00117 USD za sekundu GPU |
- Fakturuje sa čas GPU, ktorý spustenie skutočne trvá. Pri spustení sa z vášho zostatku rezervuje 3× typická cena a následne sa vyúčtuje.
- 1 kredit = 0,01 USD
Kalkulačka nákladov
Kalkulačka cien
Typicky podľa poskytovateľa: približne 1 s
Celkom
0,12 USD
12 kreditov
Na spustenie
0,0012 USD · 0,12 kreditov
Účtuje sa skutočný čas GPU; toto je odhad.
API
Žiadny overený príklad API
Verejné API odovzdáva iný formát vstupu, ako potrebuje tento model. Použite hraciu plochu vyššie.
Špecifikácie
- ID modelu
florence-2-large- Vývojár
- Community
- Kategória
- Multimodálne
- Vstup
- Text, Obrázok
- Výstup
- Text
- Fakturácia
- Podľa spotreby (tokeny alebo čas GPU)
- Katalógová položka aktualizovaná
- 23. septembra 2026
Vstupné parametre
Vstupy a nastavenia zo vstupnej schémy modelu. Príklad v sekcii API ukazuje, ktoré z nich API akceptuje.
promptpovinnéUser message or task instruction
Typ: TextPredvolené: –Povolené hodnoty: až 4 000 znakovtaskTyp: VýberPredvolené:captionPovolené hodnoty: caption, detailed_caption, ocr, object_detection alebo segmentationimage_urlImage URL to analyze
Typ: TextPredvolené: –Povolené hodnoty: –max_tokensTyp: Celé čísloPredvolené:1024Povolené hodnoty: 1 až 4 096temperatureTyp: ČísloPredvolené:0.7Povolené hodnoty: 0 až 2
Značky
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Často kladené otázky
Čo je Florence-2 Large?
Florence-2 Large je model od Community v kategórii Multimodálne.
Koľko stojí Florence-2 Large na Railwail?
Na Railwail stojí Florence-2 Large ≈ 0,0012 USD za spustenie. Platíte za to, čo každý požiadavok skutočne spotrebuje. Použitie sa platí z predplateného kreditu; 1 kredit sa rovná 0,01 USD.
Ktoré nastavenia podporuje Florence-2 Large?
Podľa svojej vstupnej schémy Florence-2 Large pozná tieto parametre: prompt (až 4 000 znakov), task (caption, detailed_caption, ocr, object_detection alebo segmentation), image_url, max_tokens (1 až 4 096) a temperature (0 až 2).
Ako rýchly je Florence-2 Large?
Pre Florence-2 Large je na Railwail zatiaľ príliš málo meraných spustení na určenie doby spustenia. Závisí to od vstupu, nastavení a zaťaženia u poskytovateľa.
Je Florence-2 Large lepší ako BLIP?
Závisí to od úlohy. Florence-2 Large (Community) a BLIP (Salesforce) sú oba modely v kategórii Multimodálne. Stránka porovnania zobrazuje ich ceny a špecifikácie vedľa seba.
Porovnať Florence-2 Large a BLIPMôže Florence-2 Large spracovávať obrázky?
Áno. Florence-2 Large akceptuje obrázky ako vstup okrem textu.
Porovnateľné modely
Všetky v tejto kategórii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Všetky modely cez jedno API
Jeden API kľúč pre všetky modely na Railwail. Použitie sa účtuje z predplateného kreditu, 1 kredit = 0,01 USD.