
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Fiyat
- ≈ $0,0114/çalıştırma
- Bağlam
- 8.192 token
- Maks. Çıkış
- 2.048 token
- Giriş → Çıkış
- Metin + Görüntü → Metin
- Geliştirici
- Community
- Güncellendi
- 23 Eylül 2026
Playground
CogVLM2 19B'ı deneyin
Giriş formu yok
Bu model için henüz giriş formu yok
Girdileri henüz belgelenmemiştir. Yanlış girdide hiçbir çalıştırmanın başarısız olmaması için burada form sunmuyoruz. Bunun yerine karşılaştırılabilir bir model seçin.
Examples
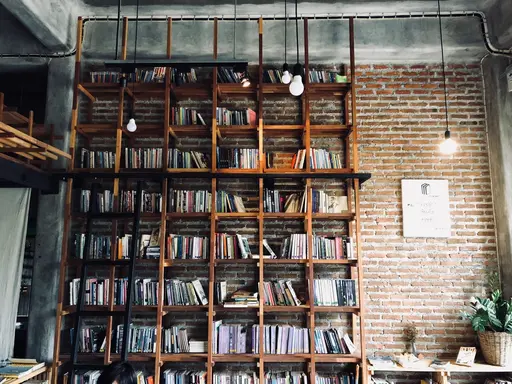 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
CogVLM2 19B Hakkında
CogVLM2 19B, Community tarafından Multimodal kategorisinde geliştirilen bir modeldir. Railwail üzerinde CogVLM2 19B maliyeti ≈ $0,0114 çalıştırma başına. Kontekst penceresi 8.192 token içerir ve bir yanıt en fazla 2.048 token uzunluğunda olabilir.
Fiyatlandırma
| Tipik çalıştırma (≈ 10 s, L40S üzerinde) | $0,0114 çalıştırma başına |
|---|---|
| GPU Süresi (L40S) | $0,00117 GPU saniyesi başına |
- Çalıştırmanın gerçekten aldığı GPU süresi için faturalandırılır. Çalıştırma başladığında, bakiyenizden tipik fiyatın 3 katı ayrılır ve daha sonra kapatılır.
- 1 kredi = $0,01
Maliyet Hesaplayıcı
Fiyat hesaplayıcı
Sağlayıcıya göre tipik: yaklaşık 9,7 s
Toplam
$1,14
114 kredi
Çalışma başına
$0,0114 · 1,14 kredi
Gerçek GPU süresi faturalandırılır; bu bir tahmindir.
API
Doğrulanmış API örneği yok
Genel API, bu modelin ihtiyaç duyduğundan farklı bir giriş biçimi iletir. Yukarıdaki oyun alanını kullanın.
Özellikler
- Model Kimliği
cogvlm2-19b- Geliştirici
- Community
- Kategori
- Multimodal
- Giriş
- Metin, Görüntü
- Çıkış
- Metin
- Bağlam penceresi
- 8.192 token
- Maks. çıkış
- 2.048 token
- Faturalandırma
- Kullanıma göre (token veya GPU süresi)
- Katalog girişi güncellendi
- 23 Eylül 2026
Etiketler
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Sık Sorulan Sorular
CogVLM2 19B nedir?
CogVLM2 19B, Community tarafından Multimodal kategorisinde oluşturulan bir modeldir.
CogVLM2 19B Railwail'de ne kadar maliyetlidir?
Railwail üzerinde CogVLM2 19B maliyeti ≈ $0,0114 çalıştırma başına. Her istek gerçekten ne kadar kullanırsa o kadar ücretlendirilirsiniz. Kullanım ön ödemeli kredilerden ödenir; 1 kredi $0,01 değerindedir.
CogVLM2 19B'nin kontekst penceresi ne kadardır?
CogVLM2 19B'nin kontekst penceresi 8.192 token içerir. Bir yanıt en fazla 2.048 token uzunluğunda olabilir.
CogVLM2 19B ne kadar hızlıdır?
Railwail'de CogVLM2 19B için henüz çalıştırma süresi belirtmek için yeterli ölçülen çalıştırma yoktur. Bu, giriş, ayarlar ve sağlayıcıdaki yüke bağlıdır.
CogVLM2 19B, BLIP'dan daha iyi midir?
Bu göreve bağlıdır. CogVLM2 19B (Community) ve BLIP (Salesforce) her ikisi de Multimodal kategorisinde modellerdir. Karşılaştırma sayfası fiyatlarını ve özelliklerini yan yana gösterir.
CogVLM2 19B ve BLIP'ı karşılaştırCogVLM2 19B görüntüleri işleyebilir mi?
Evet. CogVLM2 19B metne ek olarak giriş olarak görüntüleri kabul eder.
Karşılaştırılabilir modeller
Bu kategorideki tümü- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Tüm Modeller Tek Bir API Aracılığıyla
Railwail'deki her model için bir API anahtarı. Kullanım, ön ödemeli kredilerden tahsil edilir, 1 kredi = $0,01.