
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Fiyat
- ≈ $0,0086/çalıştırma
- Bağlam
- 4.096 token
- Maks. Çıkış
- 2.048 token
- Giriş → Çıkış
- Metin + Görüntü → Metin
- Geliştirici
- DeepSeek
- Güncellendi
- 23 Eylül 2026
Playground
DeepSeek-VL 7B'ı deneyin
Giriş formu yok
Bu model için henüz giriş formu yok
Girdileri henüz belgelenmemiştir. Yanlış girdide hiçbir çalıştırmanın başarısız olmaması için burada form sunmuyoruz. Bunun yerine karşılaştırılabilir bir model seçin.
Examples
 Input
Prompt
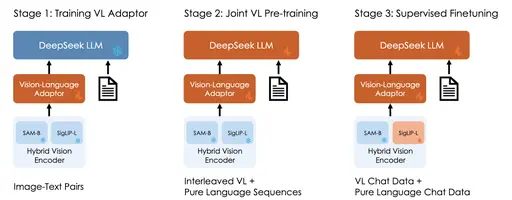
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
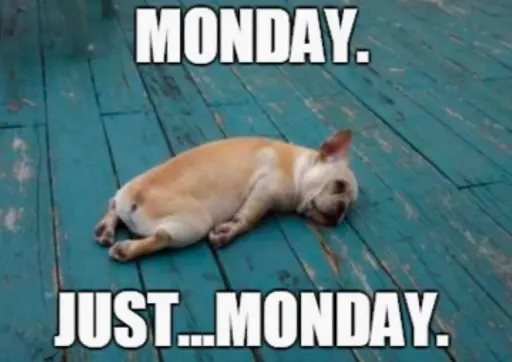
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
DeepSeek-VL 7B Hakkında
DeepSeek-VL 7B, DeepSeek tarafından Multimodal kategorisinde geliştirilen bir modeldir. Railwail üzerinde DeepSeek-VL 7B maliyeti ≈ $0,0086 çalıştırma başına. Kontekst penceresi 4.096 token içerir ve bir yanıt en fazla 2.048 token uzunluğunda olabilir.
Fiyatlandırma
| Tipik çalıştırma (≈ 7 s, L40S üzerinde) | $0,0086 çalıştırma başına |
|---|---|
| GPU Süresi (L40S) | $0,00117 GPU saniyesi başına |
- Çalıştırmanın gerçekten aldığı GPU süresi için faturalandırılır. Çalıştırma başladığında, bakiyenizden tipik fiyatın 3 katı ayrılır ve daha sonra kapatılır.
- 1 kredi = $0,01
Maliyet Hesaplayıcı
Fiyat hesaplayıcı
Sağlayıcıya göre tipik: yaklaşık 7,3 s
Toplam
$0,86
86 kredi
Çalışma başına
$0,0086 · 0,86 kredi
Gerçek GPU süresi faturalandırılır; bu bir tahmindir.
API
Doğrulanmış API örneği yok
Genel API, bu modelin ihtiyaç duyduğundan farklı bir giriş biçimi iletir. Yukarıdaki oyun alanını kullanın.
Özellikler
- Model Kimliği
deepseek-vl-7b- Geliştirici
- DeepSeek
- Kategori
- Multimodal
- Giriş
- Metin, Görüntü
- Çıkış
- Metin
- Bağlam penceresi
- 4.096 token
- Maks. çıkış
- 2.048 token
- Faturalandırma
- Kullanıma göre (token veya GPU süresi)
- Katalog girişi güncellendi
- 23 Eylül 2026
Etiketler
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Sık Sorulan Sorular
DeepSeek-VL 7B nedir?
DeepSeek-VL 7B, DeepSeek tarafından Multimodal kategorisinde oluşturulan bir modeldir.
DeepSeek-VL 7B Railwail'de ne kadar maliyetlidir?
Railwail üzerinde DeepSeek-VL 7B maliyeti ≈ $0,0086 çalıştırma başına. Her istek gerçekten ne kadar kullanırsa o kadar ücretlendirilirsiniz. Kullanım ön ödemeli kredilerden ödenir; 1 kredi $0,01 değerindedir.
DeepSeek-VL 7B'nin kontekst penceresi ne kadardır?
DeepSeek-VL 7B'nin kontekst penceresi 4.096 token içerir. Bir yanıt en fazla 2.048 token uzunluğunda olabilir.
DeepSeek-VL 7B ne kadar hızlıdır?
Railwail'de DeepSeek-VL 7B için henüz çalıştırma süresi belirtmek için yeterli ölçülen çalıştırma yoktur. Bu, giriş, ayarlar ve sağlayıcıdaki yüke bağlıdır.
DeepSeek-VL 7B, BLIP'dan daha iyi midir?
Bu göreve bağlıdır. DeepSeek-VL 7B (DeepSeek) ve BLIP (Salesforce) her ikisi de Multimodal kategorisinde modellerdir. Karşılaştırma sayfası fiyatlarını ve özelliklerini yan yana gösterir.
DeepSeek-VL 7B ve BLIP'ı karşılaştırDeepSeek-VL 7B görüntüleri işleyebilir mi?
Evet. DeepSeek-VL 7B metne ek olarak giriş olarak görüntüleri kabul eder.
Karşılaştırılabilir modeller
Bu kategorideki tümü- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Tüm Modeller Tek Bir API Aracılığıyla
Railwail'deki her model için bir API anahtarı. Kullanım, ön ödemeli kredilerden tahsil edilir, 1 kredi = $0,01.