
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Fiyat
- ≈ $0,0012/çalıştırma
- Giriş → Çıkış
- Metin + Görüntü → Metin
- Geliştirici
- Community
- Güncellendi
- 23 Eylül 2026
Playground
Florence-2 Large'ı deneyin
Giriş & Sonuç
Bu çalıştırma
yaklaşık $0,0012 · 0,12 kredi
Başlangıçta $0,0036 (0,36 kredi) ayrılır; gerçek GPU süresi faturalandırılır.
Yeni misiniz?
Google ile kaydolduğunuzda 10 ücretsiz kredi ($0,10)
Kaydolduktan 24 saat sonra kullanılabilir, günde 5 çalıştırmaya kadar ve çalıştırma başına en fazla 2 kredi. Diğer oturum açma yöntemleri kredi olmadan başlar. Bu model için 27 çalıştırma yeterli.
Examples
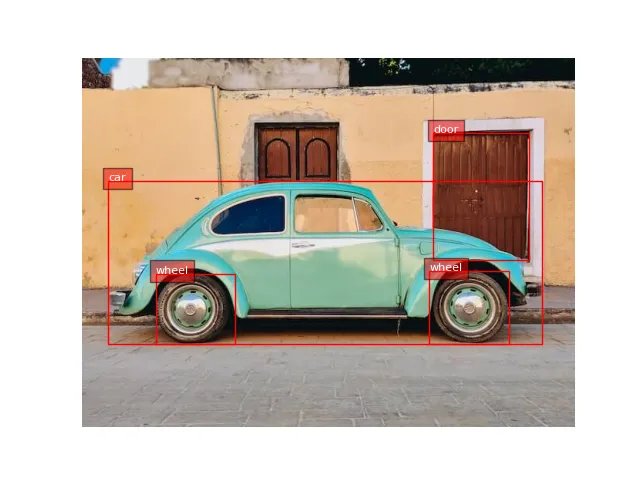 Open full size
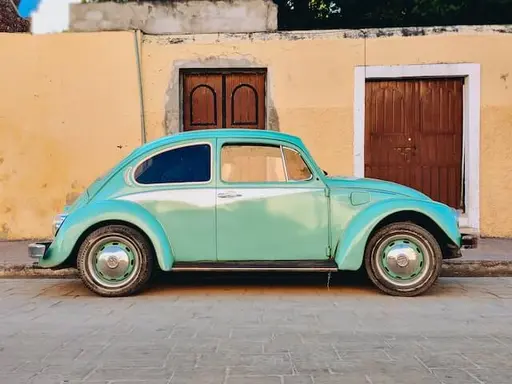 Input
No text prompt: the model only takes the input shown.
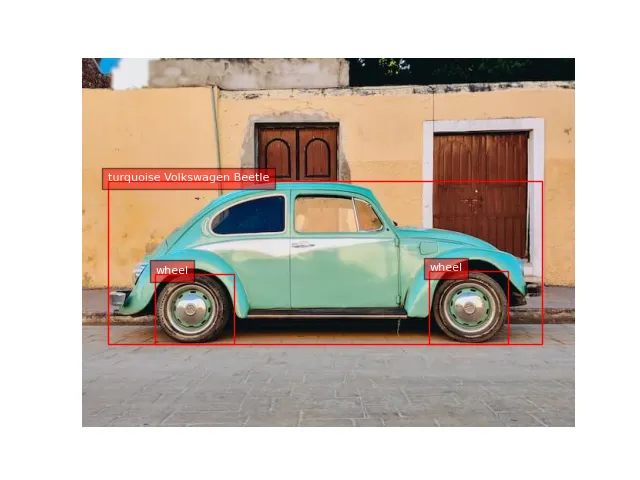 Open full size
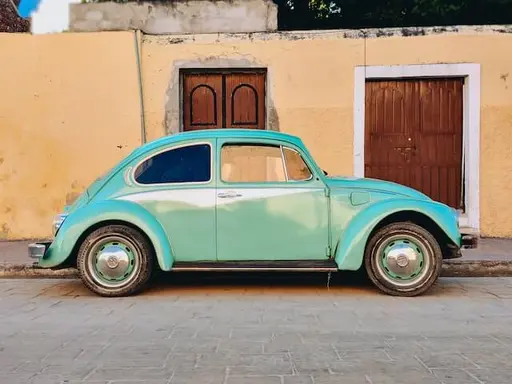 Input
No text prompt: the model only takes the input shown.
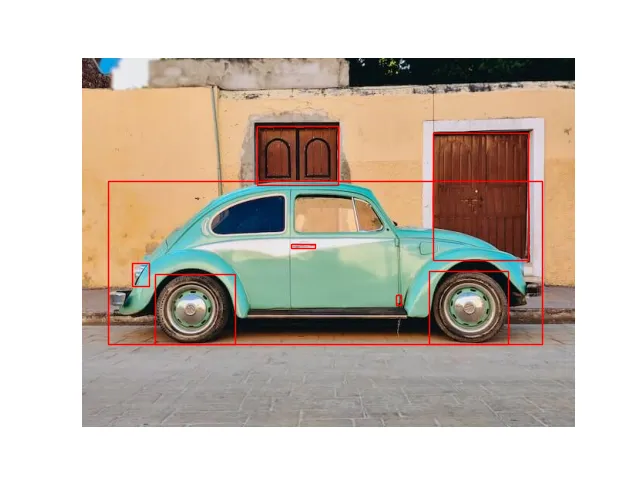 Open full size
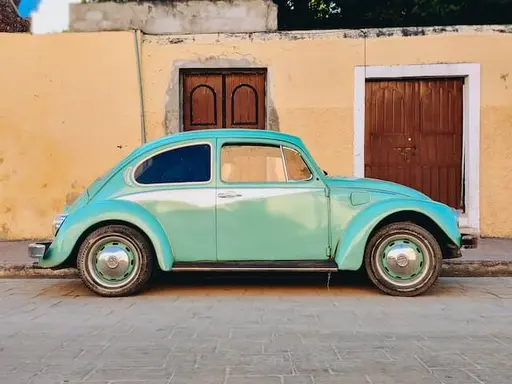 Input
No text prompt: the model only takes the input shown.
Florence-2 Large Hakkında
Florence-2 Large, Community tarafından Multimodal kategorisinde geliştirilen bir modeldir. Railwail üzerinde Florence-2 Large maliyeti ≈ $0,0012 çalıştırma başına.
Fiyatlandırma
| Tipik çalıştırma (≈ 1 s, L40S üzerinde) | $0,0012 çalıştırma başına |
|---|---|
| GPU Süresi (L40S) | $0,00117 GPU saniyesi başına |
- Çalıştırmanın gerçekten aldığı GPU süresi için faturalandırılır. Çalıştırma başladığında, bakiyenizden tipik fiyatın 3 katı ayrılır ve daha sonra kapatılır.
- 1 kredi = $0,01
Maliyet Hesaplayıcı
Fiyat hesaplayıcı
Sağlayıcıya göre tipik: yaklaşık 1 s
Toplam
$0,12
12 kredi
Çalışma başına
$0,0012 · 0,12 kredi
Gerçek GPU süresi faturalandırılır; bu bir tahmindir.
API
Doğrulanmış API örneği yok
Genel API, bu modelin ihtiyaç duyduğundan farklı bir giriş biçimi iletir. Yukarıdaki oyun alanını kullanın.
Özellikler
- Model Kimliği
florence-2-large- Geliştirici
- Community
- Kategori
- Multimodal
- Giriş
- Metin, Görüntü
- Çıkış
- Metin
- Faturalandırma
- Kullanıma göre (token veya GPU süresi)
- Katalog girişi güncellendi
- 23 Eylül 2026
Giriş Parametreleri
Modelin giriş şemasından giriş ve ayarlar. API bölümündeki örnek, API'nin hangilerini kabul ettiğini gösterir.
promptgerekliUser message or task instruction
Tür: MetinVarsayılan: –İzin verilen değerler: en fazla 4.000 karaktertaskTür: SeçimVarsayılan:captionİzin verilen değerler: caption, detailed_caption, ocr, object_detection veya segmentationimage_urlImage URL to analyze
Tür: MetinVarsayılan: –İzin verilen değerler: –max_tokensTür: Tam sayıVarsayılan:1024İzin verilen değerler: 1 ile 4.096 arasındatemperatureTür: SayıVarsayılan:0.7İzin verilen değerler: 0 ile 2 arasında
Etiketler
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Sık Sorulan Sorular
Florence-2 Large nedir?
Florence-2 Large, Community tarafından Multimodal kategorisinde oluşturulan bir modeldir.
Florence-2 Large Railwail'de ne kadar maliyetlidir?
Railwail üzerinde Florence-2 Large maliyeti ≈ $0,0012 çalıştırma başına. Her istek gerçekten ne kadar kullanırsa o kadar ücretlendirilirsiniz. Kullanım ön ödemeli kredilerden ödenir; 1 kredi $0,01 değerindedir.
Florence-2 Large hangi ayarları destekler?
Giriş şemasına göre Florence-2 Large şu parametreleri bilir: prompt (en fazla 4.000 karakter), task (caption, detailed_caption, ocr, object_detection veya segmentation), image_url, max_tokens (1 ile 4.096 arasında) ve temperature (0 ile 2 arasında).
Florence-2 Large ne kadar hızlıdır?
Railwail'de Florence-2 Large için henüz çalıştırma süresi belirtmek için yeterli ölçülen çalıştırma yoktur. Bu, giriş, ayarlar ve sağlayıcıdaki yüke bağlıdır.
Florence-2 Large, BLIP'dan daha iyi midir?
Bu göreve bağlıdır. Florence-2 Large (Community) ve BLIP (Salesforce) her ikisi de Multimodal kategorisinde modellerdir. Karşılaştırma sayfası fiyatlarını ve özelliklerini yan yana gösterir.
Florence-2 Large ve BLIP'ı karşılaştırFlorence-2 Large görüntüleri işleyebilir mi?
Evet. Florence-2 Large metne ek olarak giriş olarak görüntüleri kabul eder.
Karşılaştırılabilir modeller
Bu kategorideki tümü- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ $0,0457/çalıştırma
Birim başına 3.708 % daha pahalı
Florence-2 Large ve CLIP Interrogator karşılaştır - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Tüm Modeller Tek Bir API Aracılığıyla
Railwail'deki her model için bir API anahtarı. Kullanım, ön ödemeli kredilerden tahsil edilir, 1 kredi = $0,01.